 TokenSave
클로드 오퍼스 5 vs 5.5 차이: 가격·성능·실사용 후기
Jonhisking · 2026년 10월 9일
클로드 오퍼스 5.5(Opus 5.5)는 2026년 9월 22일에 나온 Anthropic의 새 상위 모델입니다. 직전 모델인 오퍼스 5(Opus 5)보다 토큰 단가는 20% 싸고, 캐시 읽기 가격은 60% 싸졌습니다. Anthropic은 "일반적인 작업에서 운영 비용이 40% 적다"고 밝혔는데, 저희가 코딩 에이전트 작업으로 직접 계산해 보니 약 37% 저렴했습니다. 같은 게임 제작 요청으로 직접 재 보니 오퍼스 5.5가 토큰을 64% 적게 썼습니다. 가격, 성능, 실측 결과를 비교하고, Max 20x 요금제로 두 모델을 직접 써 본 후기와 함께 갈아탈 만한지 정리했습니다.
오퍼스 5 vs 5.5 가격 비교
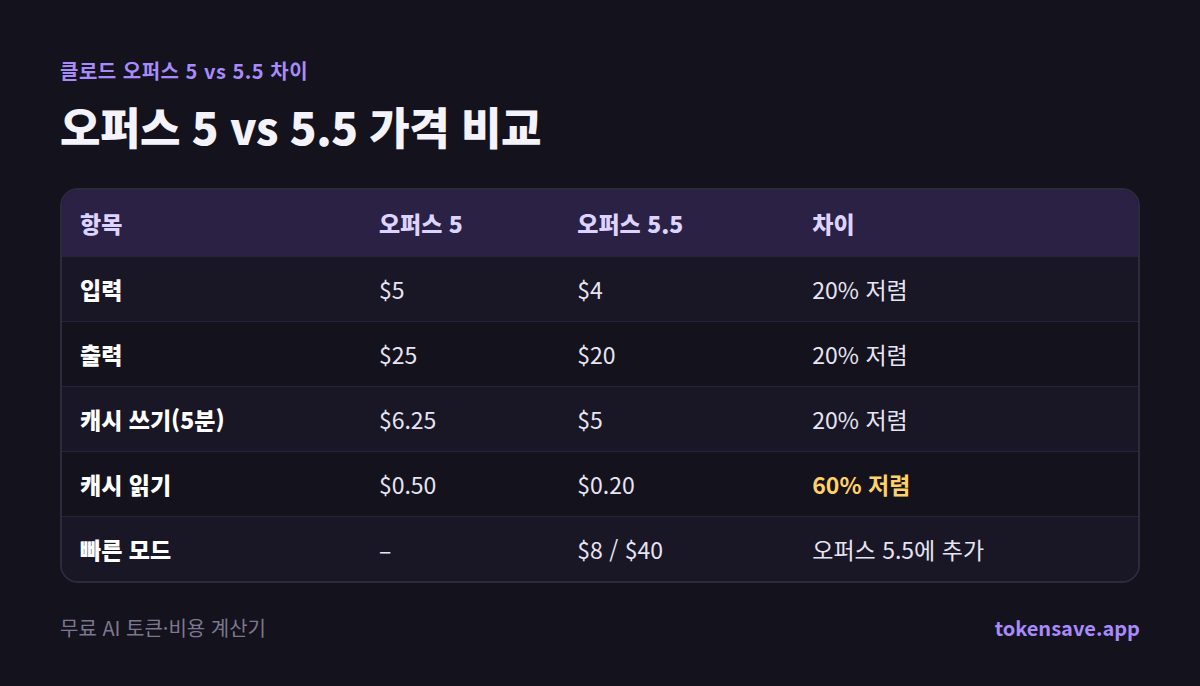
Anthropic 공식 가격 페이지 기준, 100만 토큰당 가격입니다.
| 항목 | 오퍼스 5 | 오퍼스 5.5 | 차이 |
|---|---|---|---|
| 입력 | $5 | $4 | 20% 저렴 |
| 출력 | $25 | $20 | 20% 저렴 |
| 캐시 쓰기(5분) | $6.25 | $5 | 20% 저렴 |
| 캐시 읽기 | $0.50 | $0.20 | 60% 저렴 |
| 빠른 모드 | – | $8 / $40 | 오퍼스 5.5에 추가 |
- 캐시 읽기가 가장 크게 내렸습니다. 오퍼스 5는 입력 가격의 10%였는데, 오퍼스 5.5는 5%입니다. 같은 문서나 대화를 반복해서 읽는 작업일수록 차이가 커집니다.
- 같은 글이면 토큰 수는 같습니다. 두 모델 모두 Claude 4.7 이후의 새 토크나이저를 써서, 같은 글을 넣으면 토큰 수가 같습니다. 그래서 단가 차이가 그대로 비용 차이가 됩니다. 다만 작업하면서 모델이 쓰는 토큰 양은 다를 수 있습니다(아래 실측 참고).
- 빠른 모드: 오퍼스 5.5에는 입력 $8, 출력 $40의 빠른 모드가 생겼습니다. 클로드 코드와 API에서 쓸 수 있고, Anthropic은 속도가 최대 150% 빨라진다고 밝혔습니다.
직접 써 본 후기: Max 20x 주간 한도가 남기 시작했다
저(재현)는 클로드 Max 20x 요금제로 게임을 만들면서 오퍼스 5와 오퍼스 5.5를 모두 써 봤습니다. 측정 장비로 잰 값이 아니라 실제로 쓰면서 느낀 내용입니다.
- 주간 한도: 오퍼스 5를 쓸 때는 주간 한도가 초기화되기 하루 전에 다 쓰는 정도였습니다. 오퍼스 5.5로 바꾼 뒤에는 한 주를 90% 정도 사용량으로 마치는 경우가 많았습니다.
- 외부 작업: 토큰을 많이 먹는 외부 작업을 시킬 때 차이가 가장 컸습니다. 써 본 모델 중 오퍼스 5.5가 토큰을 제일 적게 먹는 느낌이었습니다.
- 코딩 성능과 가성비: 코딩 작업에서는 페이블(Fable) 5.1만큼 성능이 나오는 느낌인데, 가성비는 훨씬 좋게 느껴졌습니다. 참고로 API 단가는 오퍼스 5.5(입력 $4, 출력 $20)가 페이블 5.1(입력 $10, 출력 $50)보다 60% 쌉니다.
위의 공식 가격과 아래 계산 결과도 같은 방향입니다. 같은 일을 더 적은 비용(=더 적은 한도)으로 처리하니, 같은 요금제에서 더 오래 쓸 수 있습니다.
같은 요청으로 직접 측정해 보니
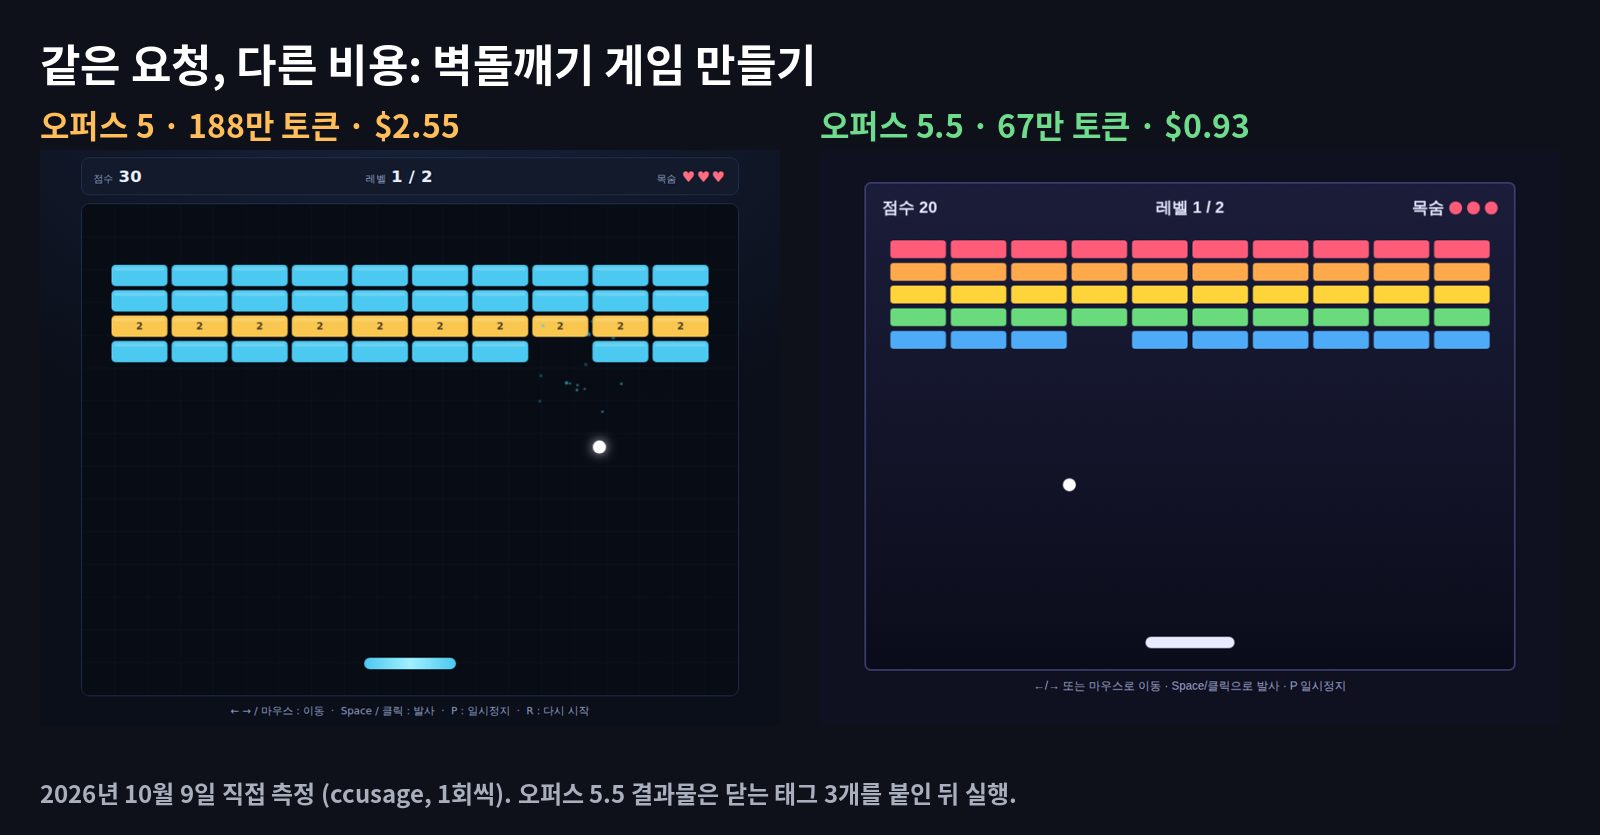
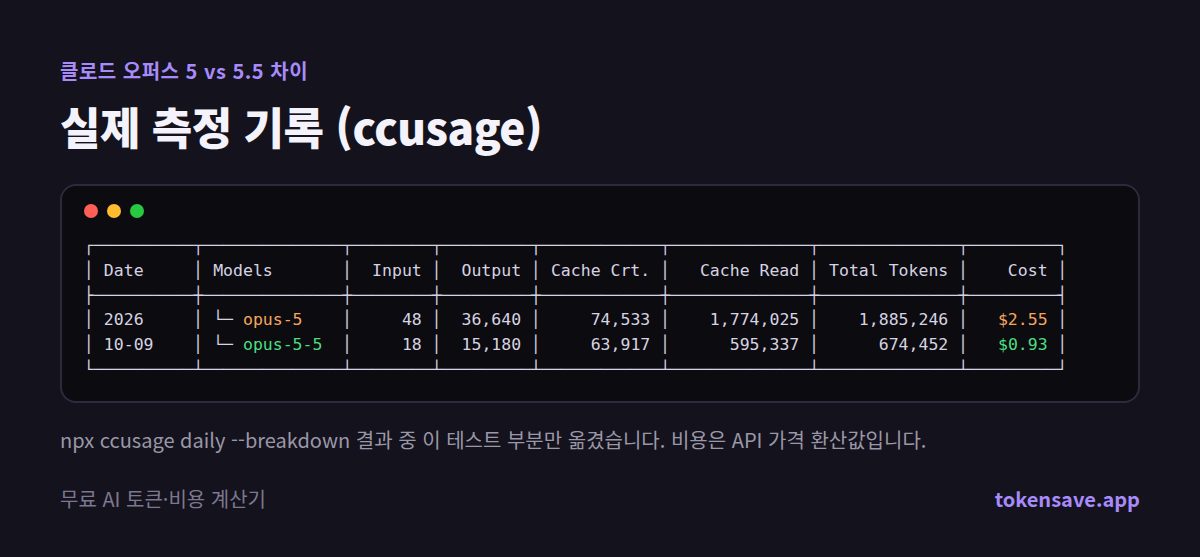
느낌만으로는 부족해서, 2026년 10월 9일에 클로드 코드로 두 모델에 똑같은 요청을 한 번씩 줬습니다(모델 이름만 바꾸고 나머지 설정은 그대로). 브라우저에서 돌아가는 벽돌깨기 게임(레벨 2개, 점수·목숨 표시)을 HTML 파일 하나로 만들어 달라는 요청이고, 사용량은 무료 도구 ccusage로 쟀습니다.
| 항목 | 오퍼스 5 | 오퍼스 5.5 | 차이 |
|---|---|---|---|
| 출력 토큰 | 36,640 | 15,180 | 59% 적음 |
| 캐시 쓰기 토큰 | 74,533 | 63,917 | 14% 적음 |
| 캐시 읽기 토큰 | 1,774,025 | 595,337 | 66% 적음 |
| 전체 토큰 | 1,885,246 | 674,452 | 64% 적음 |
| 비용(API 가격 환산) | $2.55 | $0.93 | 64% 저렴 |
| 만든 게임 코드 | 약 684줄 | 409줄 | 40% 짧음 |
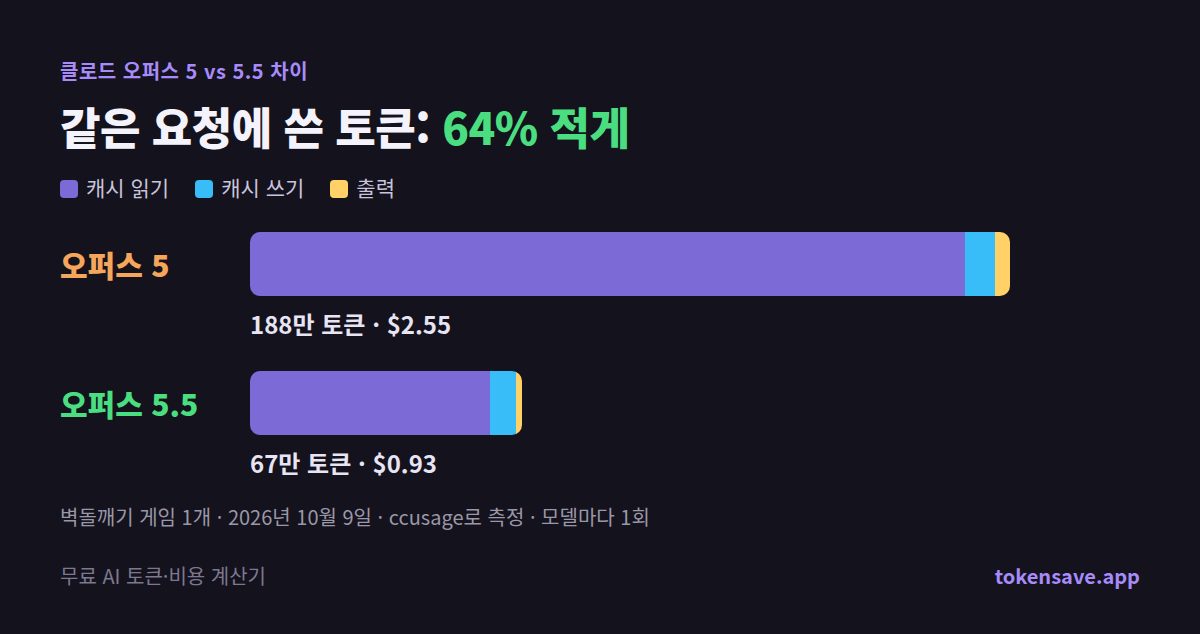
- 비용 차이가 단가 차이(20%)보다 훨씬 컸습니다. 오퍼스 5.5는 같은 요청을 처리하면서 토큰 자체를 64% 적게 썼습니다. 특히 앞의 대화를 다시 읽는 캐시 읽기가 66% 줄었습니다. Max 요금제에서 주간 한도가 남기 시작한 이유와 같은 방향입니다.
- 기능은 오퍼스 5가 더 많았습니다. 두 번 맞아야 깨지는 벽돌은 둘 다 넣었지만(오퍼스 5.5는 레벨 2부터), 오퍼스 5에는 파티클 효과, 언제든 다시 시작하는 R 키, 레벨 클리어 보너스, 벽돌에 남은 체력 숫자 표시가 더 있었습니다. 대신 화면은 제 눈에 오퍼스 5.5 쪽이 더 깔끔하고 보기 좋았습니다. 토큰이 적게 든 데는 기능 차이도 일부 있습니다.
- 오퍼스 5.5 파일은 끝부분이 빠져 있었습니다. 마지막 닫는 태그(
</script></body></html>)가 없어서 처음엔 빈 화면이 나왔고, 그 세 줄을 붙이자 정상적으로 플레이됐습니다. 오퍼스 5 파일은 바로 실행됐습니다. - 주의: 모델마다 한 번씩만 돌린 결과라, 다시 돌리면 숫자가 달라질 수 있습니다. 비용은 ccusage가 API 가격으로 환산한 값이고, 요금제 사용자는 실제로 이 돈을 내지 않고 한도에서 차감됩니다.
실제 작업 비용 비교
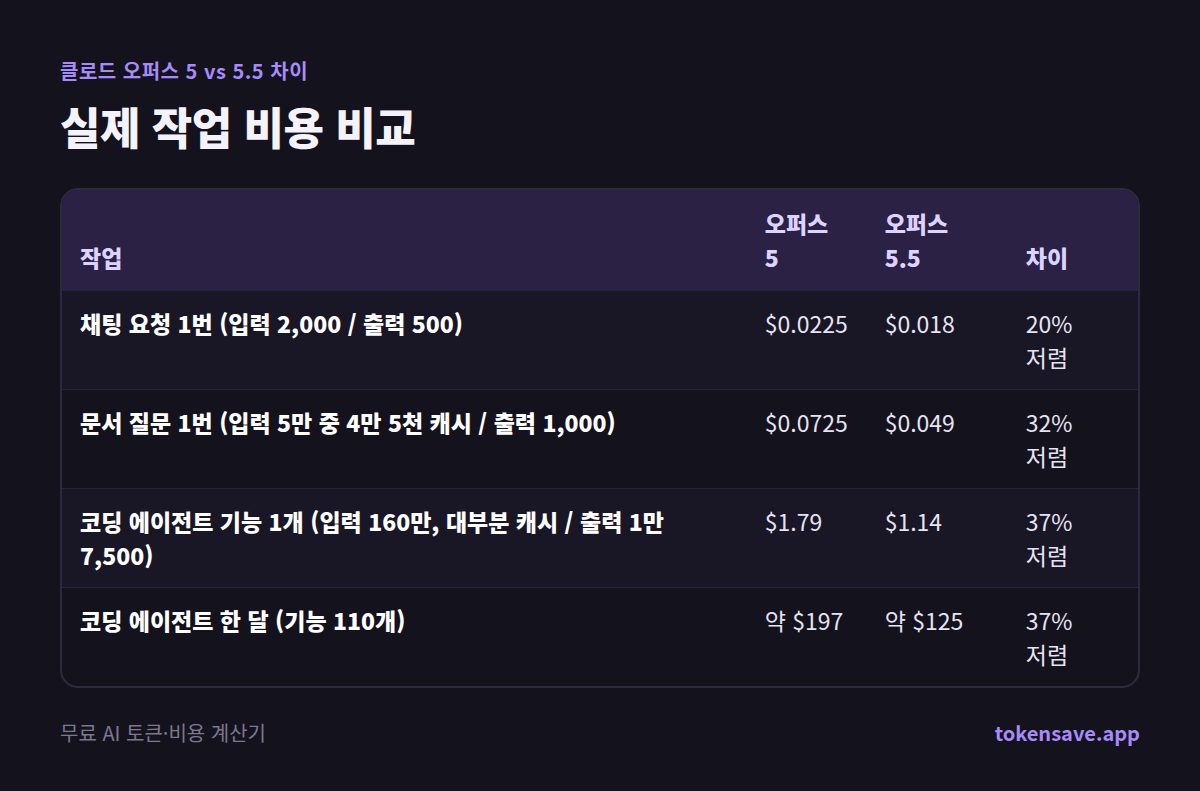
같은 작업을 두 모델로 돌렸을 때의 비용을 계산했습니다. 토큰 수는 두 모델이 같다고 보고, 가격만 바꿨습니다.
| 작업 | 오퍼스 5 | 오퍼스 5.5 | 차이 |
|---|---|---|---|
| 채팅 요청 1번 (입력 2,000 / 출력 500) | $0.0225 | $0.018 | 20% 저렴 |
| 문서 질문 1번 (입력 5만 중 4만 5천 캐시 / 출력 1,000) | $0.0725 | $0.049 | 32% 저렴 |
| 코딩 에이전트 기능 1개 (입력 160만, 대부분 캐시 / 출력 1만 7,500) | $1.79 | $1.14 | 37% 저렴 |
| 코딩 에이전트 한 달 (기능 110개) | 약 $197 | 약 $125 | 37% 저렴 |
계산 예: 오퍼스 5.5 문서 질문 = 새 입력 5,000 × $4 + 캐시 45,000 × $0.20 + 출력 1,000 × $20 (모두 100만 토큰당) = $0.049.
캐시를 많이 쓸수록 절감 폭이 커집니다. 단순 채팅은 20%만 싸지지만, 앞의 대화를 계속 다시 읽는 코딩 에이전트는 37% 가까이 싸집니다. 이 표는 토큰 수가 같다고 본 계산입니다. Anthropic은 "40% 절감"이 기본 설정에서 단가 인하와 작업당 토큰 감소를 합친 결과라고 밝혔고, 위 실측에서도 토큰이 64% 줄었습니다.
성능 비교 (Anthropic 발표 기준)
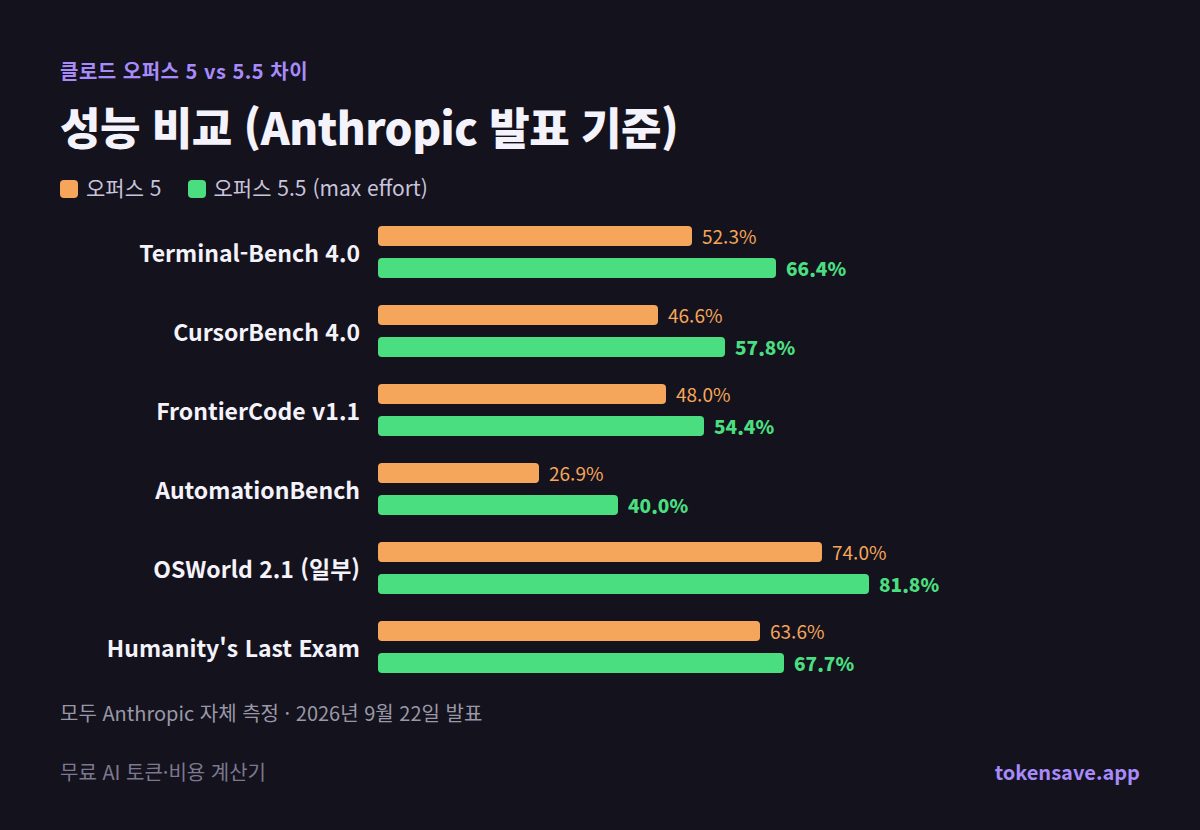
Anthropic이 공개한 벤치마크입니다. 오퍼스 5.5 점수는 최고 설정(max effort) 기준이고 Terminal-Bench 4.0만 한 단계 아래(xhigh) 기준이며, 모두 Anthropic 자체 측정입니다.
| 벤치마크 | 오퍼스 5 | 오퍼스 5.5 |
|---|---|---|
| Terminal-Bench 4.0 (터미널 작업) | 52.3% | 66.4% |
| CursorBench 4.0 (코딩) | 46.6% | 57.8% |
| FrontierCode v1.1 (코딩) | 48.0% | 54.4% |
| AutomationBench (업무 자동화) | 26.9% | 40.0% |
| OSWorld 2.1 (컴퓨터 사용, 일부) | 74.0% | 81.8% |
| Humanity's Last Exam (도구 사용) | 63.6% | 67.7% |
- 코딩과 에이전트 작업에서 차이가 큽니다. 터미널 작업은 14.1점, 업무 자동화는 13.1점 올랐습니다.
- 속도: Anthropic에 따르면 출력 생성 속도가 오퍼스 5보다 30% 넘게 빠릅니다.
- 주의: 회사가 직접 잰 점수라서, 내 작업에서도 같은 차이가 나는지는 직접 시험해 봐야 합니다.
독립 평가: Artificial Analysis
회사 밖에서 잰 점수도 있습니다. 독립 평가 기관 Artificial Analysis의 종합 지능 지수(Intelligence Index)에서 오퍼스 5.5(최고 설정)는 58점으로 1위에 올랐습니다(보도 기준).
| 모델 | Intelligence Index |
|---|---|
| 클로드 오퍼스 5.5 (max effort) | 58 |
| GPT-6 Astra | 53 |
| 클로드 페이블 5.1 | 53 |
| 클로드 오퍼스 5 | 51 |
- 독립 평가에서도 오퍼스 5.5가 앞섰습니다. 오퍼스 5보다 7점 높습니다.
- 대신 토큰을 더 썼습니다. 같은 평가에서 작업 하나에 쓴 출력 토큰은 오퍼스 5.5(최고 설정)가 약 11만 9천, 오퍼스 5가 약 7만 3천으로, 오퍼스 5.5가 63% 많았습니다. 이유는 바로 아래에서 설명합니다.
설정(effort)에 따라 절감 폭이 달라집니다
- 기본 설정이 바뀌었습니다. Anthropic 이전 가이드에 따르면 effort를 지정하지 않으면 오퍼스 5는 high, 오퍼스 5.5는 medium으로 돌아갑니다. "40% 절감"은 이 기본 설정 기준입니다.
- 최고 설정에서는 절감이 사라질 수 있습니다. Artificial Analysis는 최고 설정의 오퍼스 5.5가 출력 토큰을 63% 더 쓰면서, 작업당 비용은 오퍼스 5와 비슷했다고 밝혔습니다(보도 기준).
- 저희 실측은 반대 방향이었습니다. 클로드 코드에서 모델 이름만 바꿔 돌렸더니 오퍼스 5.5가 토큰을 64% 적게 썼습니다. 설정과 작업에 따라 결과가 크게 달라진다는 뜻입니다.
- 추천: medium에서 시작하고, 품질이 부족한 작업만 high 이상으로 올리세요. xhigh·max를 쓸 때는 Anthropic 안내대로 max_tokens를 넉넉히(64k부터) 잡아야 합니다.
요금제(Pro·Max) 사용자에게는
- 구독 요금제에서는 토큰 단가가 아니라 한도가 중요합니다. Anthropic은 오퍼스 5.5 출시와 함께 Pro, Max, Team, 좌석형 Enterprise의 5시간 사용 한도를 늘리고, 나중에 쓸 수 있는 한도 초기화 기회도 준다고 밝혔습니다.
- 같은 일을 더 적은 비용으로 처리하는 모델이라, 같은 한도 안에서 더 많이 쓸 수 있을 가능성이 큽니다. 다만 Anthropic은 요금제별 정확한 한도 수치를 공개하지 않습니다.
장점과 단점
장점
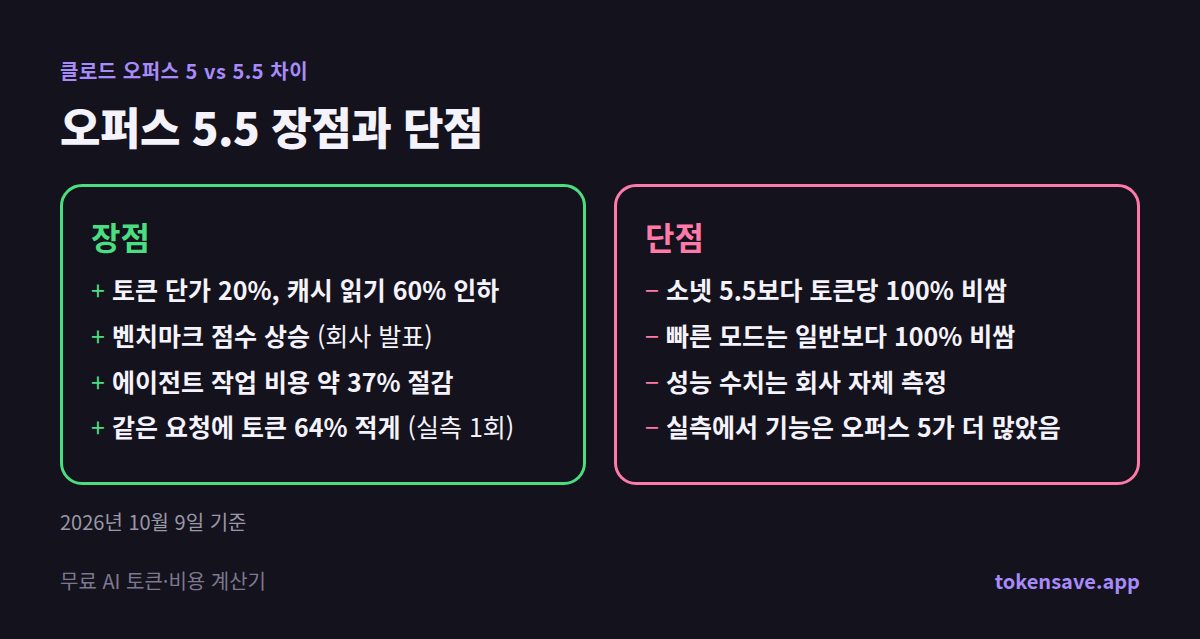
- 더 싸고 더 좋음: 토큰 단가 20%, 캐시 읽기 60% 인하와 함께 벤치마크 점수도 올랐습니다.
- 에이전트 작업에 특히 유리: 캐시를 많이 쓰는 코딩·자동화 작업에서 비용이 약 37% 줄어듭니다.
- 빠른 모드 선택 가능: 급할 때는 비용을 더 내고 속도를 높일 수 있습니다.
단점
- 여전히 비싼 모델: 소넷 5.5(입력 $2, 출력 $10)보다 토큰당 100% 비쌉니다. 간단한 작업은 소넷으로 충분합니다.
- 성능 수치는 대부분 회사 발표: 독립 평가(Artificial Analysis)에서도 1위였지만, 내 작업으로 확인이 필요합니다.
- 최고 설정에서는 절감이 줄어듦: 생각을 길게 해서 출력 토큰이 늘어납니다.
- 빠른 모드는 비쌈: 일반 모드보다 100% 비쌉니다.
API에서 옮길 때 바꿔야 할 것
Anthropic 이전 가이드 기준, 오퍼스 5용 코드를 그대로 쓰면 오류(400)가 나는 부분이 있습니다.
| 바뀐 점 | 오퍼스 5.5에서 할 일 |
|---|---|
생각(thinking)을 끌 수 없음: disabled, budget_tokens는 오류 |
thinking 설정을 빼고 effort로 조절 |
도구 강제 호출 불가: tool_choice의 any·tool은 오류 |
auto와 strict 도구 사용, 또는 구조화된 출력 |
옛 컴퓨터 사용 도구(computer_20251124)는 API·Google Cloud에서 오류 |
computer_toolset_20260801로 교체 |
| 대화 중간을 고친 뒤 thinking 블록을 다시 보내면 오류(2026년 8월 31일 이후 만든 계정) | 대화 기록은 뒤에 붙이기만 |
| 도구 호출 사이 안내 문구가 thinking 블록으로 이동 | 화면에 보여 줘야 하면 thinking.display 설정 |
거절(stop_reason: "refusal") 범위 확대 |
거절 처리와 대체 모델 설정 |
이 밖에 Priority Tier는 오퍼스 5.5에서 지원하지 않습니다. 클로드 코드나 요금제로 쓰는 경우에는 직접 고칠 코드가 없습니다.
오퍼스 5에서 갈아탈까
- API로 오퍼스 5를 쓰고 있다면: 갈아타는 게 좋습니다. 비용은 20~37% 줄고 성능은 올라갑니다. 다만 모델 이름만 바꾸면 끝이 아닙니다. 위의 변경점을 고치고 effort를 직접 지정한 뒤, 개발 환경에서 먼저 시험해 보세요.
- 클로드 코드로 큰 작업을 자주 돌린다면: 캐시 할인 효과가 가장 큰 경우라 이득이 큽니다.
- 소넷으로 충분한 작업이라면: 오퍼스 5.5로 올릴 필요는 없습니다. 어려운 설계·디버깅만 오퍼스에 맡기는 방식이 가장 경제적입니다.
자주 묻는 질문
오퍼스 5.5는 오퍼스 5보다 얼마나 싼가요? 토큰 단가는 20%, 캐시 읽기는 60% 쌉니다. 실제 작업 비용으로는 채팅 20%, 캐시를 많이 쓰는 코딩 에이전트 작업은 약 37% 저렴합니다.
토큰 수도 달라지나요? 같은 글을 넣으면 토큰 수는 같습니다(같은 토크나이저). 하지만 작업할 때 쓰는 토큰은 다릅니다. 저희 실측에서는 오퍼스 5.5가 64% 적게 썼고, 최고 설정에서는 반대로 더 많이 쓸 수 있습니다.
오퍼스 5.5와 소넷 5.5 중 뭘 써야 하나요? 대부분의 작업은 소넷 5.5로 충분하고 토큰당 가격도 절반 수준입니다. 어려운 코딩, 긴 에이전트 작업, 품질이 중요한 글에 오퍼스 5.5를 쓰세요.
오퍼스 5용 API 코드를 그대로 써도 되나요?
아니요. thinking 끄기, tool_choice 강제 호출 같은 설정은 오퍼스 5.5에서 오류가 납니다. 위의 "API에서 옮길 때 바꿔야 할 것"을 확인하세요.
내 작업으로 계산해 보기
코딩 에이전트 비용 계산기에서 작업 크기와 하루 작업 수를 넣으면 오퍼스 5.5, 소넷 5.5, GPT-6 Sol의 한 달 비용을 바로 비교할 수 있습니다. 프롬프트 하나의 비용은 토큰 계산기에서 확인하세요. 요금제와 API 중 무엇이 나은지는 클로드 코드 요금 한 달에 얼마?을 참고하세요.
2026년 10월 9일 기준. 가격은 바뀔 수 있으니 쓰기 전에 Anthropic 가격 페이지를 다시 확인하세요.
출처
- Anthropic: Claude Opus 5.5 발표 (2026년 9월 22일)
- Anthropic: Claude API 가격
- Anthropic: 프롬프트 캐싱 문서
- DataNorth: Claude Opus 5 출시 정리 (2026년 7월 24일)
- ccusage: 클로드 코드 사용량 측정 도구 (GitHub)
- Anthropic: 오퍼스 5에서 오퍼스 5.5로 옮기기 (이전 가이드)
- OfficeChai: Artificial Analysis 지능 지수 보도
다른 글
- 메타 Muse Spark 1.3 API 가격: Claude·GPT-6·Gemini와 비용 비교
- GPT-6.1 Sol 울트라패스트 가격·속도 정리
- GPT 프로 요금제 Pro 500·200·100 차이: 가격, 사용량, 고르는 법 (2026)
- 인디게임 개발 비용 얼마? 1인 개발 vs 외주, 엔진·스토어 등록비 정리 (2026)
- 챗GPT 무료 vs 유료 차이: 무료·Go·Plus·Pro 한도와 원화 가격 (2026)
작업 크기와 하루 작업 수를 넣고 오퍼스 5.5·소넷 5.5·GPT-6 Sol의 한 달 비용을 비교해 보세요.
코딩 에이전트 비용 계산기 열기 →