 TokenSave
클로드 하이쿠 vs 오퍼스 코딩 비교: 330회 실측
Jonhisking · 2026년 10월 25일
클로드 하이쿠와 오퍼스 중 코딩에 무엇을 쓸지는 클로드 코드를 쓰는 사람이면 매일 하는 고민입니다. 하이쿠 5.5는 API 가격이 오퍼스 5.5의 2.5%(입력 100만 토큰당 $0.10 대 $4, 프롬프트 10만 토큰 이하 기준)에 불과하지만, "싼 모델은 결국 실수가 많다"는 말도 자주 듣습니다. 클로드 하이쿠 오퍼스 비교 글은 많아도, 대부분은 회사가 발표한 벤치마크 점수를 옮겨 놓은 것이라 내 작업에서 어떨지는 알기 어렵습니다.
그래서 직접 돌려 봤습니다. 2026년 10월 23~24일, 윈도우 노트북 한 대에서 클로드 코드로 하이쿠 5.5, 소넷 5.5, 오퍼스 5.5를 모두 330번 실행했습니다. 명세대로 앱을 만드는 과제 63번, 마크다운 변환기 marked의 실제 버그 42번, 그리고 오픈소스 프로젝트에서 실제로 고쳐진 버그 25개를 모델마다 3번씩 고치게 한 225번입니다. 채점은 모델이 볼 수 없는 숨은 테스트와, 프로젝트 관리자들이 그 버그를 고치며 넣은 테스트로 했습니다.
이 글은 그 두 실측을 합쳐 "하이쿠로 충분한 일"과 "오퍼스가 필요한 일"을 나눠 봅니다. 숫자는 모두 공개한 데이터에서 그대로 가져왔습니다.
어떻게 쟀나
모든 실행은 같은 조건으로 했습니다.
- 클로드 코드 2.1.295를 헤드리스 모드(-p)로 실행했고, 생각 강도(effort)는 medium입니다.
- 실행마다 빈 폴더에서 시작했습니다. 패키지 설치와 인터넷은 막았습니다.
- 비용은 클로드 코드가 실행마다 알려 주는 API 정가 환산 금액입니다. 실제로는 구독 요금제로 돌렸습니다.
과제는 두 종류입니다.
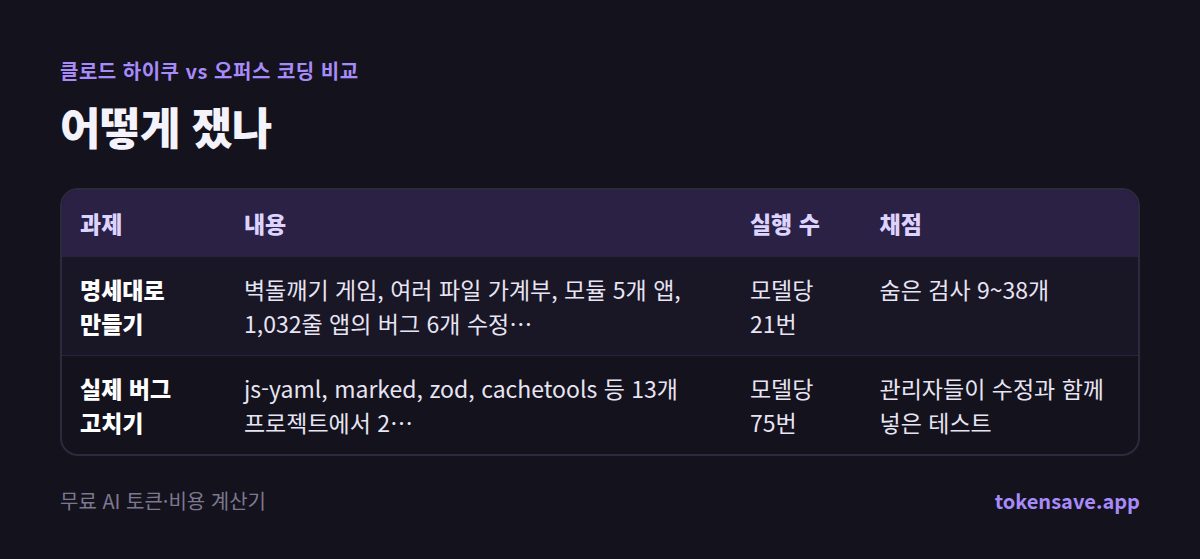
| 과제 | 내용 | 실행 수 | 채점 |
|---|---|---|---|
| 명세대로 만들기 | 벽돌깨기 게임, 여러 파일 가계부, 모듈 5개 앱, 1,032줄 앱의 버그 6개 수정과 기능 3개 추가, 스프레드시트 엔진 | 모델당 21번 | 숨은 검사 9~38개 |
| 실제 버그 고치기 | js-yaml, marked, zod, cachetools 등 13개 프로젝트에서 2026년 8~10월에 고쳐진 버그 25개 | 모델당 75번 | 관리자들이 수정과 함께 넣은 테스트 |
버그 과제는 수정 직전 코드에서 시작해, 사용자 신고문에서 원인 분석과 수정 제안을 지우고 증상만 남겨 줬습니다. 채점할 때는 모델이 고친 라이브러리 소스만 가져왔습니다. 모델이 테스트 파일을 고쳐서 통과시키는 꼼수는 통하지 않습니다.
결과 1: 명세가 분명하면 하이쿠도 만점
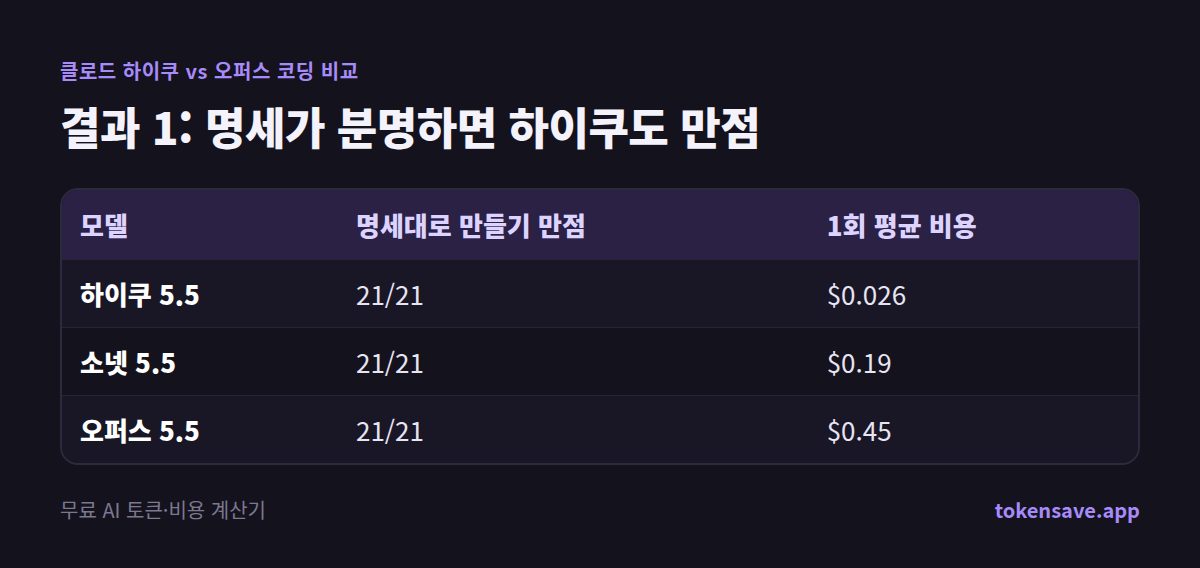
| 모델 | 명세대로 만들기 만점 | 1회 평균 비용 |
|---|---|---|
| 하이쿠 5.5 | 21/21 | $0.026 |
| 소넷 5.5 | 21/21 | $0.19 |
| 오퍼스 5.5 | 21/21 | $0.45 |
요구사항이 분명한 과제에서는 하이쿠가 한 번도 틀리지 않았습니다. 순환 참조를 감지하는 스프레드시트 엔진을 만들었고, 남이 짠 1,032줄 앱에서 증상만 보고 버그 6개를 찾아 고친 뒤 기능 3개를 넣으면서 기존 테스트 23개를 하나도 깨뜨리지 않았습니다. 비용은 오퍼스보다 1회당 약 94% 적었습니다.
결과 2: 실제 버그 25개에서도 거의 같았다
"깔끔한 수정"은 관리자의 테스트 사례를 모두 통과하고, 다른 테스트는 하나도 깨뜨리지 않은 경우입니다.
| 모델 | 깔끔한 수정 (쉬운 버그 15개) | 깔끔한 수정 (어려운 버그 10개) | 전체 | 1회 비용 |
|---|---|---|---|---|
| 하이쿠 5.5 | 40/45 | 12/30 | 52/75 | $0.019 |
| 소넷 5.5 | 35/45 | 14/30 | 49/75 | $0.14 |
| 오퍼스 5.5 | 38/45 | 16/30 | 54/75 | $0.38 |
전체로 보면 하이쿠와 오퍼스는 75번 중 52번과 54번으로 거의 같았고, 비용은 하이쿠가 약 95% 적었습니다. 버그 25개 가운데 22개는 두 모델의 깔끔한 수정 횟수가 똑같았습니다. 75번을 모두 돌린 비용은 하이쿠 $1.41, 오퍼스 $28.53입니다.
쉬운 버그는 원인과 증상이 가까이 있는 경우입니다. 예를 들어 "PapaParse가 빈 칸에서 멈춘다", "humanize가 유효숫자를 하나 더 보여 준다" 같은 것입니다. 어려운 버그는 신고문에 증상만 있고, 원인은 다른 파일이나 여러 곳에 퍼져 있는 경우가 많습니다.
오퍼스가 이긴 곳: 여러 곳을 고쳐야 할 때
어려운 버그에서는 오퍼스가 조금 앞섰습니다. 차이는 주로 "다른 테스트를 덜 깨뜨린 것"에서 나왔습니다.
| 어려운 버그 10개 | 하이쿠 5.5 | 소넷 5.5 | 오퍼스 5.5 |
|---|---|---|---|
| 깔끔한 수정 | 12/30 | 14/30 | 16/30 |
| 다른 테스트를 깨뜨린 실행 | 10 | 7 | 5 |
| 통과한 테스트 사례 | 72% | 69% | 82% |
구체적으로는 이런 버그였습니다.
- marked, 링크 텍스트 안의 링크: 오퍼스는 3번 중 2번 깔끔하게 고쳤고, 하이쿠는 0번이었습니다. 하이쿠는 3번 모두 바로 그 예시의 스펙 테스트를 깨뜨렸습니다.
- markdown-it, 닫히지 않은 링크 괄호가 코드 구간을 가리는 버그: 오퍼스 3번, 하이쿠 1번입니다. 하이쿠 2번은 버그는 고쳤지만 옆의 테스트 2개를 깨뜨렸습니다.
- zod, 숫자 키 레코드를 JSON Schema로 바꾸는 버그: 여러 곳을 함께 고쳐야 해서 완전히 고친 실행은 없었습니다. 그래도 3번 합계로 테스트 사례 24개 중 오퍼스 14개, 하이쿠 9개, 소넷 5개를 통과했습니다.
반대로 하이쿠가 이긴 버그도 있었습니다. js-yaml에서 공백만 있는 블록 스칼라를 처리하는 버그는 하이쿠가 3번 중 3번, 오퍼스는 1번, 소넷은 0번 깔끔하게 고쳤습니다.
어떤 모델도 못 한 것: 신고문에 없는 경우
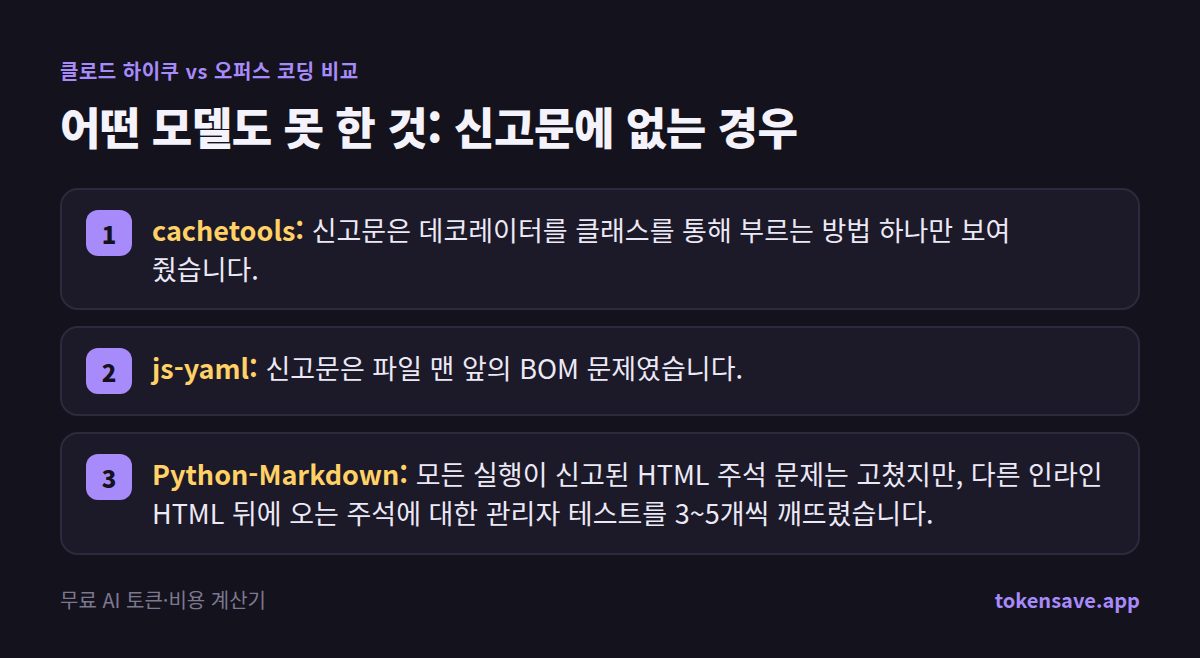
이번 실측에서 가장 쓸모 있는 결과는 모델끼리의 차이가 아니라, 세 모델이 똑같이 막힌 곳이었습니다.
- cachetools: 신고문은 데코레이터를 클래스를 통해 부르는 방법 하나만 보여 줬습니다. 관리자들은 다른 변형까지 모두 테스트했는데, 이를 처리한 실행은 하나도 없었습니다.
- js-yaml: 신고문은 파일 맨 앞의 BOM 문제였습니다. 관리자들은 여러 문서가 이어진 스트림에서 문서마다 붙은 BOM도 테스트했고, 역시 처리한 실행이 없었습니다.
- Python-Markdown: 모든 실행이 신고된 HTML 주석 문제는 고쳤지만, 다른 인라인 HTML 뒤에 오는 주석에 대한 관리자 테스트를 3~5개씩 깨뜨렸습니다.
지난번 실측(marked의 어려운 버그 하나)에서는 소넷과 오퍼스가 이런 빠진 경우를 하이쿠보다 훨씬 자주 챙겼습니다. 소넷은 10번 중 8번, 오퍼스는 6번, 하이쿠는 1번이었습니다. 그런데 버그를 25개로 넓히자 이 패턴은 유지되지 않았습니다. 큰 모델에 돈을 더 내도 신고문이 빠뜨린 경우는 나오지 않았습니다.
이 차이는 믿을 만한가
조심해서 봐야 합니다. 버그마다 모델당 3번만 돌렸기 때문입니다.
- 하이쿠와 오퍼스의 깔끔한 수정 비율 차이는 피셔 정확 검정으로 p = 0.86입니다. 차이가 없다고 해도 이 정도는 흔히 나옵니다.
- 버그 단위로 다시 뽑아 계산한 95% 구간은 하이쿠에서 오퍼스를 뺀 값이 −11%p에서 +5%p입니다. 오퍼스가 더 잘 고친다는 증거는 없지만, 10%p 정도 차이까지 없다고 할 수는 없습니다.
- 어려운 버그만 보면 구간이 −33%p에서 0%p입니다. 이런 버그에서는 오퍼스가 실제로 나을 수 있습니다.
정리하면 "하이쿠와 오퍼스가 같다"가 아니라 "버그 25개로는 오퍼스가 낫다는 증거를 찾지 못했다"입니다. 같은 방법으로 버그를 계속 늘려 갈 계획입니다.
클로드 코드에서 모델 바꾸는 법
클로드 코드에서는 대화 중에 /model haiku, /model sonnet, /model opus로 바로 바꿀 수 있고, 시작할 때 claude --model haiku처럼 정할 수도 있습니다. opusplan을 고르면 계획 모드에서는 오퍼스, 실행할 때는 소넷을 씁니다. 하이쿠를 기본으로 두고, 다음 신호가 보일 때만 오퍼스로 올리는 방식을 추천합니다. 이번 데이터에서 하이쿠가 무너진 경우는 모두 이 모양이었습니다.
- 수정이 여러 파일이나 함수에 걸칠 때: zod처럼 한 곳을 고치면 다른 곳도 같이 고쳐야 하는 버그.
- 하이쿠의 수정으로 기존 테스트가 깨졌을 때: marked나 markdown-it처럼 고쳤다고 생각했는데 옆의 동작을 망가뜨린 경우. 어려운 버그에서 하이쿠는 30번 중 10번이 그랬습니다.
- 코드베이스가 크고 망가뜨렸을 때 되돌리기 어려울 때: 검토 시간까지 생각하면 1회 수백 원 차이보다 안 깨뜨리는 쪽이 쌉니다.
반대로 신고문에 없는 경계 사례는 어떤 모델도 찾지 못했으니, 그 부분은 모델을 올리기보다 직접 예시를 더해서 요청하는 편이 확실합니다.
내 사용량으로 한 달 비용이 얼마나 될지는 코딩 에이전트 비용 계산기에서 작업 수와 크기를 넣어 비교해 볼 수 있습니다.
자주 묻는 질문
하이쿠로 코딩해도 되나요? 요구사항이 분명한 일, 원인이 증상 가까이에 있는 버그라면 됩니다. 이번 실측에서 명세대로 만들기 21번은 모두 만점이었고, 쉬운 버그 45번 중 40번을 깔끔하게 고쳤습니다.
오퍼스는 언제 써야 하나요? 여러 파일이나 여러 곳을 함께 고쳐야 하는 버그, 기존 테스트를 깨뜨리면 안 되는 큰 코드베이스에서 씁니다. 어려운 버그에서 다른 테스트를 깨뜨린 실행이 오퍼스 5번, 하이쿠 10번이었습니다.
소넷은 어떤가요? 이번 버그 실측에서는 소넷이 하이쿠보다 낫지 않았습니다. 전체 테스트 사례 통과율도 오퍼스보다 낮았습니다(짝지은 순열 검정 p = 0.006). 소넷과 오퍼스의 자세한 비교는 소넷 5.5 vs 오퍼스 5.5 실측에 있습니다.
테스트를 돌리게 하면 하이쿠도 나아지나요? 이번 버그 실측은 모든 실행이 프로젝트 테스트를 돌릴 수 있었습니다. 그래도 신고문에 없는 경우는 어떤 모델도 찾지 못했습니다.
결론: 하이쿠를 기본으로, 오퍼스는 골라서
- 명세가 분명한 일과 원인이 가까운 버그는 하이쿠로 충분합니다. 결과가 오퍼스와 같았고, 비용은 약 95% 적었습니다.
- 여러 곳을 고쳐야 하는 버그는 오퍼스가 더 안전합니다. 다른 테스트를 깨뜨린 실행이 하이쿠의 절반이었습니다.
- 신고문에 없는 경우는 모델이 찾아 주지 않습니다. 어려운 버그에서는 모델마다 실행의 47~60%가 깔끔한 수정이 아니었습니다. 어떤 모델을 쓰든 경계 사례 검토는 사람이 해야 합니다.
원자료(실행별 점수, 실패한 테스트, 시간, 비용)는 모두 CC BY 4.0으로 공개했습니다: 실제 버그 25개 데이터, 명세 과제와 marked 버그 데이터.
출처
- Claude 요금 (Anthropic, 2026년 10월 25일 확인)
- Claude Code 모델 설정 문서
- 실측 데이터: 실제 버그 25개, 225회 (DOI 10.5281/zenodo.23619927)
- 실측 데이터: 코딩 과제 6단계, 163회 (DOI 10.5281/zenodo.23600477)
다른 글
- 클로드 코드 캐시 1시간: 쉬고 오면 507% 비싸진다
- 클로드 사용량 한도 2026: 5시간·주간 초기화 정리
- 클로드 한국어 토큰, 영어보다 102% 더? 실측 비교
- Veo 3.1 가격과 무료 사용법: Flow 하루 50크레딧 실측
- Claude Code·Codex·Cursor 사용량 확인법과 실제 비용
하루 작업 수와 크기를 넣고 클로드 코드의 API 비용을 Pro·Max와 비교해 보세요.
코딩 에이전트 비용 계산기 열기 →