 TokenSave
Claude Haiku vs Opus コーディング比較:330回実測
Jonhisking · 2026年10月25日
Claude Haiku と Opus のどちらでコーディングするかは、Claude Code を使う人が毎日のように迷うところです。Haiku 5.5 の API 料金は Opus 5.5 の2.5%(入力100万トークンあたり約16円($0.10)対 約640円($4)、プロンプト10万トークン以下の場合)ですが、「安いモデルは結局ミスが多い」という声もよく聞きます。Claude Haiku と Opus の比較記事は多いものの、ほとんどは各社が発表したベンチマークの数字を並べたもので、自分の作業でどうなるかはわかりません。
そこで実際に動かしてみました。2026年10月23〜24日、Windows ノートパソコン1台で、Claude Code から Haiku 5.5、Sonnet 5.5、Opus 5.5 を合計330回実行しました。仕様どおりにアプリを作る課題が63回、Markdown パーサー marked の実際のバグが42回、そしてオープンソースで2026年8〜10月に実際に修正されたバグ25件を、モデルごとに3回ずつ直させた225回です。採点はモデルから見えない隠しテストと、メンテナーがそのバグの修正と一緒に入れたテストで行いました。
この記事では2つの実測をまとめて、「Haiku で十分な仕事」と「Opus が必要な仕事」を分けてみます。数字はすべて公開したデータからそのまま引いています。円は1ドル=160円で換算しました。
測定方法
すべての実行を同じ条件で行いました。
- Claude Code 2.1.295 をヘッドレスモード(-p)で実行し、思考の強さ(effort)は medium です。
- 実行ごとに空のフォルダから始め、パッケージのインストールとネットワークは禁止しました。
- コストは Claude Code が実行ごとに出す API 定価換算の金額です。実際にはサブスクリプションで実行しました。
課題は2種類です。
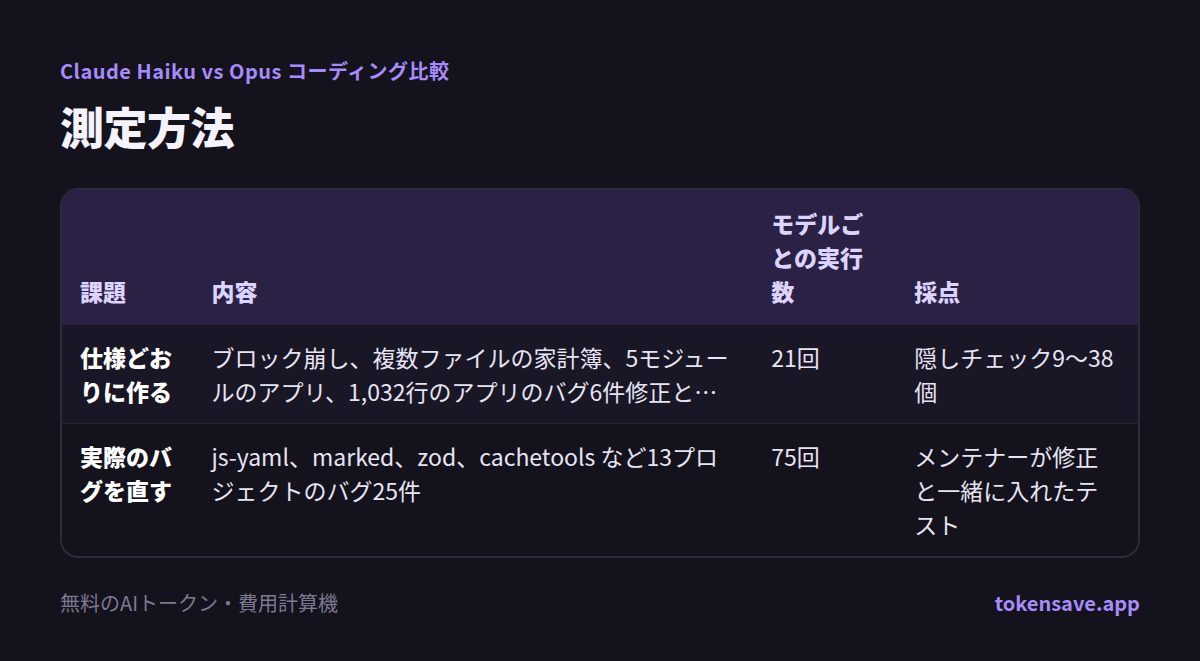
| 課題 | 内容 | モデルごとの実行数 | 採点 |
|---|---|---|---|
| 仕様どおりに作る | ブロック崩し、複数ファイルの家計簿、5モジュールのアプリ、1,032行のアプリのバグ6件修正と機能3件追加、スプレッドシートエンジン | 21回 | 隠しチェック9〜38個 |
| 実際のバグを直す | js-yaml、marked、zod、cachetools など13プロジェクトのバグ25件 | 75回 | メンテナーが修正と一緒に入れたテスト |
バグの課題は修正直前のコードから始め、ユーザーの報告から原因の分析と修正案を消して、症状だけを渡しました。採点ではモデルが直したライブラリのソースだけを取り出したので、テストファイルを書き換えて通すことはできません。
結果1:仕様がはっきりしていれば Haiku も満点
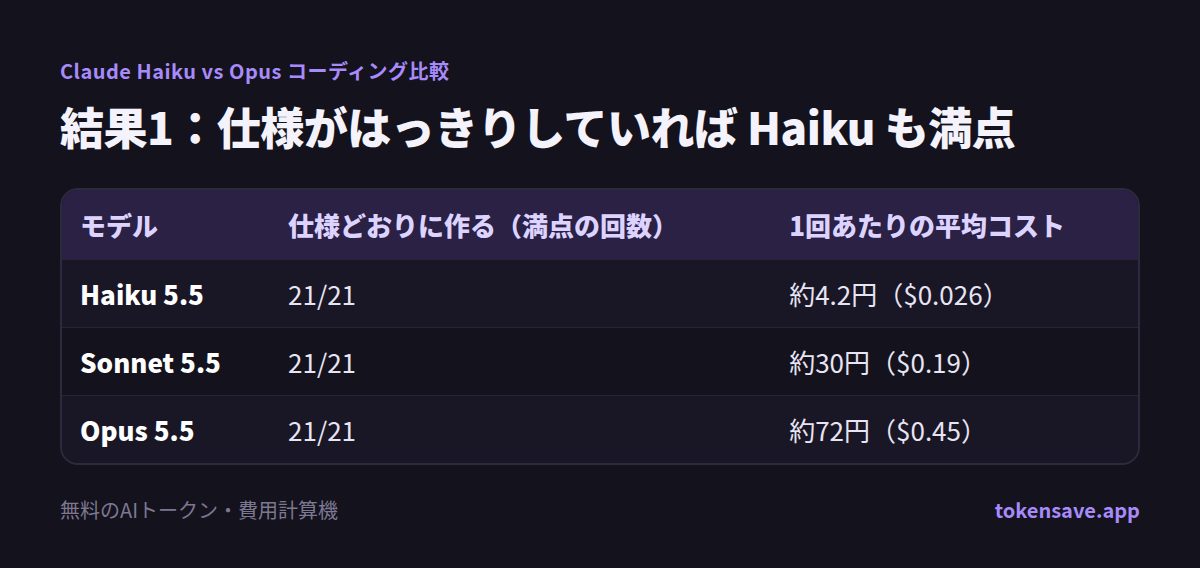
| モデル | 仕様どおりに作る(満点の回数) | 1回あたりの平均コスト |
|---|---|---|
| Haiku 5.5 | 21/21 | 約4.2円($0.026) |
| Sonnet 5.5 | 21/21 | 約30円($0.19) |
| Opus 5.5 | 21/21 | 約72円($0.45) |
要件がはっきりした課題では、Haiku は一度も失敗しませんでした。循環参照を検出するスプレッドシートエンジンを作り、他人が書いた1,032行のアプリでは症状だけからバグ6件を見つけて直し、機能を3つ足しながら既存のテスト23個を1つも壊しませんでした。コストは Opus より1回あたり約94%少なく済みました。
結果2:実際のバグ25件でもほぼ同じ
「きれいな修正」とは、メンテナーのテストケースをすべて通し、他のテストを1つも壊さなかった場合です。
| モデル | きれいな修正(易しいバグ15件) | きれいな修正(難しいバグ10件) | 全体 | 1回あたりのコスト |
|---|---|---|---|---|
| Haiku 5.5 | 40/45 | 12/30 | 52/75 | 約3円($0.019) |
| Sonnet 5.5 | 35/45 | 14/30 | 49/75 | 約22円($0.14) |
| Opus 5.5 | 38/45 | 16/30 | 54/75 | 約61円($0.38) |
全体では Haiku と Opus は75回中52回と54回でほぼ同じで、コストは Haiku のほうが約95%少なく済みました。25件のうち22件では、2つのモデルのきれいな修正の回数がまったく同じでした。75回すべての合計は Haiku が約226円($1.41)、Opus が約4,565円($28.53)です。
易しいバグは原因と症状が近いものです。たとえば「PapaParse が空のセルで止まる」「humanize が有効数字を1桁多く表示する」といったものです。難しいバグは報告に症状しかなく、原因が別のファイルや複数の場所にあることが多いものでした。
Opus が勝ったところ:複数箇所を直すバグ
難しいバグでは Opus が少し上回りました。差は主に「他のテストを壊す回数が少なかった」ことから来ています。
| 難しいバグ10件 | Haiku 5.5 | Sonnet 5.5 | Opus 5.5 |
|---|---|---|---|
| きれいな修正 | 12/30 | 14/30 | 16/30 |
| 他のテストを壊した実行 | 10 | 7 | 5 |
| 通過したテストケース | 72% | 69% | 82% |
具体的には次のようなバグでした。
- marked、リンクテキストの中のリンク: Opus は3回中2回きれいに直し、Haiku は0回でした。Haiku は3回とも、まさにその例のスペックテストを壊しました。
- markdown-it、閉じていないリンクの括弧がコードスパンを隠すバグ: Opus は3回中3回、Haiku は1回です。Haiku の2回はバグを直したものの、隣のテストを2つ壊しました。
- zod、数値キーのレコードを JSON Schema に変換するバグ: 複数箇所を直す必要があり、完全に直した実行はありませんでしたが、3回合計でテストケース24個中 Opus が14個、Haiku が9個、Sonnet が5個を通しました。
逆に Haiku が勝ったバグもありました。js-yaml の空白だけのブロックスカラーのバグは、Haiku が3回中3回、Opus が1回、Sonnet が0回きれいに直しました。
どのモデルもできなかったこと:報告にないケース
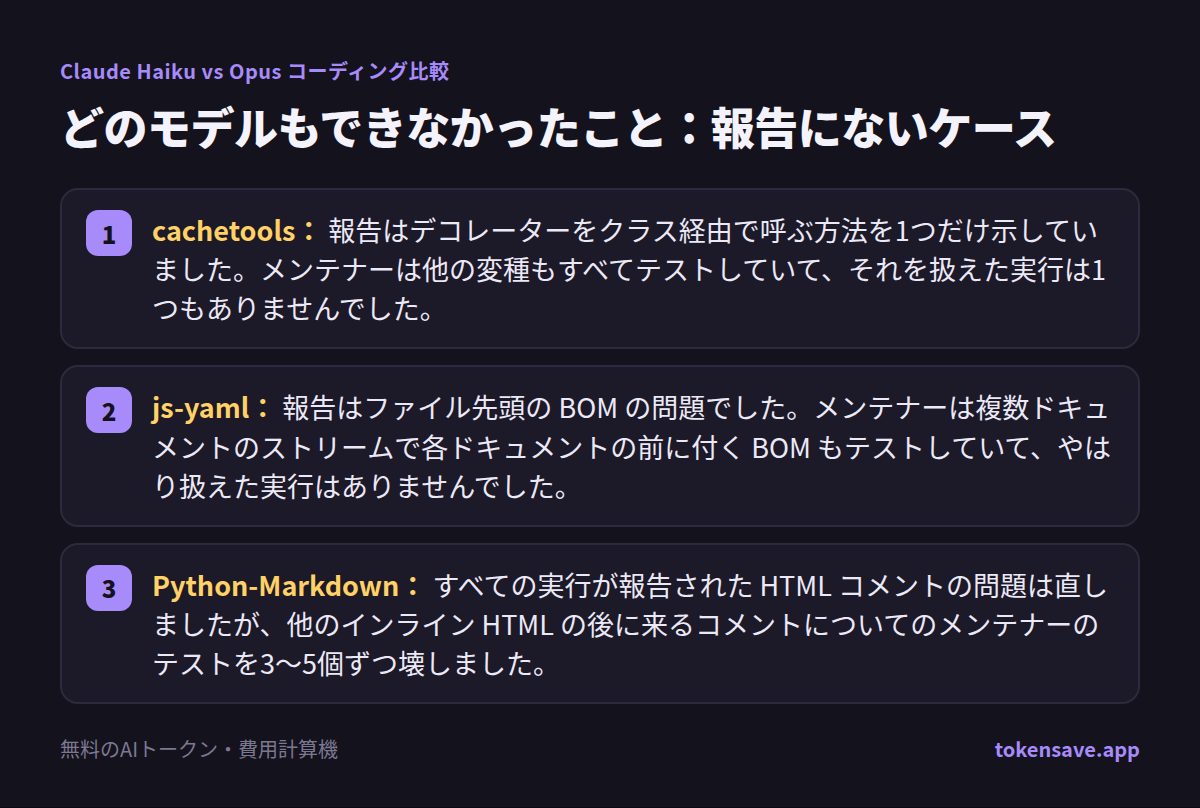
今回いちばん役に立つ結果は、モデル同士の差ではなく、3モデルがそろって止まった場所でした。
- cachetools: 報告はデコレーターをクラス経由で呼ぶ方法を1つだけ示していました。メンテナーは他の変種もすべてテストしていて、それを扱えた実行は1つもありませんでした。
- js-yaml: 報告はファイル先頭の BOM の問題でした。メンテナーは複数ドキュメントのストリームで各ドキュメントの前に付く BOM もテストしていて、やはり扱えた実行はありませんでした。
- Python-Markdown: すべての実行が報告された HTML コメントの問題は直しましたが、他のインライン HTML の後に来るコメントについてのメンテナーのテストを3〜5個ずつ壊しました。
前回の実測(marked の難しいバグ1件)では、Sonnet と Opus がこの種の抜けたケースを Haiku よりずっとよく拾いました。Sonnet は10回中8回、Opus は6回、Haiku は1回です。ところがバグを25件に広げると、この傾向は続きませんでした。大きいモデルにお金を払っても、報告から抜けたケースは出てきませんでした。
この差は信頼できるか
慎重に見る必要があります。バグとモデルごとに3回しか実行していないためです。
- Haiku と Opus のきれいな修正の割合の差は、フィッシャーの正確検定で p = 0.86 です。差がなくても普通に出る範囲です。
- バグ単位でリサンプリングした95%区間は、Haiku から Opus を引いた差が −11 から +5 ポイントです。Opus のほうがよく直すという証拠はありませんが、10ポイント程度の差まで否定はできません。
- 難しいバグだけだと区間は −33 から 0 ポイントで、この種のバグでは Opus が本当に上かもしれません。
正確に言えば「Haiku と Opus は同じ」ではなく、「バグ25件では Opus が上だという証拠は見つからなかった」です。同じ方法でバグを増やしていく予定です。
Claude Code でモデルを切り替える方法
Claude Code では会話中に /model haiku、/model sonnet、/model opus ですぐ切り替えられ、起動時に claude --model haiku のように指定することもできます。opusplan を選ぶと、計画モードでは Opus、実行では Sonnet を使います。Haiku を基本にして、次のようなサインが見えたときだけ Opus に上げる使い方をおすすめします。今回のデータで Haiku が崩れたのは、どれもこの形でした。
- 修正が複数のファイルや関数にまたがる: zod のように、1か所直すと別の場所も合わせて直す必要があるバグ。
- Haiku の修正で既存のテストが落ちた: marked や markdown-it のように、直したつもりで隣の動作を壊すケース。難しいバグで Haiku はこれが30回中10回ありました。
- 大きなコードベースで、壊したときの手戻りが大きい: レビューの手間を考えると、1回あたり数十円の差より壊さないことのほうが安く済みます。
逆に、どちらのモデルを使っても報告にない境界ケースは見つからなかったので、そこはモデルを上げるより、自分で例を足して頼むほうが確実です。
自分の使い方で月にいくらかかるかは、コーディングエージェント費用計算機にタスク数と大きさを入れて比べられます。
よくある質問
Claude Haiku でコーディングしても大丈夫? 要件がはっきりした作業や、原因が症状の近くにあるバグなら大丈夫です。今回の実測では、仕様どおりに作る課題21回はすべて満点で、易しいバグ45回のうち40回をきれいに直しました。
Opus はいつ使うべき? 複数のファイルや箇所をまとめて直す必要があるバグや、既存のテストを壊してはいけない大きなコードベースで使います。難しいバグで他のテストを壊した実行は、Opus が5回、Haiku が10回でした。
Sonnet はどう? 今回のバグの実測では、Sonnet は Haiku より良くありませんでした。全体のテストケース通過率も Opus より低い結果です(対応のある並べ替え検定 p = 0.006)。Sonnet と Opus の詳しい比較は Sonnet 5.5 vs Opus 5.5 の実測にあります。
テストを実行させれば Haiku も良くなる? 今回のバグの実測では、すべての実行がプロジェクトのテストを実行できました。それでも報告にないケースはどのモデルも見つけられませんでした。
まとめ:Haiku を基本に、Opus は選んで使う
- 仕様がはっきりした作業と、原因が近いバグは Haiku で十分です。 結果は Opus と同じで、コストは約95%少なく済みました。
- 複数箇所を直すバグは Opus のほうが安全です。 他のテストを壊した実行が Haiku の半分でした。
- 報告から抜けたケースはモデルが見つけてくれません。 難しいバグでは、どのモデルでも実行の47〜60%がきれいな修正ではありませんでした。どのモデルを使っても、境界ケースの確認は人がする必要があります。
生データ(実行ごとの点数、失敗したテスト、時間、コスト)はすべて CC BY 4.0 で公開しています:実際のバグ25件のデータ、仕様の課題と marked のバグのデータ。
出典
- Claude の料金(Anthropic、2026年10月25日確認)
- Claude Code のモデル設定ドキュメント
- 実測データ:実際のバグ25件、225回(DOI 10.5281/zenodo.23619927)
- 実測データ:コーディング課題6段階、163回(DOI 10.5281/zenodo.23600477)
関連記事
- Claude Code キャッシュは1時間:休憩後は507%高い
- Claude の使用量上限まとめ:5時間・週のリセット時刻
- Claude 日本語トークンは英語より65%多い?Opus 5.5実測
- Veo 3.1 料金と無料の使い方:Flow 毎日50クレジットで実測
- Claude Code・Codex・Cursor の使用量と費用を確認する方法
1日のタスク数と大きさを入れて、Claude Code の API 費用を Pro・Max と比べてみましょう。
エージェント費用計算機を開く →