 TokenSave
Claude Opus 5.5: test poziomów effort od low do max
Jonhisking · 9 października 2026
Claude Opus 5.5 ma ustawienie effort, które decyduje o tym, jak głęboko model myśli. Poziomów jest pięć: low, medium, high, xhigh i max. Wyższe poziomy mają dawać lepsze wyniki, ale oficjalna dokumentacja nie podaje żadnych liczb, ile dodatkowego czasu i pieniędzy kosztuje każdy z nich. Dlatego 9 października 2026 roku wysłaliśmy to samo polecenie zbudowania gry na każdym poziomie i porównaliśmy czas, tokeny, koszt i efekt. Najszybszy poziom potrzebował 32 sekund, najwolniejszy 22 minut. Poniżej opisujemy, co zmieniało się na każdym poziomie i który poziom wybrać do jakiego zadania, a do tego dzielimy się doświadczeniem z codziennej pracy.
Czym jest effort
- Określa, ile model myśli. W Opus 5.5 myślenia nie da się wyłączyć; effort reguluje jego głębokość. Tokeny myślenia są rozliczane jako tokeny wyjściowe.
- Domyślnie jest medium. Opus 5 domyślnie działał na high; Opus 5.5 domyślnie działa o poziom niżej, na medium (według dokumentacji Anthropic).
- Jak to zmienić: w Claude Code służy do tego opcja
--effort(od low do max); w API ustawia się wartośćeffort.
Jak mierzyliśmy
- Model: Claude Opus 5.5 w Claude Code na komputerze z Windows
- Prompt (dosłownie): "Make a brick-breaker game that runs in the browser as a single file named index.html in the current folder. It needs 2 levels, a score display and 3 lives, and it must be playable with the keyboard and the mouse. Write the file and finish." Polecenie prosi o grę typu arkanoid działającą w przeglądarce jako jeden plik index.html, z 2 poziomami, licznikiem punktów i 3 życiami, sterowaną klawiaturą i myszą.
- Metoda: ten sam prompt w pięciu przebiegach, zmieniało się tylko effort. Każdy poziom działał we własnym folderze, żeby przebiegi nie wpływały na siebie nawzajem.
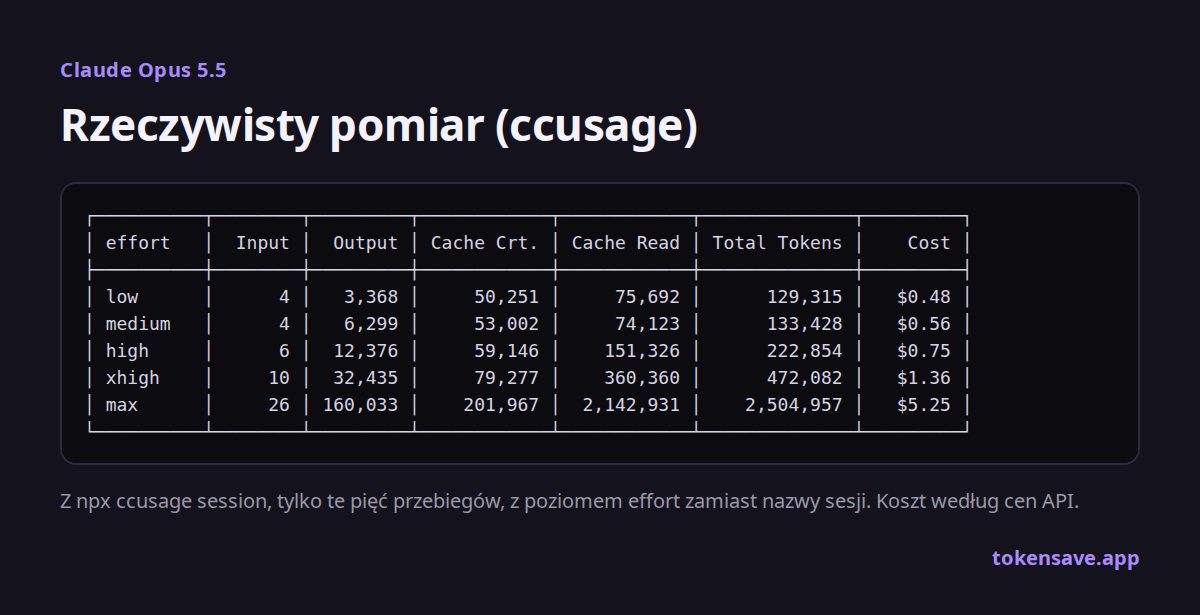
- Pomiar: tokeny i koszt za pomocą darmowego narzędzia ccusage, czas na podstawie znaczników startu i końca. Koszt przeliczono według cen API.
Wyniki: czas, tokeny i koszt
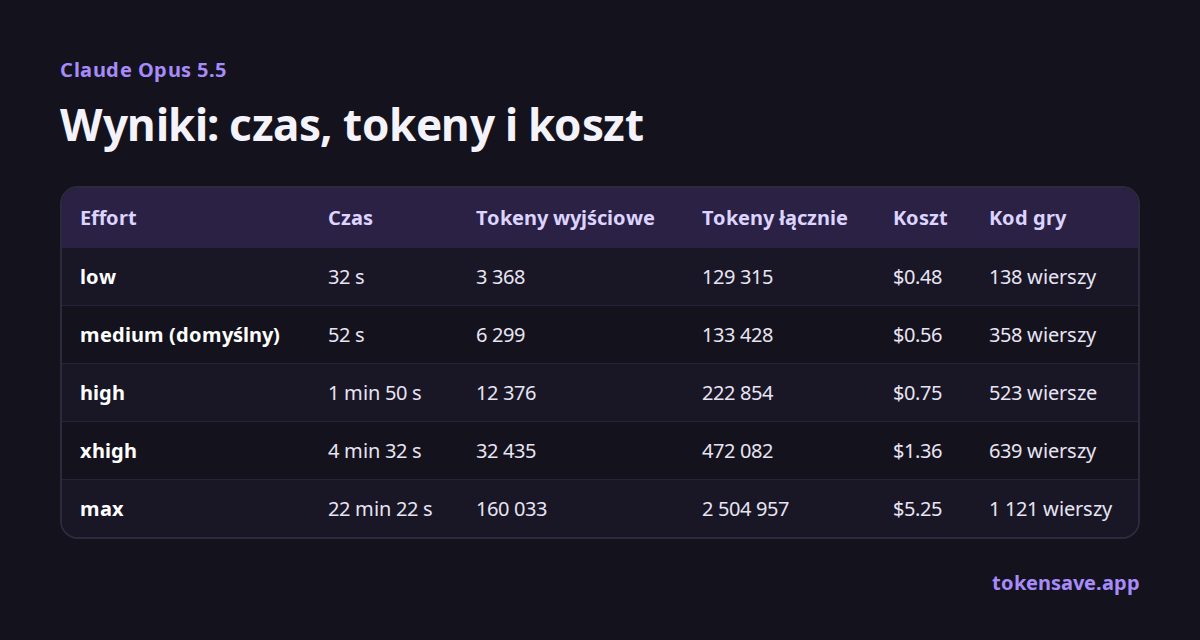
| Effort | Czas | Tokeny wyjściowe | Tokeny łącznie | Koszt | Kod gry |
|---|---|---|---|---|---|
| low | 32 s | 3 368 | 129 315 | $0.48 | 138 wierszy |
| medium (domyślny) | 52 s | 6 299 | 133 428 | $0.56 | 358 wierszy |
| high | 1 min 50 s | 12 376 | 222 854 | $0.75 | 523 wiersze |
| xhigh | 4 min 32 s | 32 435 | 472 082 | $1.36 | 639 wierszy |
| max | 22 min 22 s | 160 033 | 2 504 957 | $5.25 | 1 121 wierszy |
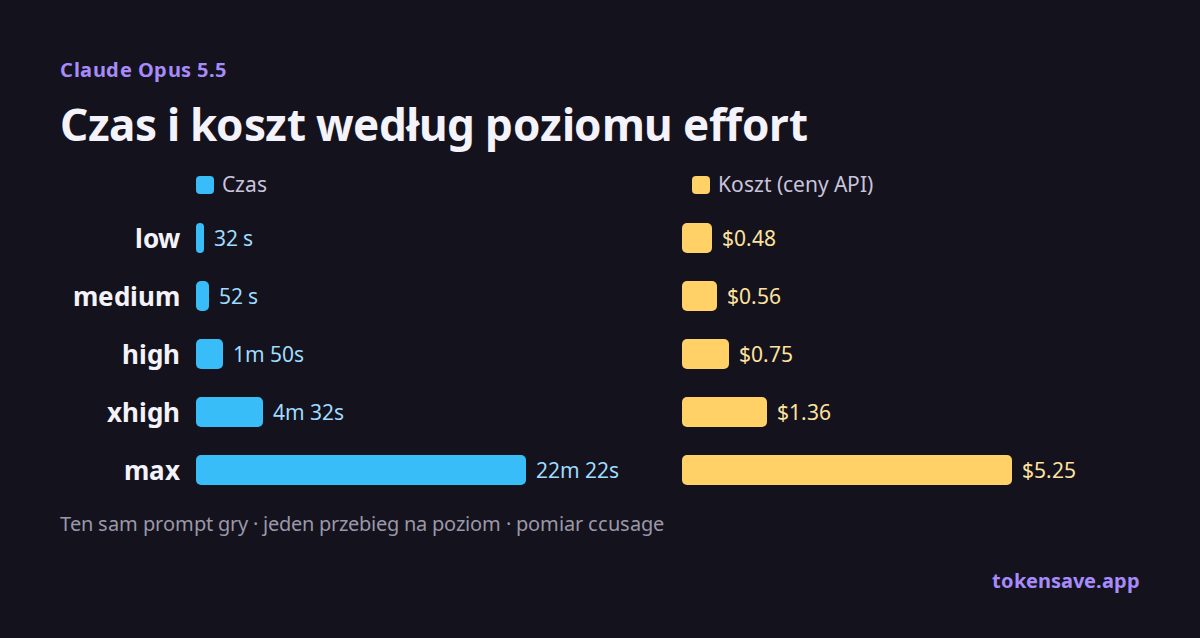
- Low i medium niemal się nie różnią. Low kosztował o 14% mniej i trwał o 38% krócej, ale to zaledwie 8 centów.
- High kosztował tylko o 34% więcej niż medium. Czas wzrósł z 52 sekund do 1 minuty 50 sekund.
- Przy xhigh koszty wyraźnie skaczą. Wyszło o 143% drożej niż medium, a przebieg trwał 4 minuty 32 sekundy.
- Max to zupełnie inna liga. Medium potrzebował 52 sekund i $0.56; max 22 minut 22 sekund i $5.25. Tokeny wyjściowe wzrosły z 6 299 do 160 033.
Pięć gier obok siebie
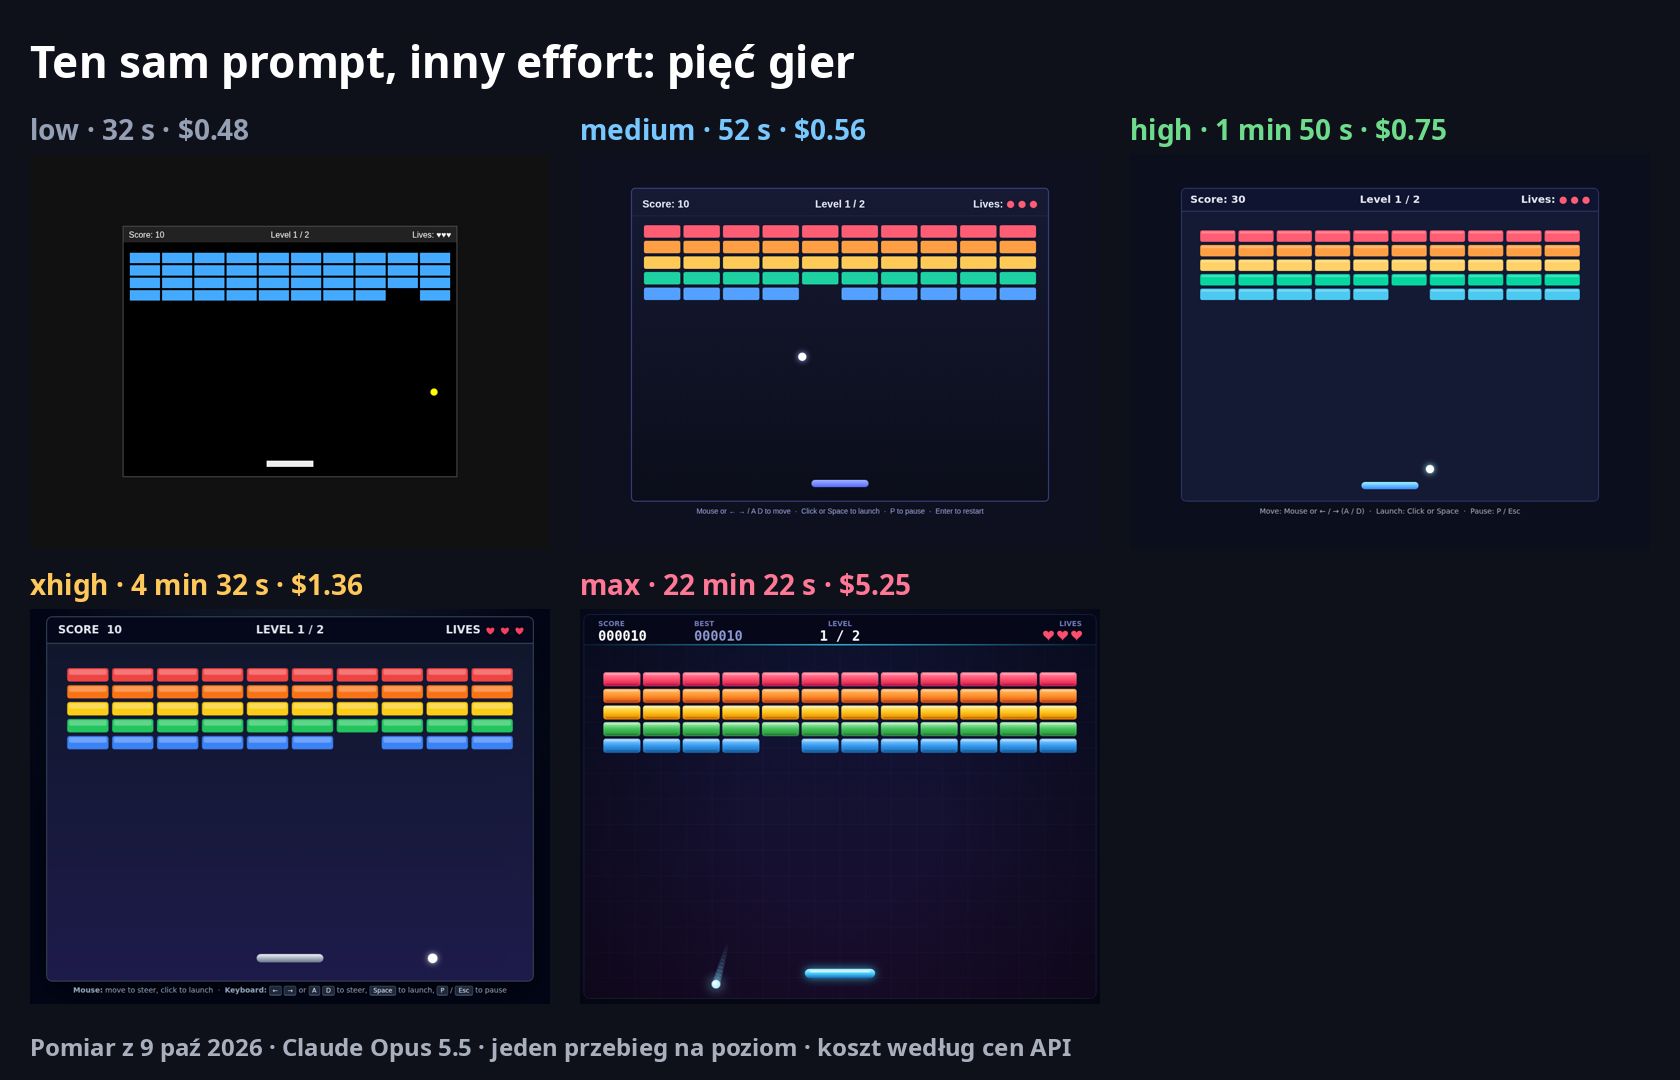
Wszystkie pięć gier uruchomiło się bez błędów i spełniało wymagania: 2 poziomy, punkty, 3 życia, sterowanie klawiaturą i myszą. Różnice dotyczą tego, co każdy poziom dodał od siebie.
| Effort | Co dodał |
|---|---|
| low | Jednokolorowe cegły, najskromniejszy ekran, brak pauzy |
| medium | Tęczowe cegły, pauza, restart |
| high | + efekty cząsteczkowe, zapisywany najlepszy wynik |
| xhigh | Efekty cząsteczkowe, bardziej dopracowany wygląd (bez zapisywanego najlepszego wyniku) |
| max | + efekty dźwiękowe, nazwy poziomów, poziom 2 w kształcie kosmicznego najeźdźcy, drganie ekranu, fajerwerki na zwycięstwo |
- Od high w górę model próbował sam sprawdzić swoją pracę. High i xhigh próbowały sprawdzić składnię kodu, a max próbował uruchomić automatyczny test rozgrywki. We wszystkich trzech przypadkach potrzebna była zgoda na uruchomienie, więc żaden test faktycznie się nie wykonał; każdy z modeli pisze, że zamiast tego ponownie przeczytał kod. Low i medium zakończyły pracę bez sprawdzania.
- Cegły wymagające dwóch uderzeń pojawiły się na każdym poziomie, choć wcale o nie nie prosiliśmy.
Przegląd poziom po poziomie
Zagraliśmy w każdą grę i porównaliśmy ją z podsumowaniem, które model zostawił na końcu, oraz z samym kodem.
low: 32 sekundy, $0.48
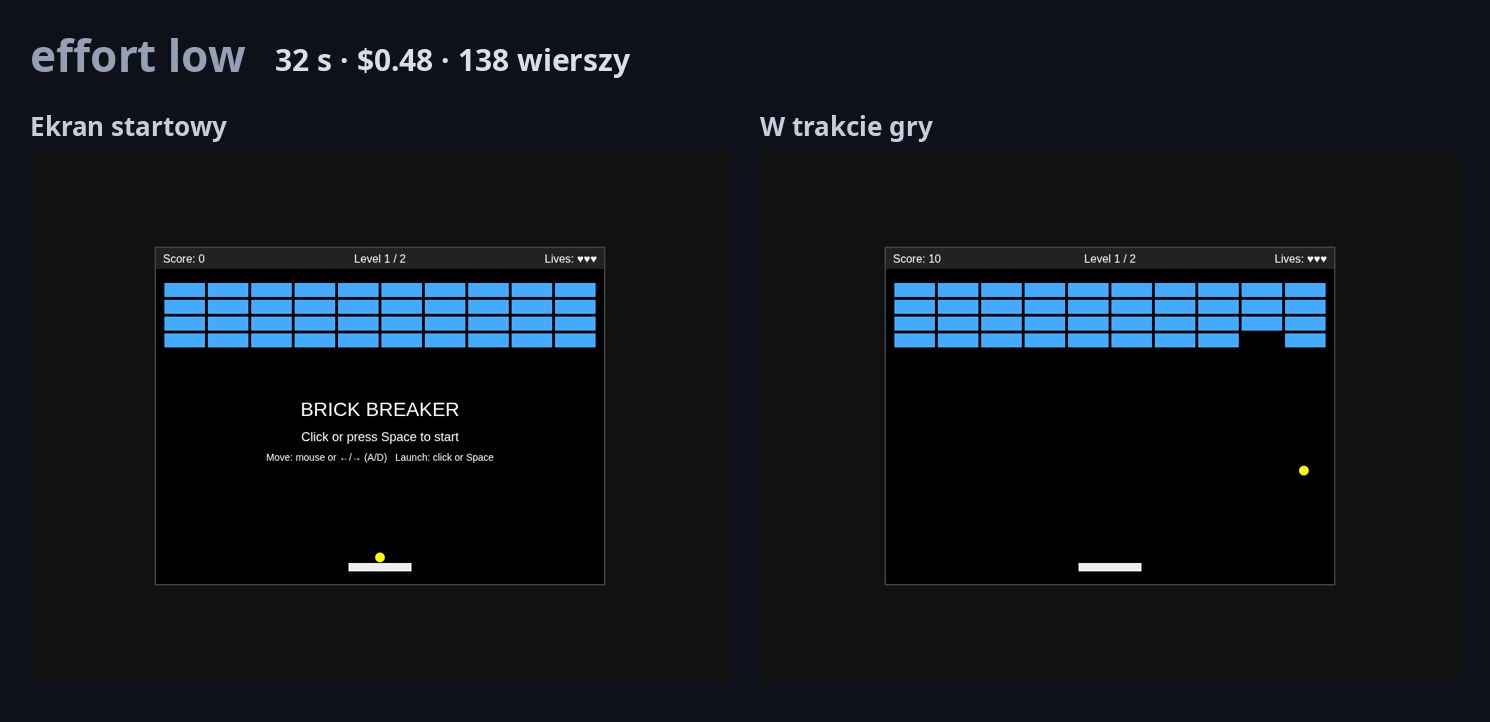
- Co zbudował: poziom 1 to cztery rzędy niebieskich cegieł; poziom 2 łączy pomarańczowe cegły wymagające dwóch uderzeń z przerwami, a piłka jest szybsza. Są ekrany ukończenia poziomu, końca gry i wygranej oraz restart.
- Plusy: jest każda wymagana funkcja, a miejsce, w którym piłka uderza w paletkę, zmienia kąt odbicia. Gotowe w 32 sekundy.
- Minusy: czarne tło i jednokolorowe cegły sprawiają, że to najskromniejsza wersja. Brak pauzy, a 138 wierszy to najkrótszy kod.
- Kiedy go używać: gdy chcesz tylko sprawdzić, czy coś działa, i dopracujesz to później.
medium: 52 sekundy, $0.56 (domyślny)
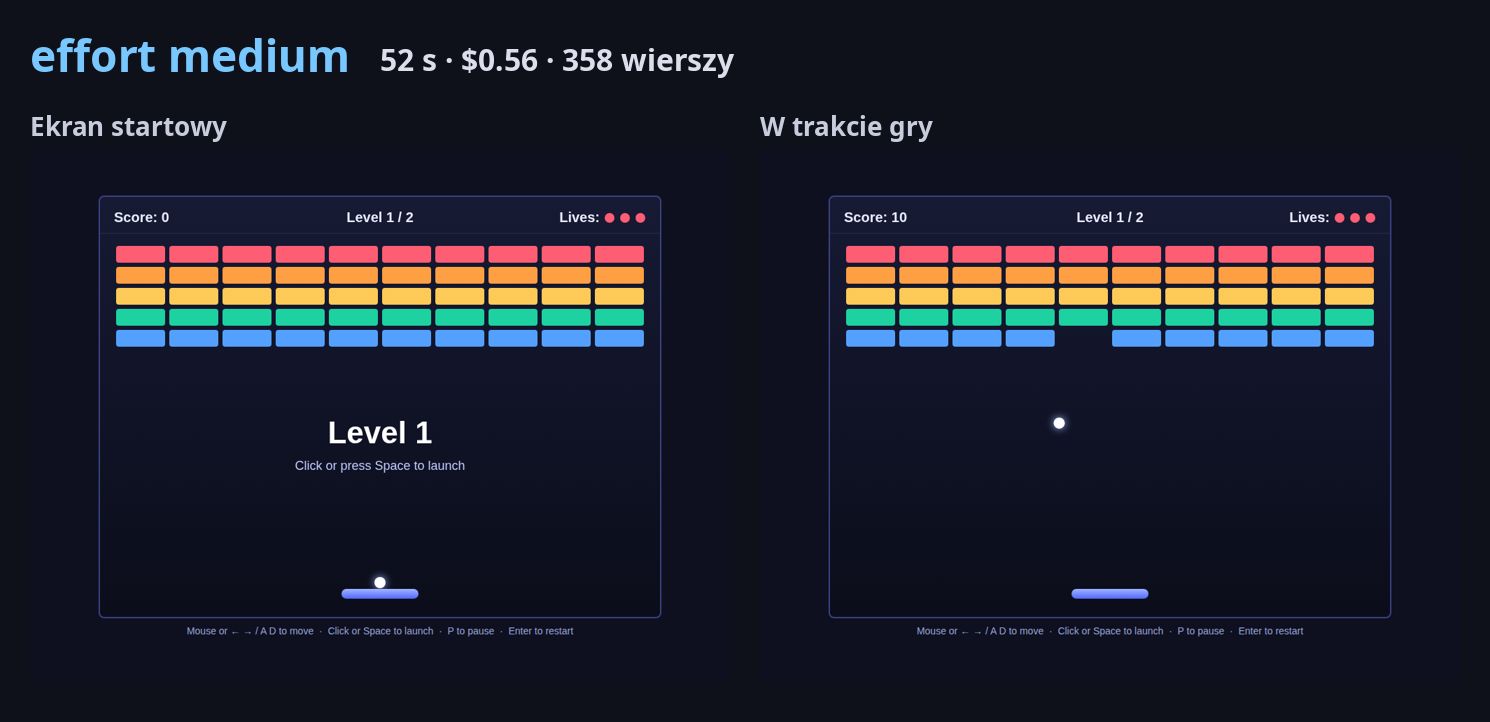
- Co zbudował: poziom 1 to tęczowa siatka 5×10; poziom 2 ma przerwy i cegły wymagające 2 lub 3 uderzeń, które pokazują liczbę pozostałych trafień i bledną, gdy są uszkadzane.
- Plusy: pauza (P lub Esc), restart (Enter) i automatyczna pauza, gdy okno traci fokus. Punktacja zależy od wytrzymałości cegły i poziomu.
- Minusy: brak dźwięku i efektów cząsteczkowych.
- Kiedy go używać: w większości przypadków. Kosztuje o 8 centów więcej niż low i jest wyraźnie lepszy.
high: 1 minuta 50 sekund, $0.75
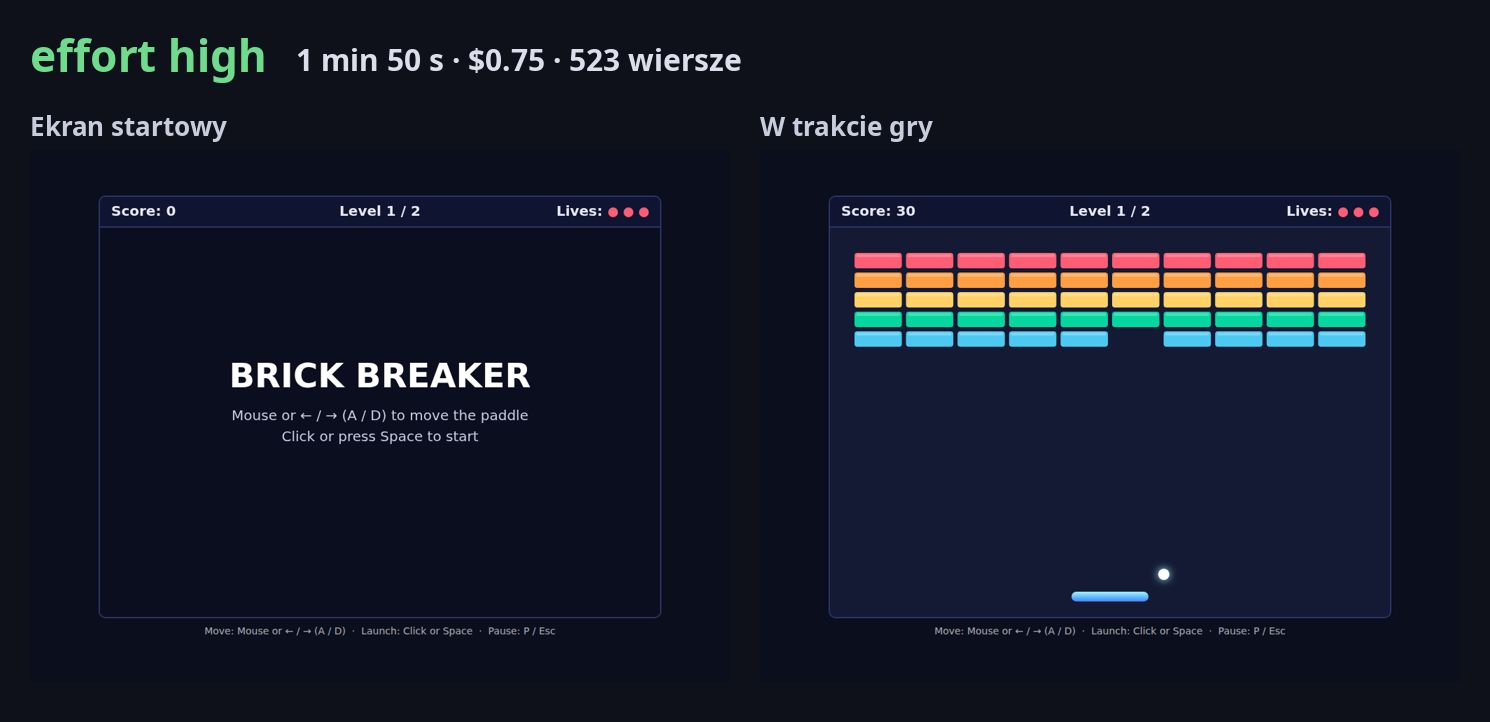
- Co zbudował: poziom 2 to układ w kształcie rombu z cegieł wymagających 2 lub 3 uderzeń, a rozbijane cegły rozsypują się w cząsteczki.
- Plusy: premia za ukończenie poziomu, premia za pozostałe życia, zapisywany najlepszy wynik i sterowanie dotykiem. Model sam też próbował sprawdzić składnię swojego kodu.
- Minusy: trwał o 112% dłużej niż medium (z 52 sekund do 1 minuty 50 sekund).
- Kiedy go używać: gdy potrzebujesz prototypu do pokazania innym albo kodu, w którym liczy się jakość. Kosztował tylko o 34% więcej niż medium.
xhigh: 4 minuty 32 sekundy, $1.36
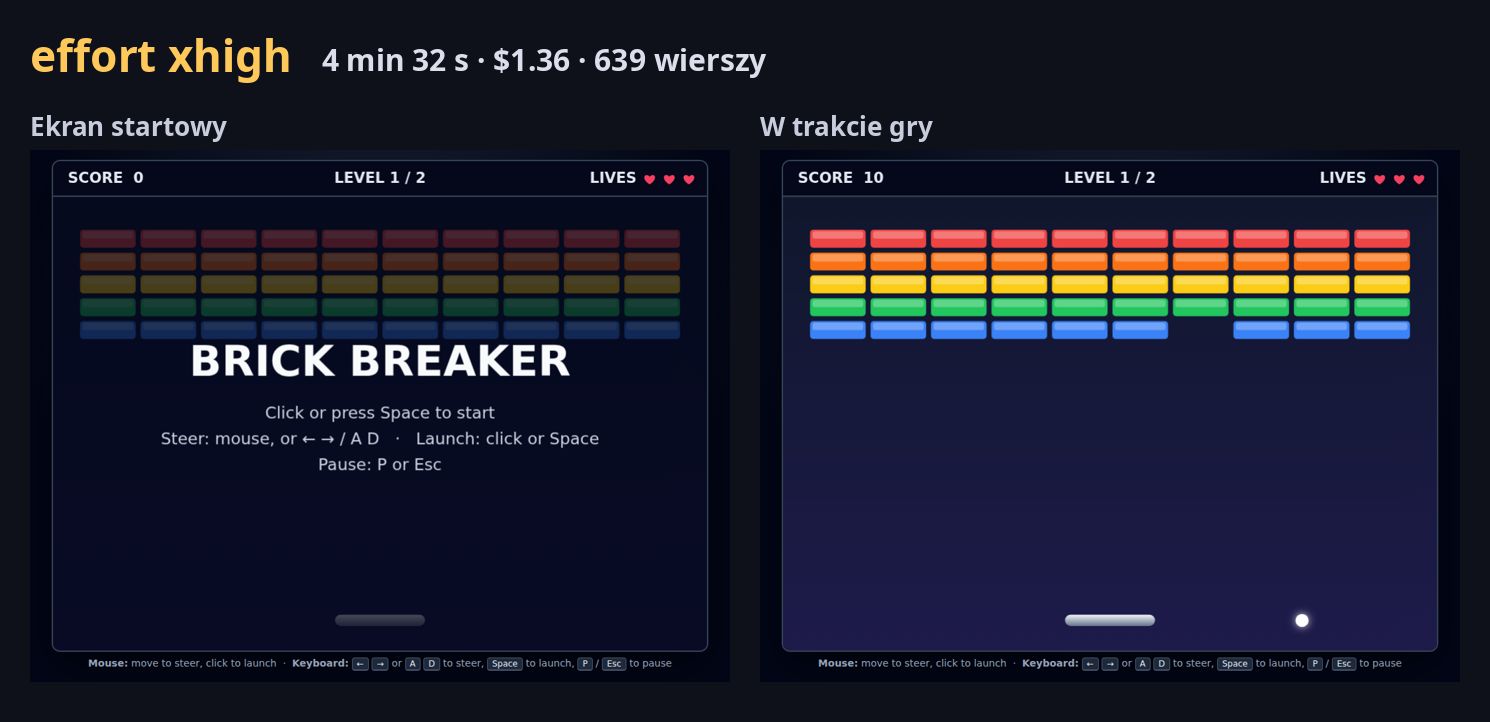
- Co zbudował: poziom 2 to romb otoczony stalowymi cegłami, które pękają po pierwszym trafieniu. Cegły są warte od 10 do 50 punktów w zależności od koloru.
- Plusy: najstaranniej wyglądający ekran, a łączenie myszy i klawiatury działa płynnie: paletką steruje to, czego użyłeś ostatnio.
- Minusy: zniknęły zapisywany najlepszy wynik i sterowanie dotykiem, które miał high. Kosztował o 143% więcej niż medium, nie dodając żadnych funkcji ponad high.
- Kiedy go używać: nie do tak małych zadań. Według Anthropic sprawdza się przy długotrwałej pracy.
max: 22 minuty 22 sekundy, $5.25
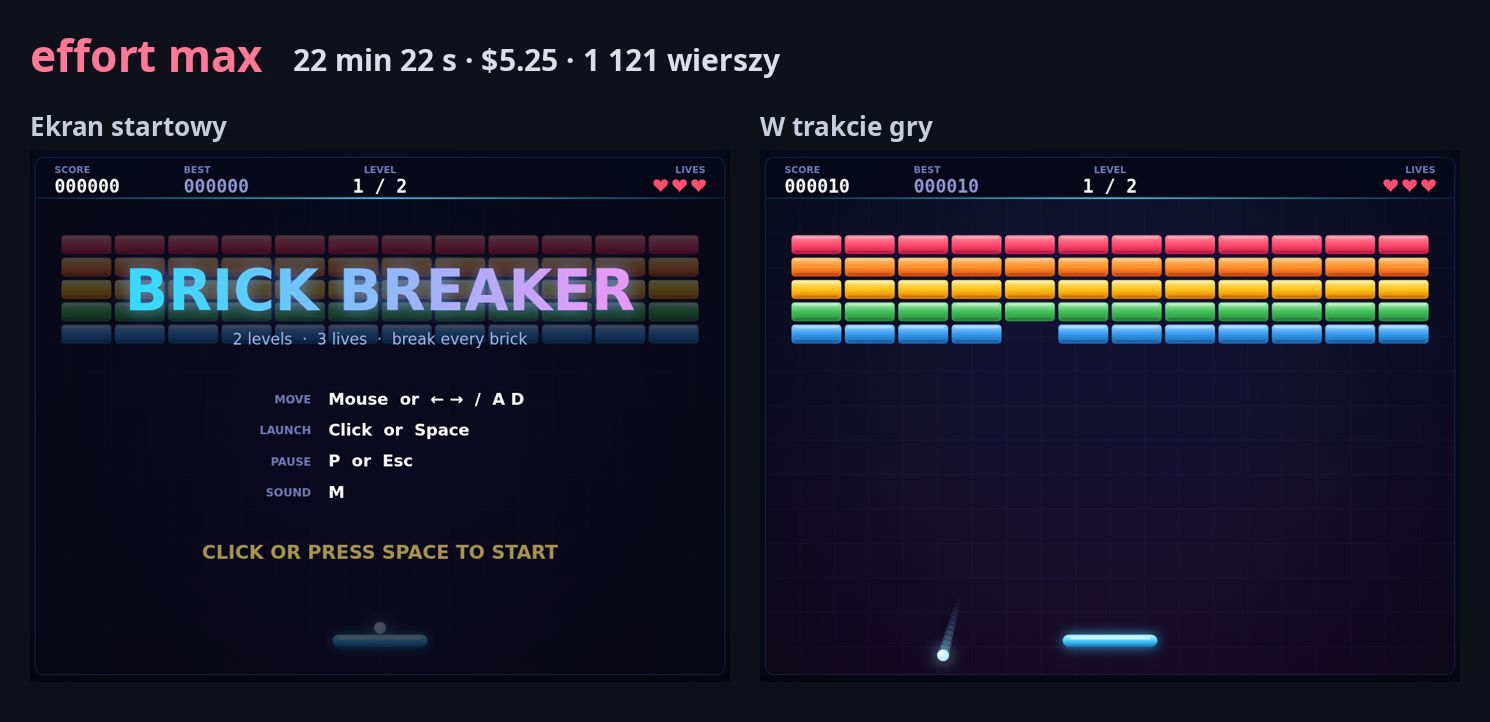
- Co zbudował: poziomy z nazwami („Rainbow Wall”, „Space Invader”), poziom 2 w kształcie kosmicznego najeźdźcy z 14 srebrnymi cegłami wymagającymi dwóch uderzeń oraz węższą paletkę na poziomie 2.
- Plusy: efekty dźwiękowe (M włącza i wyłącza), zapisywany najlepszy wynik, sterowanie dotykiem, drganie ekranu, fajerwerki na zwycięstwo i automatyczna pauza: najwięcej ze wszystkich poziomów. Wygląda jak skończona gra.
- Minusy: zdecydowanie najwolniejszy, częściowo dlatego, że próbował uruchomić automatyczny test rozgrywki, który wymagał zgody.
- Kiedy go używać: gdy jakość jest najważniejsza i masz zapas czasu oraz limitów albo gdy nic innego nie rozwiązuje problemu.
Z praktyki: na co dzień medium, do kodowania high
Ja (Jaehyun) używam Opus 5.5 w planie Claude Max 20x do tworzenia gier. Tak to wygląda w codziennym użyciu; to wrażenia, nie pomiar.
- Moje ustawienie: zostawiam effort na auto. Zwykle działa na medium, a gdy koduję, przechodzi na high.
- low: wydawał się ospały, więc po kilku podejściach przestałem go używać.
- high: wyniki są wyraźnie lepsze.
- xhigh i max: wypróbowałem je mniej więcej po jednym podejściu i rzadko mam powód, żeby po nie sięgać.
W porównaniu z pomiarami low był w rzeczywistości najszybszy, ale dawał najskromniejszy efekt, więc wrażenie ospałości dotyczyło wyniku, a nie szybkości. Poczucie, że high daje lepsze wyniki, a xhigh i max rzadko są potrzebne, zgadzało się z liczbami.
Co zaleca Anthropic
- Medium jest mocny. W testach Anthropic Opus 5.5 na medium dorównywał lub przewyższał Opus 5 na high w kodowaniu i pracy z wiedzą.
- Low zbliża się do medium w kodowaniu, przy znacznie niższym koszcie, jak podaje Anthropic. W naszym teście różnica w efekcie była zauważalna.
- xhigh i max zostaw na zadania, w których zmierzyłeś wzrost jakości.
- Zmiana effort w trakcie rozmowy może unieważnić prompt cache. W API zmieniaj effort dla pojedynczej wiadomości, żeby zachować cache.
- Niezależne testy to potwierdzają. Artificial Analysis ustaliło, że Opus 5.5 na effort max zużywał na zadanie o 63% więcej tokenów wyjściowych niż Opus 5 (według doniesień prasowych).
Jaki effort do jakiego zadania
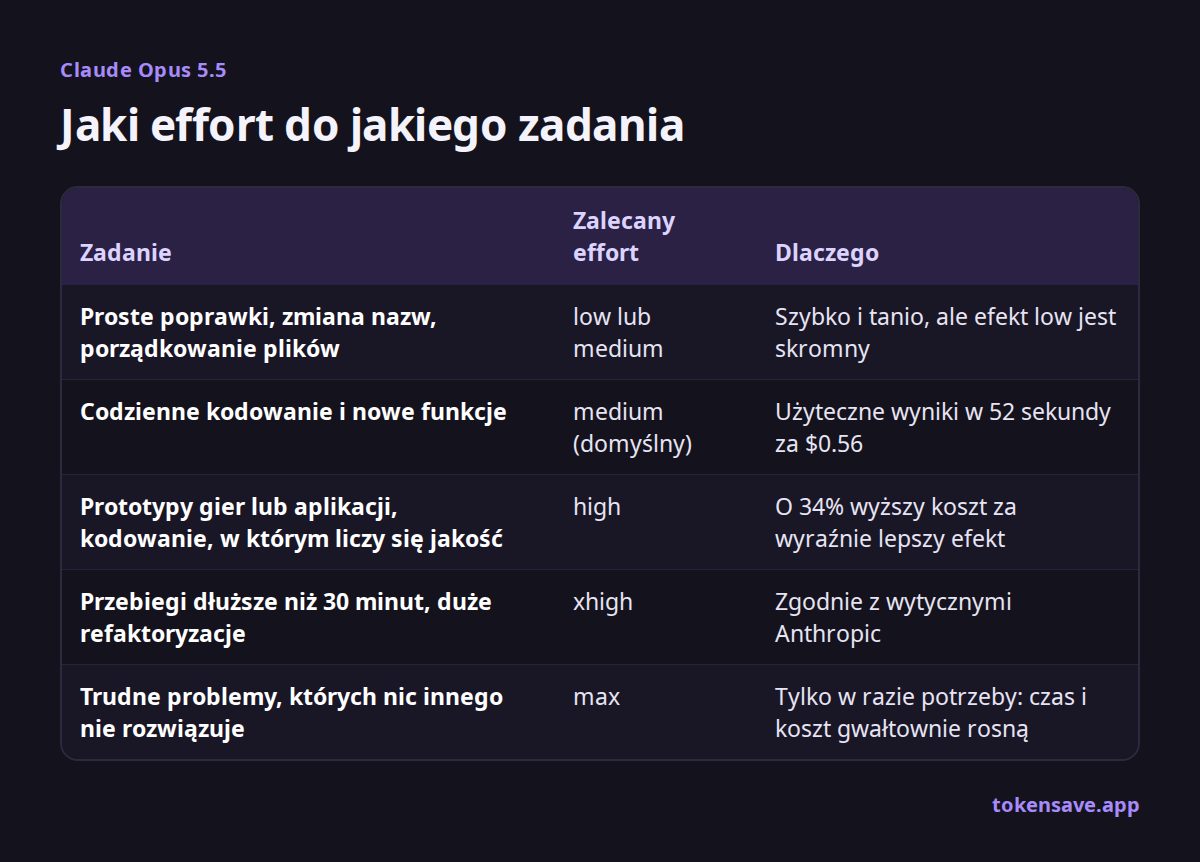
Nasze zalecenia, łączące pomiary, doświadczenie Jaehyuna i wskazówki Anthropic:
| Zadanie | Zalecany effort | Dlaczego |
|---|---|---|
| Proste poprawki, zmiana nazw, porządkowanie plików | low lub medium | Szybko i tanio, ale efekt low jest skromny |
| Codzienne kodowanie i nowe funkcje | medium (domyślny) | Użyteczne wyniki w 52 sekundy za $0.56 |
| Prototypy gier lub aplikacji, kodowanie, w którym liczy się jakość | high | O 34% wyższy koszt za wyraźnie lepszy efekt |
| Przebiegi dłuższe niż 30 minut, duże refaktoryzacje | xhigh | Zgodnie z wytycznymi Anthropic |
| Trudne problemy, których nic innego nie rozwiązuje | max | Tylko w razie potrzeby: czas i koszt gwałtownie rosną |
- Zacznij od medium. Na high przenoś tylko te zadania, w których wynik nie wystarcza.
- W planie subskrypcyjnym myśl o limitach. Im wyższy koszt w przeliczeniu na ceny API, tym szybciej wyczerpuje się limit Max lub Pro. Jeden przebieg na max zużył więcej niż dziewięć przebiegów na medium.
- Zastrzeżenie: po jednym przebiegu na poziom przy dość małym zadaniu. Przy większych projektach różnice mogą wyglądać inaczej.
Podsumowanie: domyślnie medium, high gdy liczy się jakość
- Domyślnie: medium. Użyteczne wyniki w 52 sekundy za $0.56.
- Gdy liczy się jakość: high. Tylko o 34% więcej niż medium za wyraźnie lepszy efekt. Najlepszy stosunek ceny do jakości z całej piątki.
- xhigh: pomiń przy małych zadaniach. O 143% drożej niż medium, a funkcji nie więcej niż w high. Opłaca się tylko przy długich przebiegach.
- max: tylko gdy naprawdę go potrzebujesz. Najbardziej efektowny wynik, ale 22 minuty i $5.25.
- low: niezalecany. Oszczędność 8 centów względem medium daje tylko skromniejszy efekt.
Częste pytania
Jaki jest domyślny effort w Opus 5.5? Medium. Opus 5 domyślnie działał na high. Żądania API bez ustawionego effort działają w Opus 5.5 na medium.
Czy max zawsze jest lepszy? W naszym teście dodał najwięcej funkcji i dopracowania, ale potrzebował 22 minut i $5.25, wobec 52 sekund i $0.56 na medium. To za dużo jak na proste zadania.
Czy low pozwala dużo zaoszczędzić? W naszym teście low był tylko o 14% tańszy od medium. Biorąc pod uwagę skromniejszy efekt, lepszym wyborem jest medium.
Policz to dla swojej pracy
W kalkulatorze kosztów agentów kodujących wpisz wielkość zadania i liczbę zadań dziennie, aby zobaczyć koszt miesiąca na Opus 5.5. Koszt pojedynczego promptu sprawdzisz w liczniku tokenów. Różnice w cenie i wydajności między Opus 5 a 5.5 opisuje artykuł Claude Opus 5 vs 5.5 (po angielsku). Jeśli pracujesz w planie subskrypcyjnym, zajrzyj też do tekstu Limity Claude Code.
Pomiar z 9 października 2026 roku. Koszt to przeliczenie ccusage według cen API; wyniki mogą się zmienić wraz z aktualizacjami modelu i Claude Code.
Źródła
- Anthropic: Effort
- Anthropic: Promptowanie Claude Opus 5.5
- Anthropic: Migracja z Claude Opus 5 na Opus 5.5
- OfficeChai: raport Artificial Analysis Intelligence Index
- ccusage: narzędzie do śledzenia użycia Claude Code (GitHub)
Więcej artykułów
- Vibe coding gra: zrobiłem grę z AI w 3 dni za 45 USD
- Testy zamknięte Google Play: 12 testerów, 14 dni i 14 błędów
- Popularne gry Roblox: najpopularniejsze gry Roblox 2026
- Najtańsze API AI 2026: cennik API i koszt 1 mln tokenów
- Codex limity: okno 5 godzin, limit tygodniowy i Codex limit Plus
Wpisz wielkość zadania i liczbę zadań dziennie, aby porównać miesiąc na Opus 5.5, Sonnet 5.5 i GPT-6 Sol.
Otwórz kalkulator kosztów agentów kodujących →