 TokenSave
한국어 프롬프트는 영어보다 토큰이 몇 배 들까? 34개 언어 실측
Jonhisking · 2026년 9월 30일
"한국어로 프롬프트 쓰면 영어보다 토큰이 2~3배 든다"는 얘기, 한 번쯤 들어보셨을 겁니다. 저도 그렇게 알고 있었는데, 직접 재본 적은 없더라고요.
그래서 재봤습니다. 같은 프롬프트를 34개 언어로 옮겨서 OpenAI 토크나이저로 토큰 수를 셌습니다. 결론부터 말하면 한국어는 영어의 1.44배입니다. "2~3배"는 이제 옛날 얘기였습니다.
어떻게 쟀나
영어로 34토큰짜리 평범한 고객 응대 프롬프트를 썼습니다.
Please summarize the customer email below in three bullet points and suggest a polite reply. The customer says the order arrived two days late and one item was missing from the box.
한국어 버전은 이렇습니다.
아래 고객 이메일을 세 가지 요점으로 요약하고 정중한 답장을 제안해 주세요. 고객은 주문이 이틀 늦게 도착했고 상자에서 물건 하나가 빠져 있었다고 말합니다.
이걸 34개 언어로 옮긴 뒤 두 가지 토크나이저로 셌습니다.
- o200k_base: GPT-4o 이후 OpenAI 모델이 쓰는 현재 토크나이저
- cl100k_base: GPT-4, GPT-3.5 시절의 예전 토크나이저 (비교용)
import { getEncoding } from "js-tiktoken";

const enc = getEncoding("o200k_base");
const count = (text) => enc.encode(text).length;

count(english); // 34
count(korean);  // 49
파이썬이라면 tiktoken으로 똑같이 할 수 있습니다.
import tiktoken
enc = tiktoken.get_encoding("o200k_base")
print(len(enc.encode(korean)))  # 49
결과
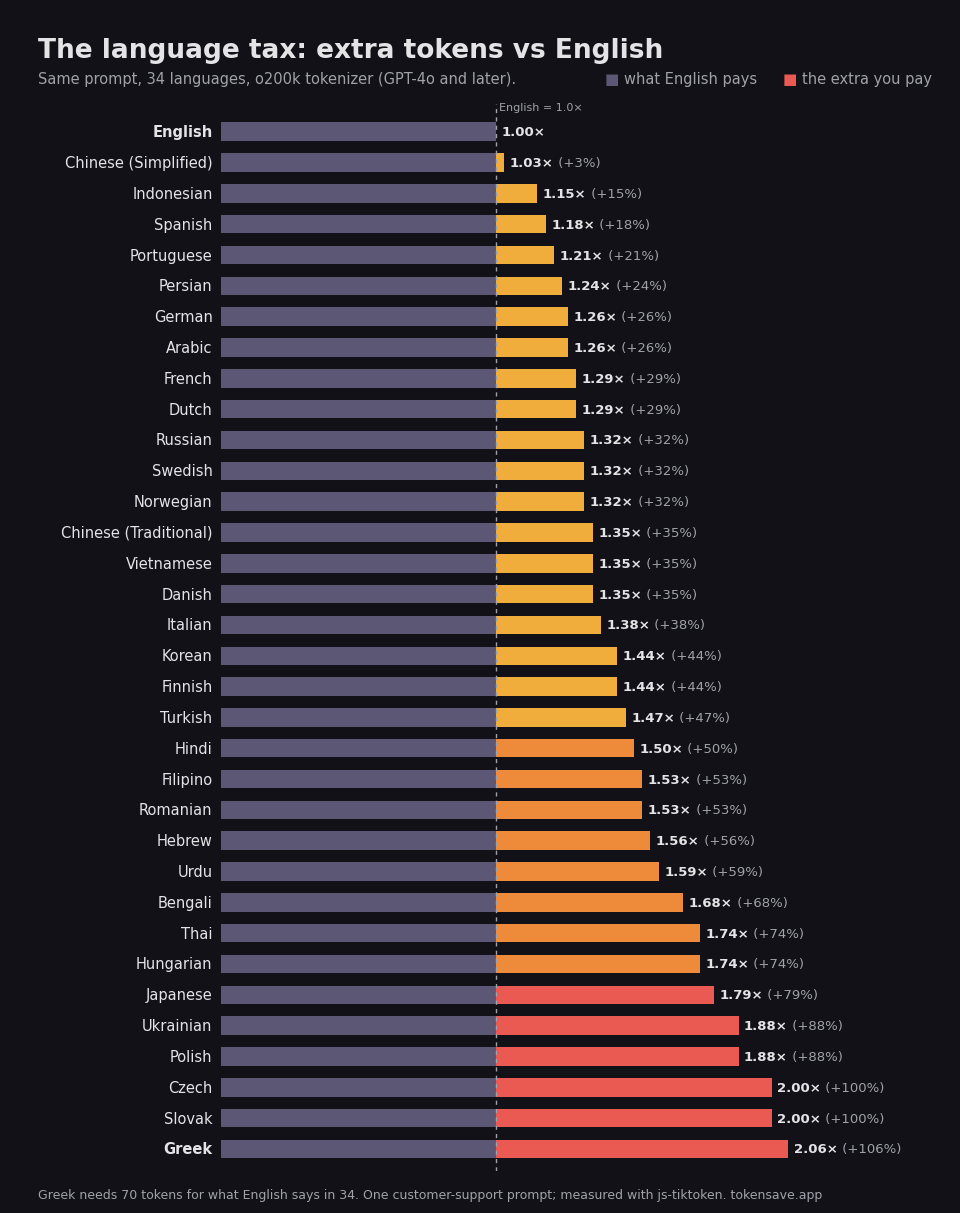
| 언어 | 토큰 수 (o200k) | 영어 대비 | 예전 GPT-4 토크나이저 (cl100k) |
|---|---|---|---|
| 영어 | 34 | 1.00배 | 1.00배 |
| 중국어(간체) | 35 | 1.03배 | 1.53배 |
| 스페인어 | 40 | 1.18배 | 1.29배 |
| 독일어 | 43 | 1.26배 | 1.50배 |
| 프랑스어 | 44 | 1.29배 | 1.44배 |
| 러시아어 | 45 | 1.32배 | 2.15배 |
| 베트남어 | 46 | 1.35배 | 2.32배 |
| 한국어 | 49 | 1.44배 | 2.50배 |
| 힌디어 | 51 | 1.50배 | 4.59배 |
| 태국어 | 59 | 1.74배 | 3.71배 |
| 일본어 | 61 | 1.79배 | 2.21배 |
| 폴란드어 | 64 | 1.88배 | 2.12배 |
| 체코어 | 68 | 2.00배 | 2.59배 |
| 그리스어 | 70 | 2.06배 | 4.94배 |
34개 언어 전체 결과는 영어로 정리한 글에 있습니다.
의외였던 점
1. "한국어 2~3배"는 예전 토크나이저 기준이었다
GPT-4 시절 토크나이저로 재면 한국어는 2.50배입니다. 우리가 알던 숫자가 여기서 나온 거죠. 지금 토크나이저에서는 1.44배까지 내려왔습니다. 같은 프롬프트라면 예전보다 토큰이 40% 넘게 줄어든 셈입니다.
한글 한 글자당으로 치면 예전에는 1.3토큰 정도였는데, 지금은 0.77토큰 정도입니다. 자주 쓰는 음절과 단어는 한 덩어리로 처리된다는 뜻입니다.
2. 이제 일본어가 한국어보다 비싸다
예전 토크나이저에서는 일본어(2.21배)가 한국어(2.50배)보다 쌌습니다. 지금은 뒤집혀서 일본어가 1.79배로 한국어보다 비쌉니다. 일본어는 토크나이저가 바뀌어도 가장 덜 줄어든 언어 중 하나였습니다.
3. 가장 비싼 언어는 아시아 언어가 아니었다
1위는 그리스어(2.06배), 그다음이 체코어·슬로바키아어(2.00배)와 폴란드어·우크라이나어(1.88배)입니다. 알파벳을 쓰는 언어라도 어미 변화가 많으면 잘게 쪼개지는 것 같습니다. 반대로 중국어(간체)는 영어와 거의 같았습니다(1.03배).
돈으로 따지면
입력 100만 토큰당 2달러인 모델에 이 프롬프트를 100만 번 보낸다고 해보겠습니다.
| 언어 | 입력 토큰 | 입력 비용 |
|---|---|---|
| 영어 | 3,400만 | $68 |
| 한국어 | 4,900만 | $98 |
| 일본어 | 6,100만 | $122 |
| 체코어 | 6,800만 | $136 |
입력만 계산한 겁니다. 답변도 한국어로 받으면 토큰 단가가 보통 4~5배 비싼 출력에도 같은 배수가 붙습니다.
한국어로 토큰 아끼는 방법
- 시스템 프롬프트와 고정 지시문은 영어로 쓰기. 사용자 입력만 한국어로 두면, 매 요청마다 반복해서 보내는 부분의 비용이 줄어듭니다.
- 중간 단계는 영어나 JSON으로 받기. 분류, 정보 추출, 도구 호출 같은 단계는 영어로 처리하고, 사용자에게 보여줄 최종 답변만 한국어로 받습니다.
- 공백과 빈 줄 정리하기. 문서에서 복사한 텍스트에는 불필요한 공백이 생각보다 많습니다.
- 과한 존댓말 줄이기. "~해 주시면 감사하겠습니다" 같은 표현은 지시 효과에 비해 토큰을 많이 씁니다. 모델한테는 "~해 주세요"면 충분합니다.
- 프롬프트 캐시 활용하기. 고정된 앞부분을 캐시하면 입력 단가가 크게 떨어집니다. 90% 넘게 싸지는 모델도 있습니다.
한계
- 프롬프트 하나로 잰 결과입니다. 문장에 따라 배수가 0.1~0.2 정도 달라질 수 있으니 순위는 대략적인 참고용으로 봐주세요.
- 번역은 기계 번역을 바탕으로 확인했습니다.
- Claude와 Gemini는 토크나이저가 달라서, 이 숫자가 그대로 맞는 건 OpenAI 모델뿐입니다.
내 프롬프트로 직접 재보세요. 한국어가 영어보다 토큰과 비용이 몇 배 드는지 바로 보여드립니다.
토큰 계산기 열기 →