 TokenSave
Claude Opus 5.5 effort 实测:从 low 到 max
Jonhisking · 2026 年 10 月 9 日
Claude Opus 5.5 有一个控制思考深度的 effort 设置,共五个等级:low、medium、high、xhigh 和 max。等级越高,结果理应越好,但官方文档并没有给出每提高一级要多花多少时间和费用。于是我们在 2026 年 10 月 9 日用同一个做游戏的请求,在每个等级各跑了一次,对比耗时、token、费用和成品。最快的等级只用了 32 秒,最慢的用了 22 分钟。下面逐级看看发生了什么变化、什么任务该用哪个等级,并附上实际使用体验。
effort 是什么
- 它决定模型思考多少。 Opus 5.5 的思考无法关闭,effort 控制的是思考的深度。思考 token 按输出 token 计费。
- 默认值是 medium。 Opus 5 的默认值是 high;Opus 5.5 的默认值低了一级,是 medium(据 Anthropic 文档)。
- 修改方法: 在 Claude Code 中使用
--effort选项(low 到 max);在 API 中设置effort值。
测试方法
- 模型: 在 Windows 电脑上通过 Claude Code 使用 Claude Opus 5.5
- 提示词(原文): "Make a brick-breaker game that runs in the browser as a single file named index.html in the current folder. It needs 2 levels, a score display and 3 lives, and it must be playable with the keyboard and the mouse. Write the file and finish." 也就是要求在当前文件夹中用单个 index.html 文件做一个能在浏览器里运行的打砖块游戏,包含 2 个关卡、分数显示和 3 条命,并且能用键盘和鼠标操作,写完文件即结束。
- 方法: 同一个提示词跑五次,只改变 effort。每个等级在各自独立的文件夹中运行,互不影响。
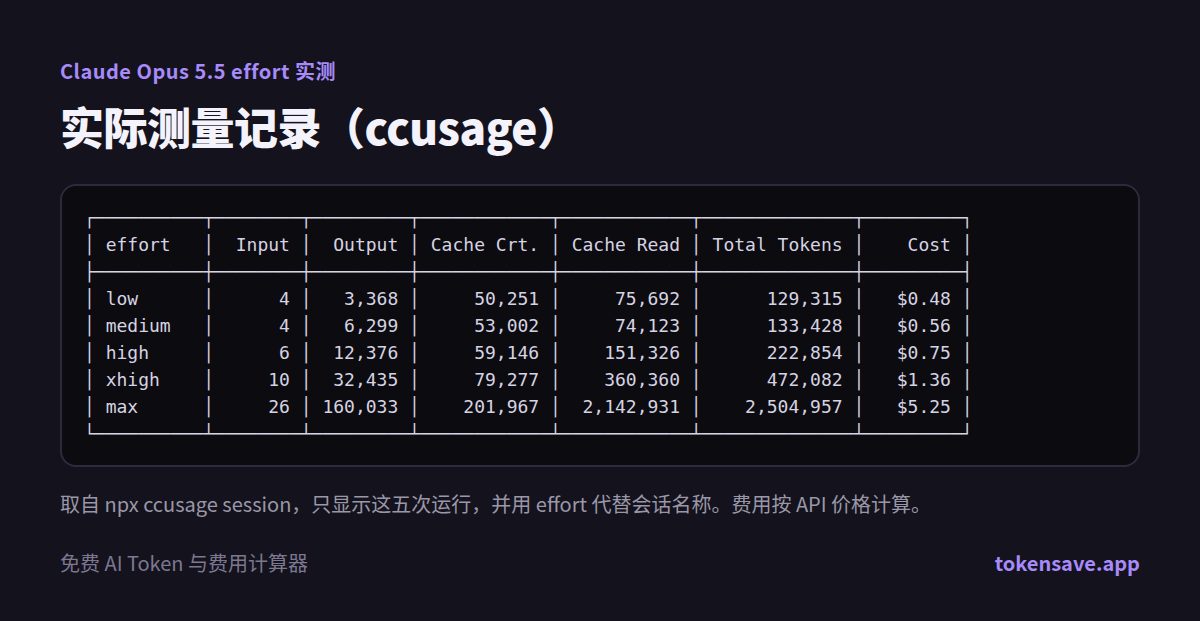
- 测量: token 和费用使用免费工具 ccusage 统计,耗时根据开始和结束时间戳计算。费用按 API 价格换算。
结果:耗时、token 和费用
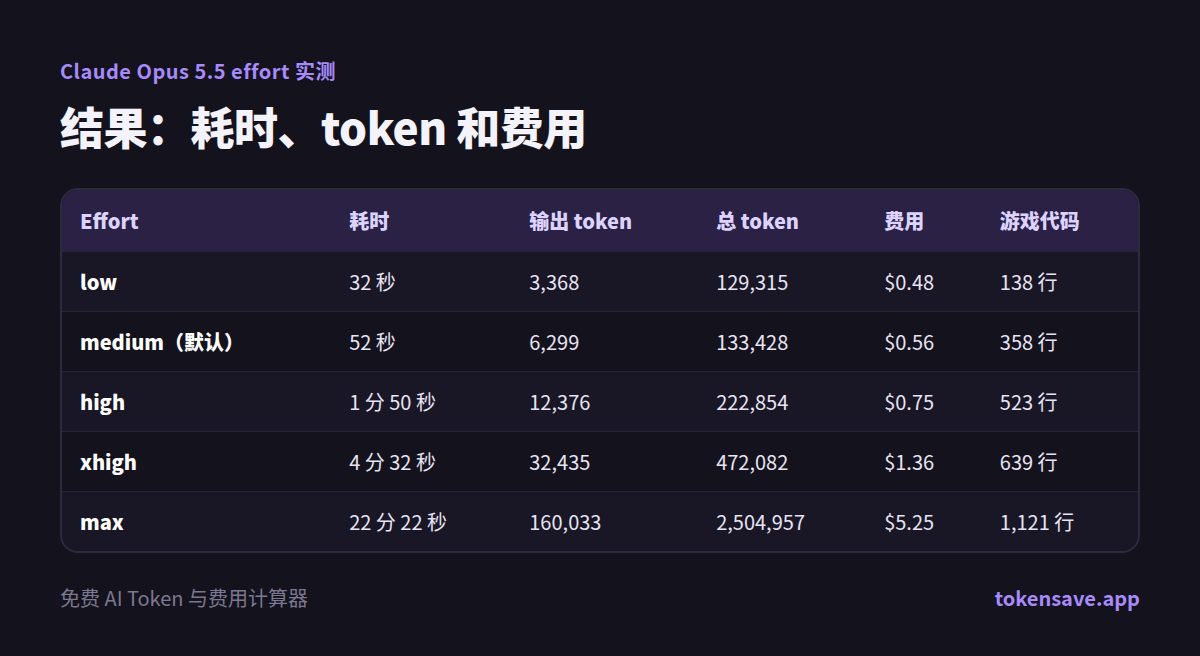
| Effort | 耗时 | 输出 token | 总 token | 费用 | 游戏代码 |
|---|---|---|---|---|---|
| low | 32 秒 | 3,368 | 129,315 | $0.48 | 138 行 |
| medium(默认) | 52 秒 | 6,299 | 133,428 | $0.56 | 358 行 |
| high | 1 分 50 秒 | 12,376 | 222,854 | $0.75 | 523 行 |
| xhigh | 4 分 32 秒 | 32,435 | 472,082 | $1.36 | 639 行 |
| max | 22 分 22 秒 | 160,033 | 2,504,957 | $5.25 | 1,121 行 |
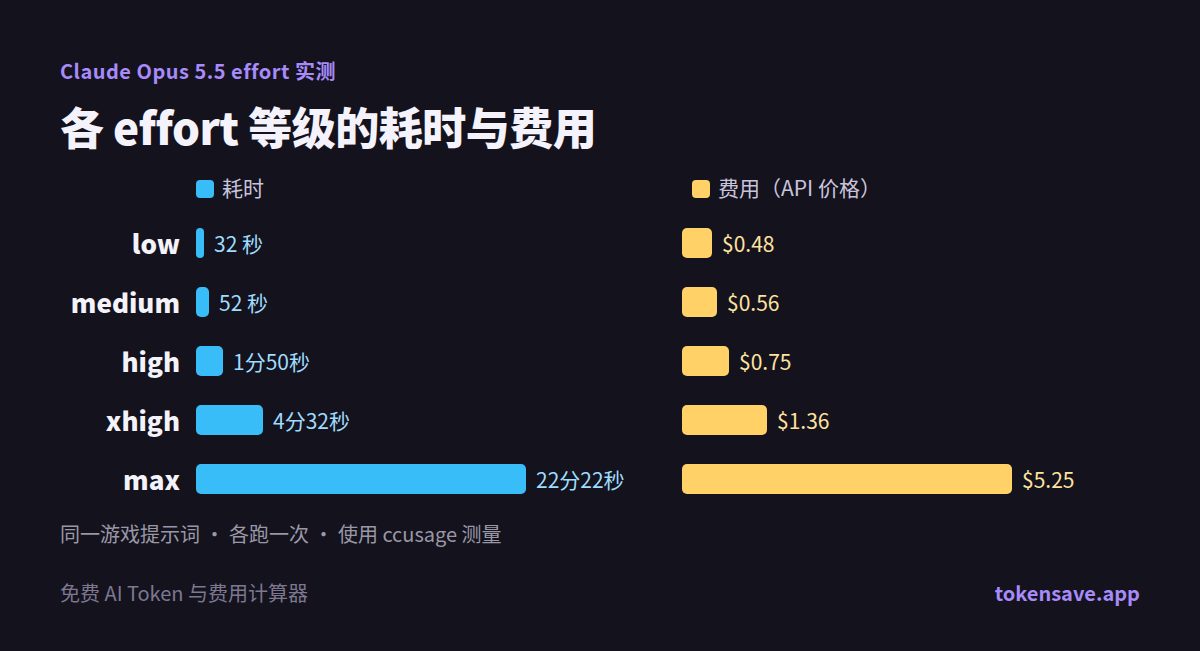
- low 和 medium 几乎没差别。 low 便宜 14%,耗时少 38%,但也就差 8 美分。
- high 只比 medium 贵 34%。 耗时从 52 秒变成 1 分 50 秒。
- 从 xhigh 开始费用跳涨。 比 medium 贵 143%,耗时 4 分 32 秒。
- max 完全是另一个量级。 medium 用了 52 秒、$0.56;max 用了 22 分 22 秒、$5.25。输出 token 从 6,299 增加到 160,033。
五个游戏横向对比
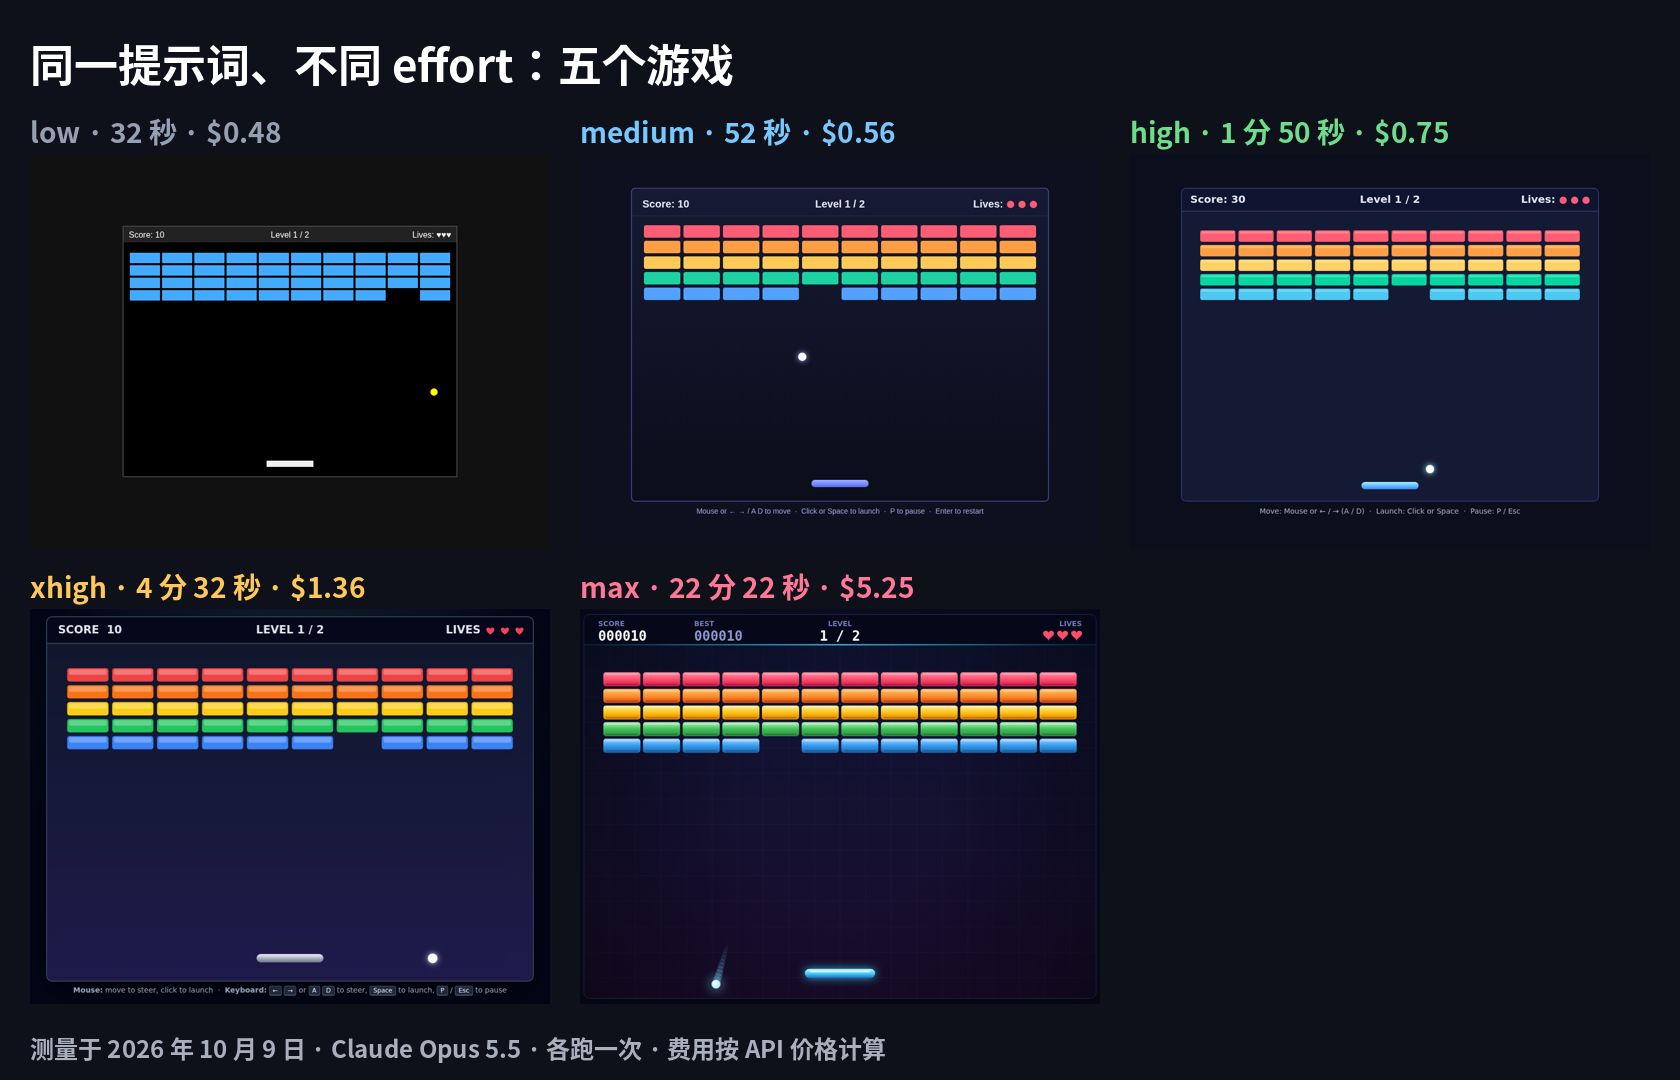
五个游戏都能正常运行、没有报错,也都满足了要求:2 个关卡、分数、3 条命、键盘和鼠标操作。区别在于各个等级额外加了什么。
| Effort | 额外加入的内容 |
|---|---|
| low | 单色砖块,画面最朴素,没有暂停 |
| medium | 彩虹砖块、暂停、重新开始 |
| high | + 粒子特效、保存最高分 |
| xhigh | 粒子特效、更精致的设计(没有保存最高分) |
| max | + 音效、关卡名称、入侵者造型的第 2 关、屏幕震动、通关烟花 |
- 从 high 开始,模型会尝试自己检查成果。 high 和 xhigh 尝试做代码语法检查,max 尝试做自动试玩测试。这三项都需要授权才能执行,所以实际上都没有运行;它们都说改为重新通读了代码。low 和 medium 没有检查就结束了。
- 需要打两下才碎的砖块 在每个等级都出现了,尽管我们并没有要求。
逐级点评
我们亲自玩了每个游戏,并对照模型最后留下的总结和代码本身进行核对。
low:32 秒,$0.48
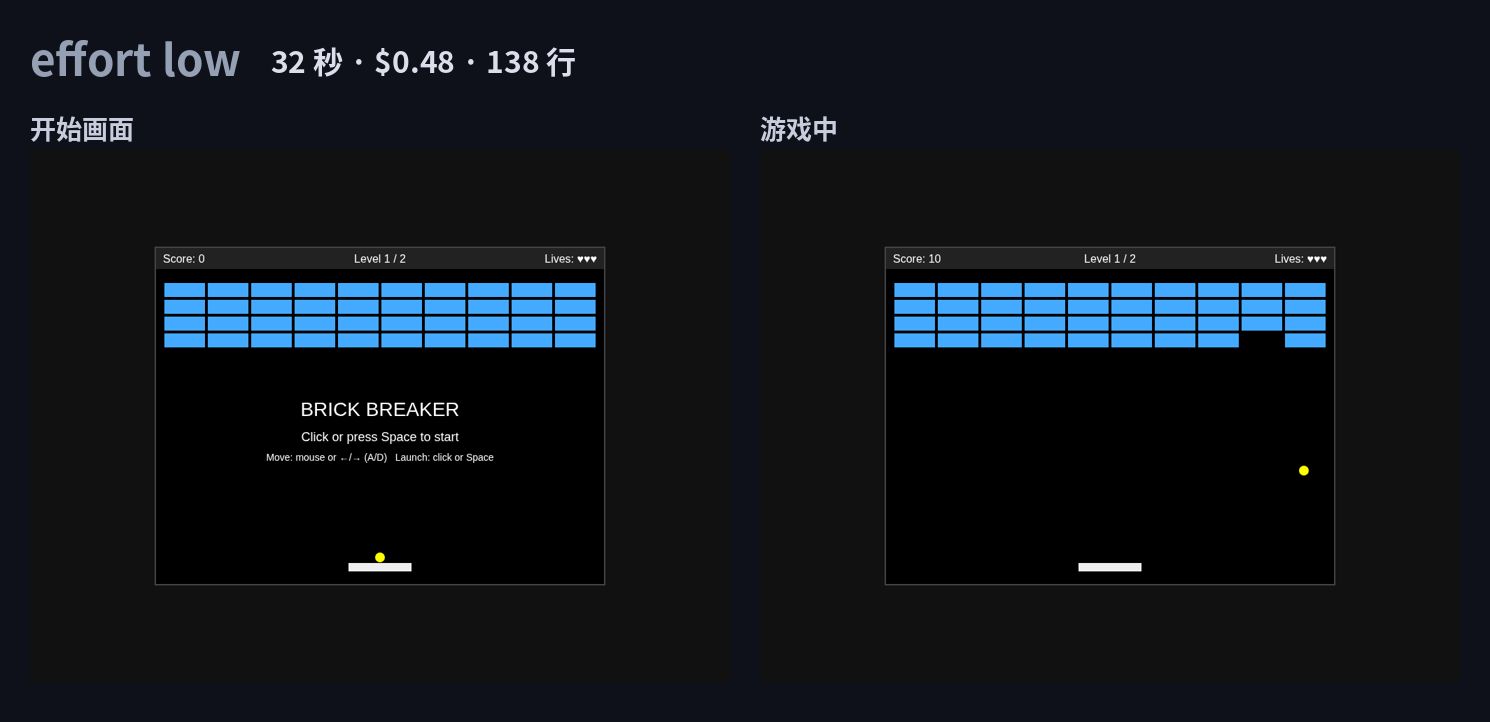
- 做出了什么: 第 1 关是四排蓝色砖块;第 2 关混入需要打两下的橙色砖块并留有空隙,球速也更快。有过关、游戏结束和胜利画面,可以重新开始。
- 优点: 要求的功能一个不少,球打在挡板不同位置时反弹角度会变化。32 秒就完成。
- 不足: 黑色背景加单色砖块,画面最朴素。没有暂停,代码只有 138 行,是最短的。
- 适用场景: 只需要先确认能不能跑通、之后再打磨的时候。
medium:52 秒,$0.56(默认)
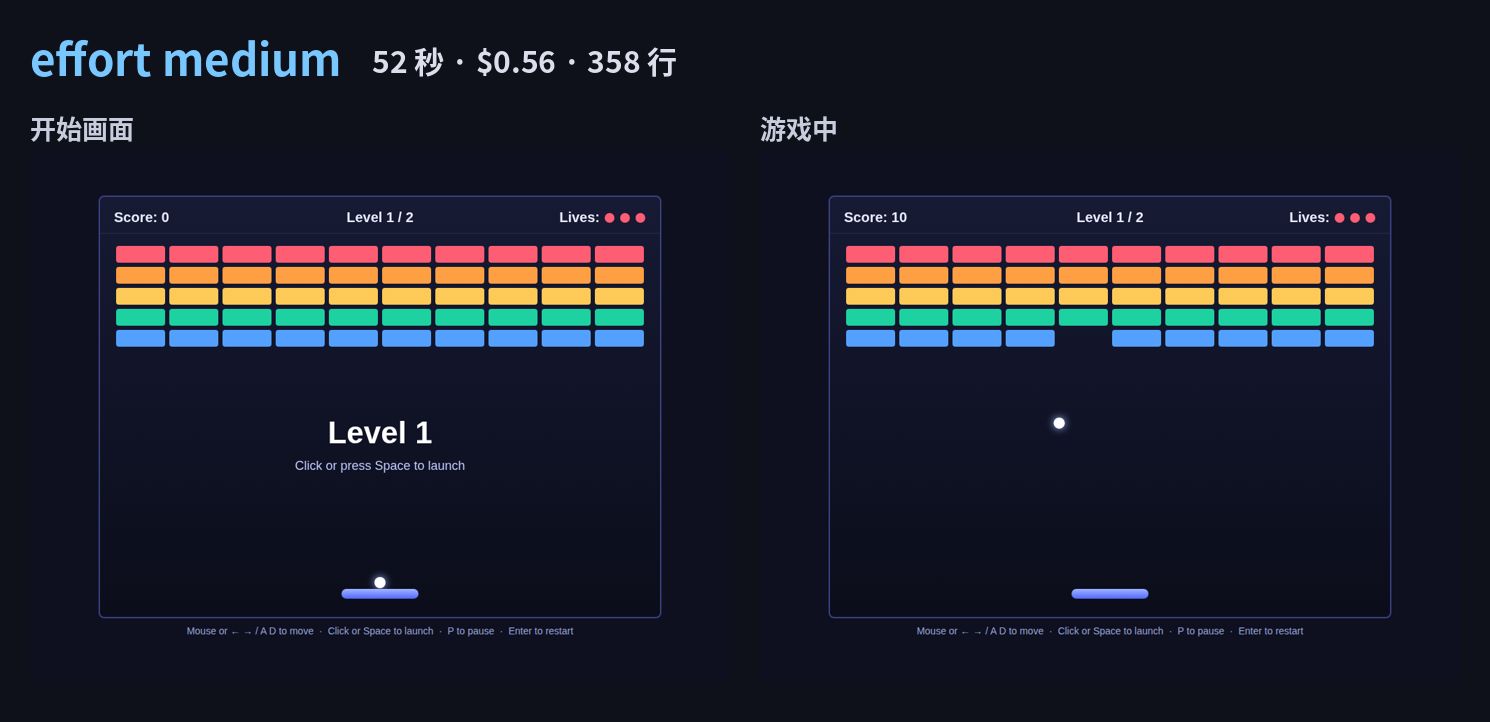
- 做出了什么: 第 1 关是 5×10 的彩虹砖块阵;第 2 关有空隙,还有需要打 2 到 3 下的砖块,会显示剩余次数,受损后颜色变淡。
- 优点: 支持暂停(P 或 Esc)、重新开始(Enter),窗口失去焦点时自动暂停。得分随砖块耐久度和关卡变化。
- 不足: 没有音效和粒子特效。
- 适用场景: 绝大多数时候。只比 low 多花 8 美分,提升却很明显。
high:1 分 50 秒,$0.75
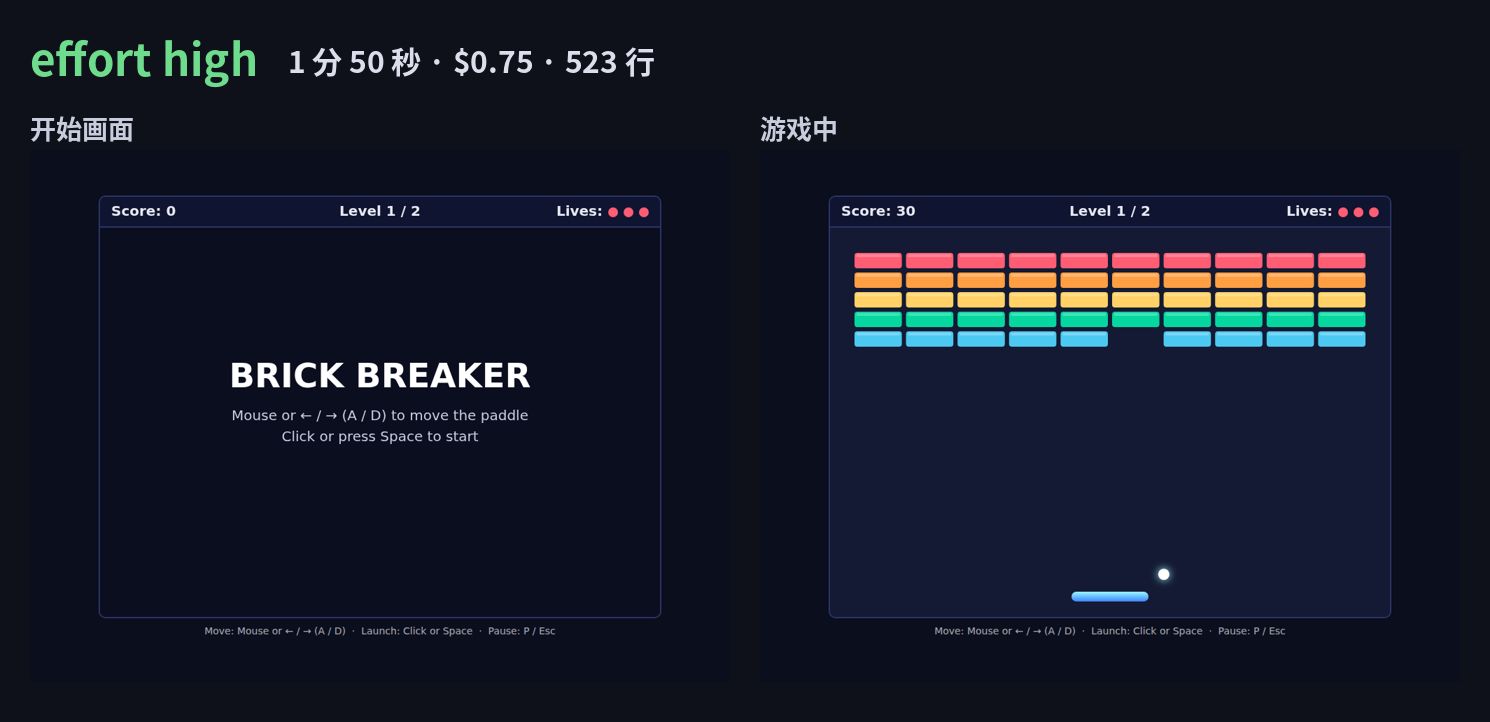
- 做出了什么: 第 2 关是由需要打 2 到 3 下的砖块组成的菱形图案,砖块碎裂时会迸出粒子。
- 优点: 有过关奖励、剩余生命奖励、保存最高分和触屏操作。它还主动尝试对自己的代码做语法检查。
- 不足: 耗时比 medium 多 112%(从 52 秒变成 1 分 50 秒)。
- 适用场景: 需要做给别人看的原型,或者重视质量的编程任务。费用只比 medium 多 34%。
xhigh:4 分 32 秒,$1.36
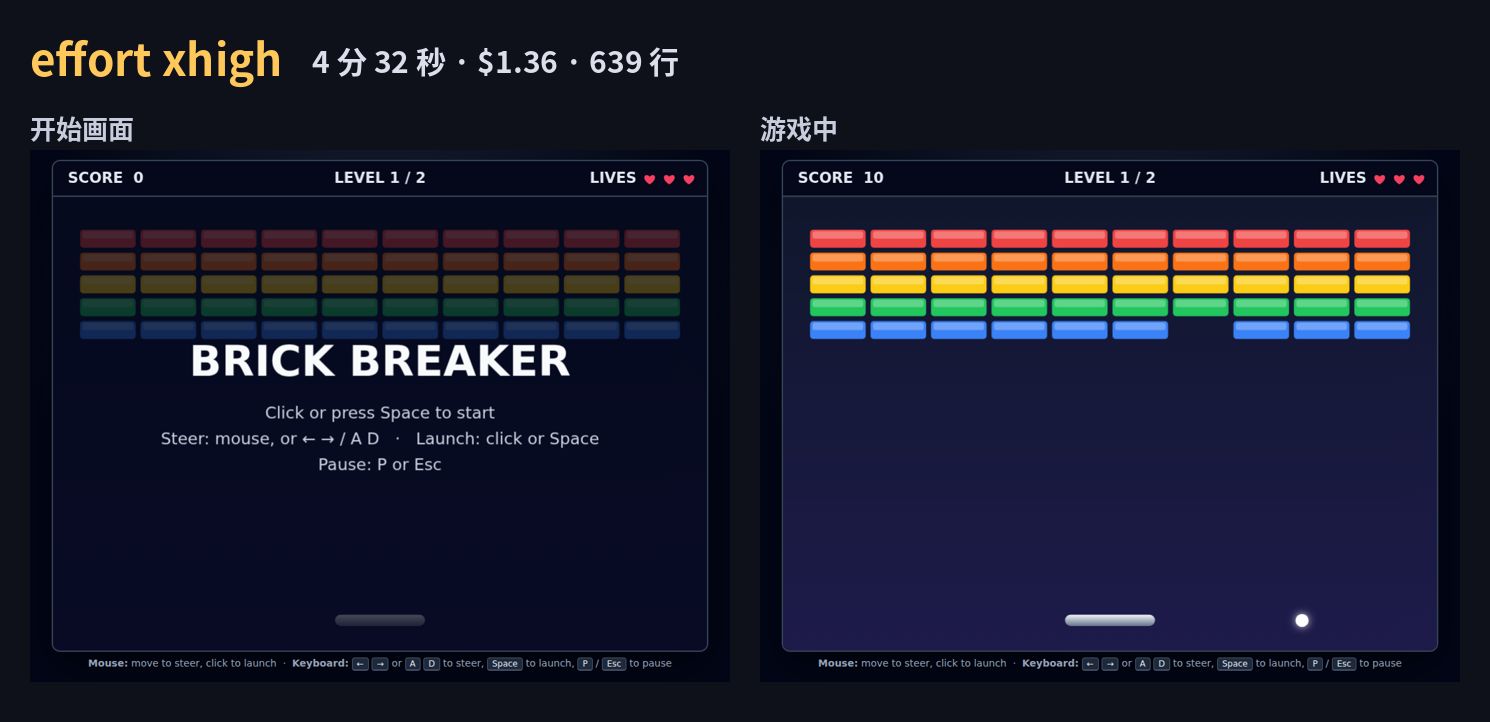
- 做出了什么: 第 2 关是一个被钢砖环绕的菱形,钢砖被打一下后会出现裂纹。砖块按颜色分值为 10 到 50 分。
- 优点: 画面最整洁,鼠标和键盘混用也很顺畅:最后使用的那个设备控制挡板。
- 不足: 去掉了 high 版本有的保存最高分和触屏操作。费用比 medium 多 143%,功能却没有超过 high。
- 适用场景: 不适合这种小任务。按照 Anthropic 的说法,它适合长时间运行的工作。
max:22 分 22 秒,$5.25
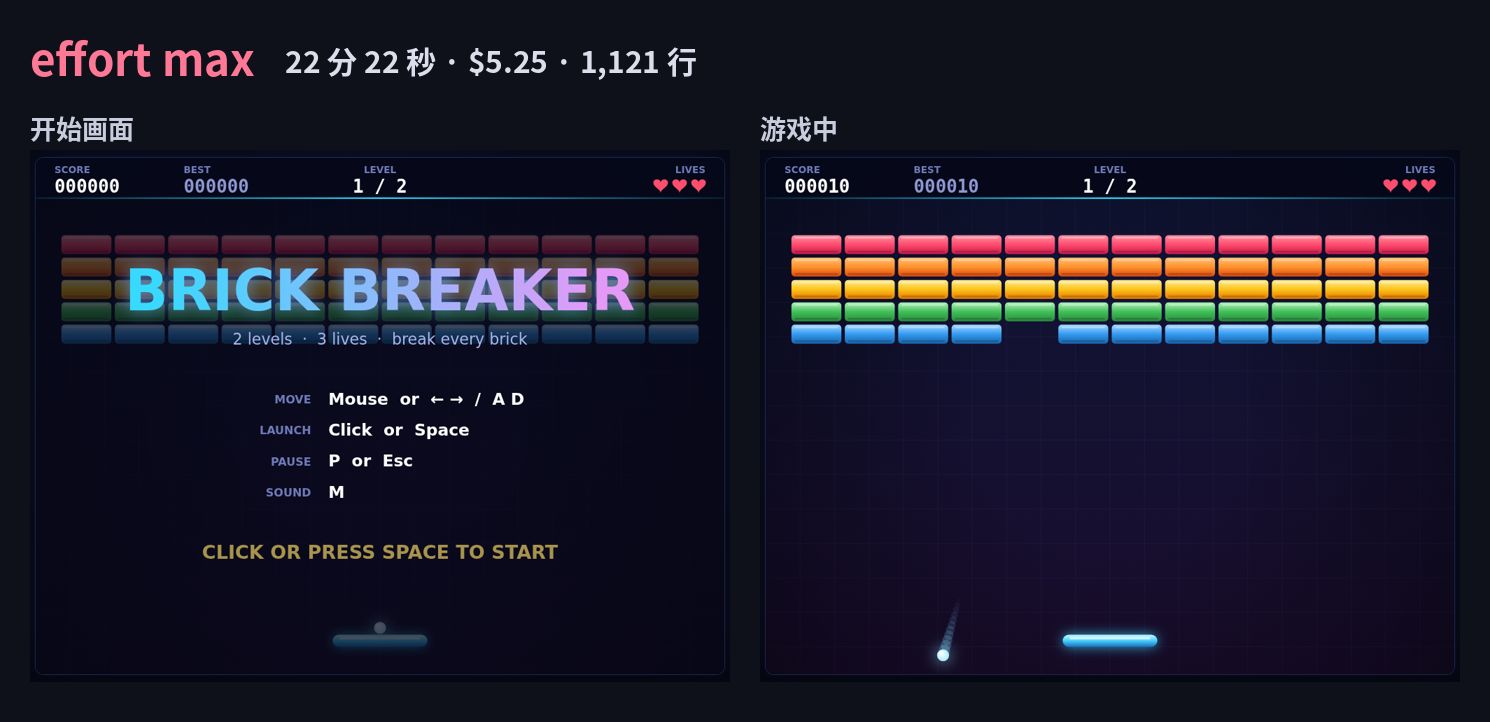
- 做出了什么: 关卡有名称("Rainbow Wall"、"Space Invader"),第 2 关是入侵者造型,其中 14 块银色砖块需要打两下,第 2 关的挡板也更窄。
- 优点: 音效(按 M 开关)、保存最高分、触屏操作、屏幕震动、通关烟花和自动暂停,是所有等级中功能最多的。看起来就像一款完成品游戏。
- 不足: 速度慢得遥遥领先,部分原因是它尝试运行需要授权的自动试玩测试。
- 适用场景: 质量最重要、时间和额度都很充裕,或者其他等级都解决不了问题的时候。
实际体验:日常用 medium,写代码用 high
我(Jaehyun)用 Claude Max 20x 套餐里的 Opus 5.5 做游戏。以下是日常使用的感受,不是测量结果。
- 我的设置: effort 保持自动。平时大多以 medium 运行,写代码时会升到 high。
- low: 感觉不太灵光,用了几次就不用了。
- high: 结果明显更好。
- xhigh 和 max: 大概各试过一次,平时很少有理由用。
和测量结果对照来看,low 实际上是最快的,但成品最朴素,所以"不太灵光"的感觉来自产出而不是速度。high 结果更好、xhigh 和 max 很少需要,这两点感受都与数据一致。
Anthropic 的建议
- medium 很强。 在 Anthropic 的测试中,medium 等级的 Opus 5.5 在编程和知识型工作上达到或超过了 high 等级的 Opus 5。
- 在编程上,low 接近 medium, 而成本低得多,这是 Anthropic 的说法。在我们的测试中,产出的差距还是很明显的。
- xhigh 和 max 只留给经过测量、确认质量有提升的工作。
- 在对话中途更改 effort 可能会使提示缓存失效。 在 API 中,可以按单条消息修改 effort 来保留缓存。
- 第三方测试结论一致。 据媒体报道,Artificial Analysis 发现 max effort 下的 Opus 5.5 每个任务使用的输出 token 比 Opus 5 多 63%。
什么任务用哪个 effort
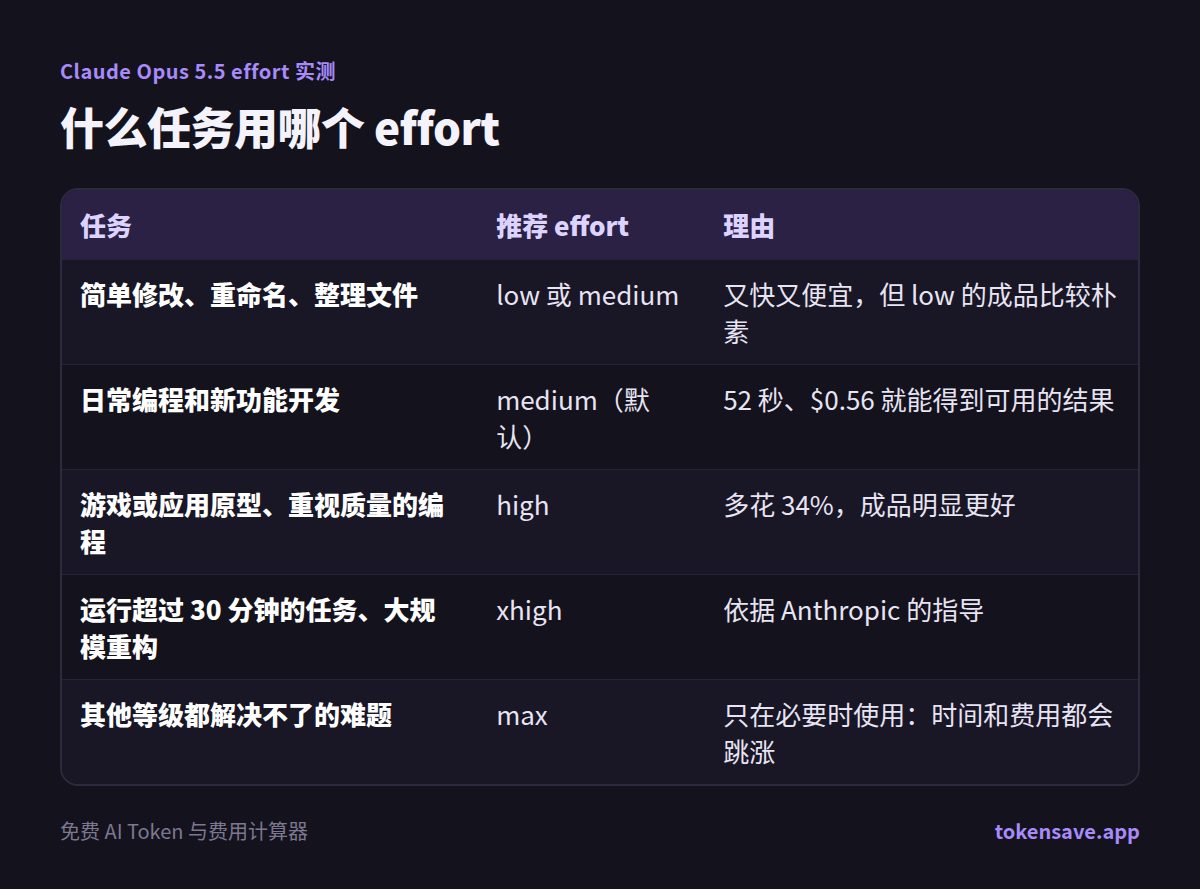
结合测量结果、Jaehyun 的使用体验和 Anthropic 的指导,我们的建议如下:
| 任务 | 推荐 effort | 理由 |
|---|---|---|
| 简单修改、重命名、整理文件 | low 或 medium | 又快又便宜,但 low 的成品比较朴素 |
| 日常编程和新功能开发 | medium(默认) | 52 秒、$0.56 就能得到可用的结果 |
| 游戏或应用原型、重视质量的编程 | high | 多花 34%,成品明显更好 |
| 运行超过 30 分钟的任务、大规模重构 | xhigh | 依据 Anthropic 的指导 |
| 其他等级都解决不了的难题 | max | 只在必要时使用:时间和费用都会跳涨 |
- 从 medium 开始。 只把结果不够好的任务升到 high。
- 用订阅套餐时,要按额度来考虑。 按 API 价格换算的费用越高,Max 或 Pro 的额度消耗得越快。一次 max 运行的消耗超过了九次 medium 运行。
- 注意: 每个等级只跑了一次,而且任务规模较小。更大的项目差距可能会不同。
结论:默认用 medium,重要时用 high
- 默认:medium。 52 秒、$0.56 就能得到可用的结果。
- 重视质量时:high。 只比 medium 多 34%,成品明显更好。五个等级中性价比最高。
- xhigh:小任务就别用了。 比 medium 多 143%,功能却没有超过 high。只有长时间运行的任务才值得。
- max:只在需要时使用。 成品最华丽,但要 22 分钟、$5.25。
- low:不推荐。 比 medium 省 8 美分,换来的只是更朴素的结果。
常见问题
Opus 5.5 的默认 effort 是什么? medium。Opus 5 的默认值是 high。没有设置 effort 的 API 请求,在 Opus 5.5 上会以 medium 运行。
max 总是更好吗? 在我们的测试中,它加入的功能和打磨最多,但用了 22 分钟、$5.25,而 medium 只用了 52 秒、$0.56。对简单工作来说太过了。
low 能省很多吗? 在我们的测试中,low 只比 medium 便宜 14%。考虑到成品更朴素,medium 是更好的选择。
算算你自己的工作
在编程智能体费用计算器中输入任务规模和每天的任务数量,即可查看使用 Opus 5.5 一个月的费用。单个提示词的费用可以用Token 计数器查看。关于 Opus 5 和 5.5 在价格与性能上的差异,请参阅 Claude Opus 5 vs 5.5(英文)。
测量于 2026 年 10 月 9 日。费用为 ccusage 按 API 价格换算的结果;随着模型和 Claude Code 的更新,结果可能会变化。
来源
- Anthropic:Effort
- Anthropic:Claude Opus 5.5 提示词指南
- Anthropic:从 Claude Opus 5 迁移到 Opus 5.5
- OfficeChai:Artificial Analysis 智能指数报道
- ccusage:Claude Code 用量统计工具(GitHub)
更多文章
输入任务规模和每天的任务数量,对比 Opus 5.5、Sonnet 5.5 和 GPT-6 Sol 一个月的费用。
打开编程智能体费用计算器 →