 TokenSave
简体中文在 GPT 中的 Token 数几乎与英文相同(1.03×)
Jonhisking · 2026-10-01
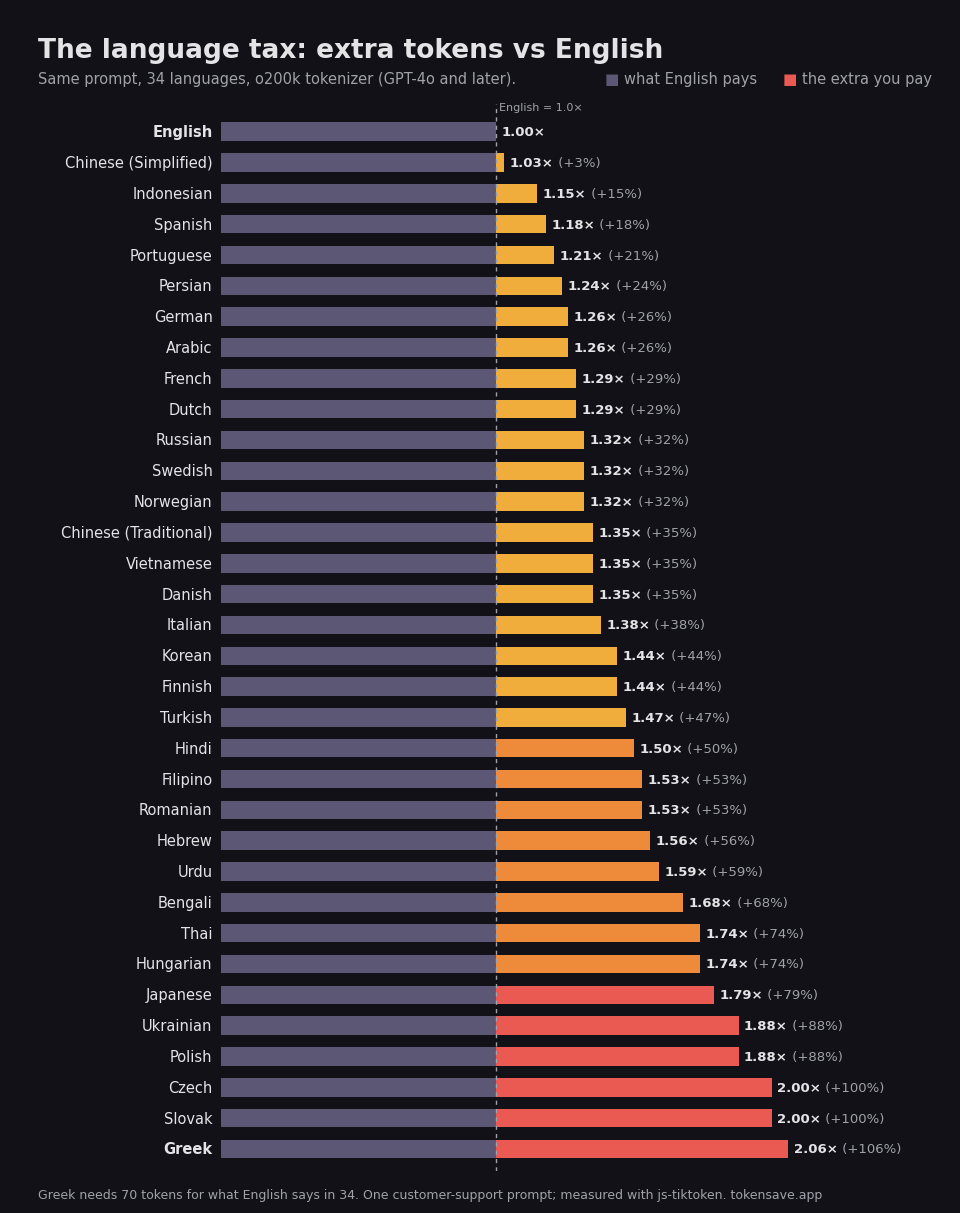
我们把同一段客服提示词翻译成 34 种语言,用 OpenAI 当前的 o200k_base 分词器(GPT-4o 及之后的模型)统计 Token。英文需要 34 个 Token,简体中文需要 35 个,是英文的 1.03×,在 34 种语言中排第 2 便宜。
简体中文版本:
请用三个要点总结下面的客户邮件,并建议一封礼貌的回复。客户说订单晚到了两天,而且箱子里少了一件商品。
结果
| 语言 | Token | 相对英文 | 旧 GPT-4 分词器 |
|---|---|---|---|
| English | 34 | 1.00× | 1.00× |
| 简体中文 | 35 | 1.03× | 1.53× |
| Español | 40 | 1.18× | 1.29× |
| Deutsch | 43 | 1.26× | 1.50× |
| 한국어 | 49 | 1.44× | 2.50× |
| 日本語 | 61 | 1.79× | 2.21× |
| Čeština | 68 | 2.00× | 2.59× |
| Ελληνικά | 70 | 2.06× | 4.94× |
为什么
分词器主要用英文数据训练,常见英文单词往往是 1 个 Token(" polite"、" customer")。o200k 词表也收录了大量常用中文词,所以简体中文几乎不吃亏:
- 请用三个要点总结下面的客户邮 →
请 | 用 | 三个 | 要 | 点 | 总结 | 下面 | 的 | 客户 | 邮· 10
与旧分词器相比
在 GPT-4 时代的 cl100k 分词器上,同一提示词是英文的 1.53×,现在是 1.03×。繁体中文仍为 1.35×,简繁差距明显。
换算成费用
按输入每 100 万 Token 2 美元计算,把这段提示词发送 100 万次:英文 $68,简体中文 $70。几乎没有差别。
省 Token 的小建议
- 固定的系统提示词可以用英文或中文,差别不大,重点是删掉重复和客套话。
- 分类、抽取、工具调用等中间步骤让模型输出 JSON,只把最终回答用中文。
- 对固定前缀使用提示词缓存(Prompt Caching),输入单价会大幅下降。
局限
- 只测了一段提示词,不同文本比例可能相差 0.1–0.2。
- Claude 和 Gemini 使用不同分词器,这些数字只适用于 OpenAI 模型。
- 译文以机器翻译为基础并经过检查。
全部 34 种语言的结果(英文):34 种语言对比
用你自己的文本测一测:中文提示词与英文相比要多少 Token 和费用。
打开 Token 计算器 →