 TokenSave
Souveraineté de l'IA : ce que ça change pour vos prompts (langue, données, coût)
Jonhisking · 3 octobre 2026
On parle beaucoup de souveraineté de l'IA en France : où sont hébergés les modèles, qui les possède, à quelles lois sont soumises les données. Ce sont des questions d'États et de grandes entreprises. Mais elles ont aussi des effets très concrets pour quiconque écrit un prompt : dans quelle langue on paie, où part le texte, et de qui dépend la facture.
J'ai mesuré la partie qui se chiffre : la langue.
1. La langue : le français paie un supplément, même chez Mistral
Les tokeniseurs, qui découpent le texte en tokens facturés, sont entraînés sur des corpus où l'anglais domine. Résultat : le même contenu coûte plus de tokens en français.
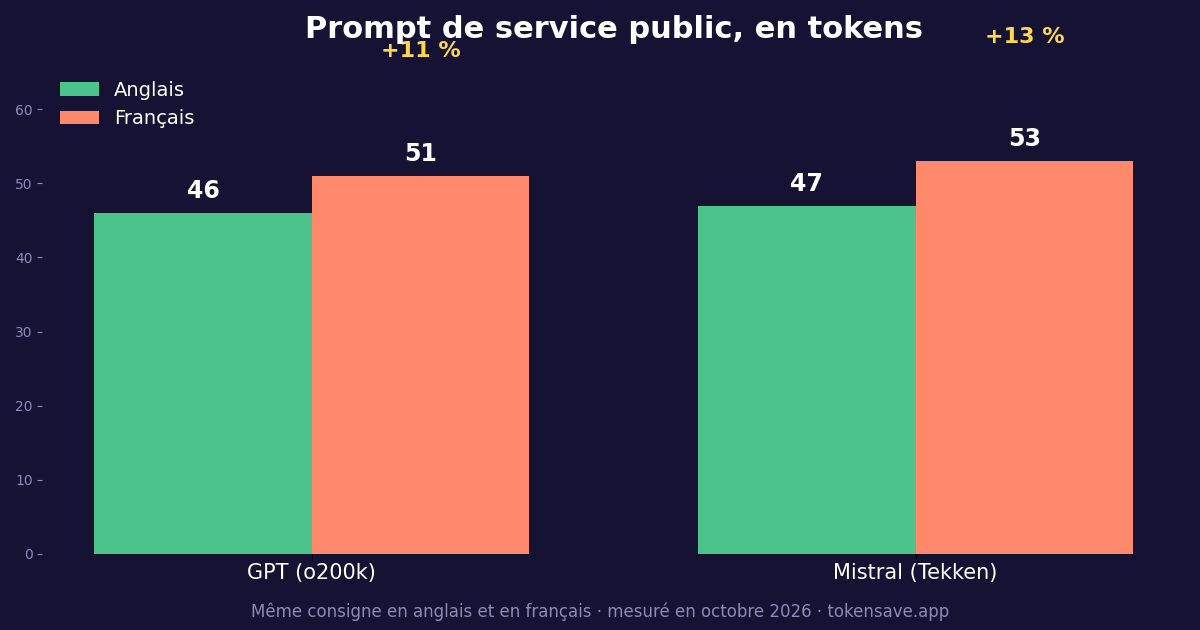
J'ai écrit une consigne typique d'un assistant de service public, en français et en anglais, avec exactement le même sens :
Tu es un assistant pour un service public. Résume la demande de l'usager ci-dessous en trois points, indique quel service administratif est compétent et rédige une réponse claire, polie et sans jargon. Ne demande jamais de données personnelles supplémentaires.
| Texte | Tokeniseur | Anglais | Français | Surcoût |
|---|---|---|---|---|
| Consigne de service public | GPT (o200k) | 46 | 51 | +11 % |
| Consigne de service public | Mistral (Tekken) | 47 | 53 | +13 % |
| E-mail de compte rendu | GPT (o200k) | 165 | 199 | +21 % |
| E-mail de compte rendu | Mistral (Tekken) | 170 | 206 | +21 % |
Le modèle français ne découpe pas le français plus efficacement que le modèle américain : sur ces textes, il produit même un peu plus de tokens. Choisir un fournisseur européen est une décision sur l'hébergement et le droit applicable ; ça ne supprime pas le surcoût linguistique.
Ce surcoût reste modéré pour le français (de l'ordre de 10 à 30 % selon le texte), bien moins que pour le polonais (50 à 88 % de plus) ou le grec (environ deux fois l'anglais). Mais à l'échelle d'une administration ou d'une entreprise qui envoie des millions de requêtes, il se voit sur la facture.
2. Les données : où part votre prompt ?
Chaque prompt envoyé à un service d'IA en ligne quitte votre ordinateur. La question de souveraineté, c'est de savoir sous quelles lois il se retrouve. Le Cloud Act américain (2018) permet aux autorités américaines de demander à un fournisseur américain des données qu'il contrôle, même si elles sont stockées hors des États-Unis. C'est l'argument principal de ceux qui recommandent des fournisseurs et des hébergements européens pour les données sensibles.
Pour un utilisateur, plusieurs options existent, de la plus simple à la plus exigeante :
- Ne pas envoyer ce qui n'est pas nécessaire. Retirer noms, adresses et numéros avant de coller un document réduit l'exposition et le nombre de tokens.
- Choisir l'hébergement : plusieurs fournisseurs proposent des offres hébergées dans l'Union européenne pour les entreprises.
- Faire tourner un modèle en local. Certains modèles sont publiés en « poids ouverts » (Mistral en publie plusieurs) et peuvent s'exécuter sur vos propres machines : le texte ne sort pas du tout.
- Utiliser des outils qui travaillent dans le navigateur. Compter des tokens ou traduire un prompt ne nécessite pas d'envoyer le texte à un serveur.
3. Le coût : dépendre d'un tarif qu'on ne fixe pas
Les grands modèles sont facturés en dollars, au million de tokens, avec des prix qui changent souvent. Être dépendant d'un seul fournisseur, c'est subir ses changements de tarifs et de limites. Le meilleur moyen de garder la main est de mesurer sa consommation en tokens : avec ce chiffre, on peut comparer les fournisseurs, estimer le coût d'une migration et choisir un modèle européen ou américain en connaissant le prix réel, et pas seulement le prix affiché.
4. Le cadre réglementaire : où en est l'AI Act ?
Le règlement européen sur l'IA s'applique par étapes. Selon les informations disponibles début octobre 2026 :
- depuis le 2 août 2026, les obligations de transparence de l'article 50 s'appliquent (par exemple informer les personnes qu'elles interagissent avec une IA) ;
- le paquet « Digital Omnibus », adopté par le Parlement le 16 juin et par le Conseil le 29 juin 2026, reporte les obligations des systèmes à haut risque au 2 décembre 2027 (systèmes autonomes) et au 2 août 2028 (IA intégrée à des produits déjà réglementés).
Ce résumé n'est pas un avis juridique : pour un projet précis, vérifiez auprès d'un juriste.
Check-list pour un usage plus souverain de l'IA
- Classez vos textes : publics, internes, sensibles. Seuls les derniers justifient un hébergement européen ou local.
- Anonymisez avant d'envoyer, et ne collez que ce qui est utile.
- Mesurez vos tokens pour connaître votre coût réel et pouvoir comparer les offres.
- Écrivez les consignes répétées en anglais (prompts système, instructions d'automatisation) et ajoutez « Reply in French. » : la réponse reste en français, le prompt coûte moins cher.
- Gardez une porte de sortie : des prompts simples et un format de données neutre (CSV, JSON compact) facilitent le passage d'un modèle à un autre.
Mesurer sans rien envoyer
TokenSave compte les tokens et estime le coût de votre prompt pour GPT, Claude et Gemini directement dans votre navigateur : votre texte n'est envoyé à aucun serveur. Le bouton 💸 Économiser des tokens le traduit en anglais avec le traducteur intégré à Chrome ou Edge, sur votre propre appareil, et ajoute « Reply in French. ». Gratuit, sans inscription.
À lire aussi : Mistral ou ChatGPT : combien coûte vraiment un prompt en français ? et Pourquoi utiliser un compteur de tokens ?
Mesures effectuées en octobre 2026 avec o200k_base (OpenAI) et Tekken 2024-09 (Mistral). Les modèles Mistral les plus récents peuvent utiliser une version mise à jour de Tekken.
Comptez les tokens et le coût de votre prompt sans rien envoyer : tout se passe dans votre navigateur.
Ouvrir le compteur de tokens →