 TokenSave
Le français consomme 1,29× plus de tokens que l’anglais dans GPT
Jonhisking · 2026-10-01
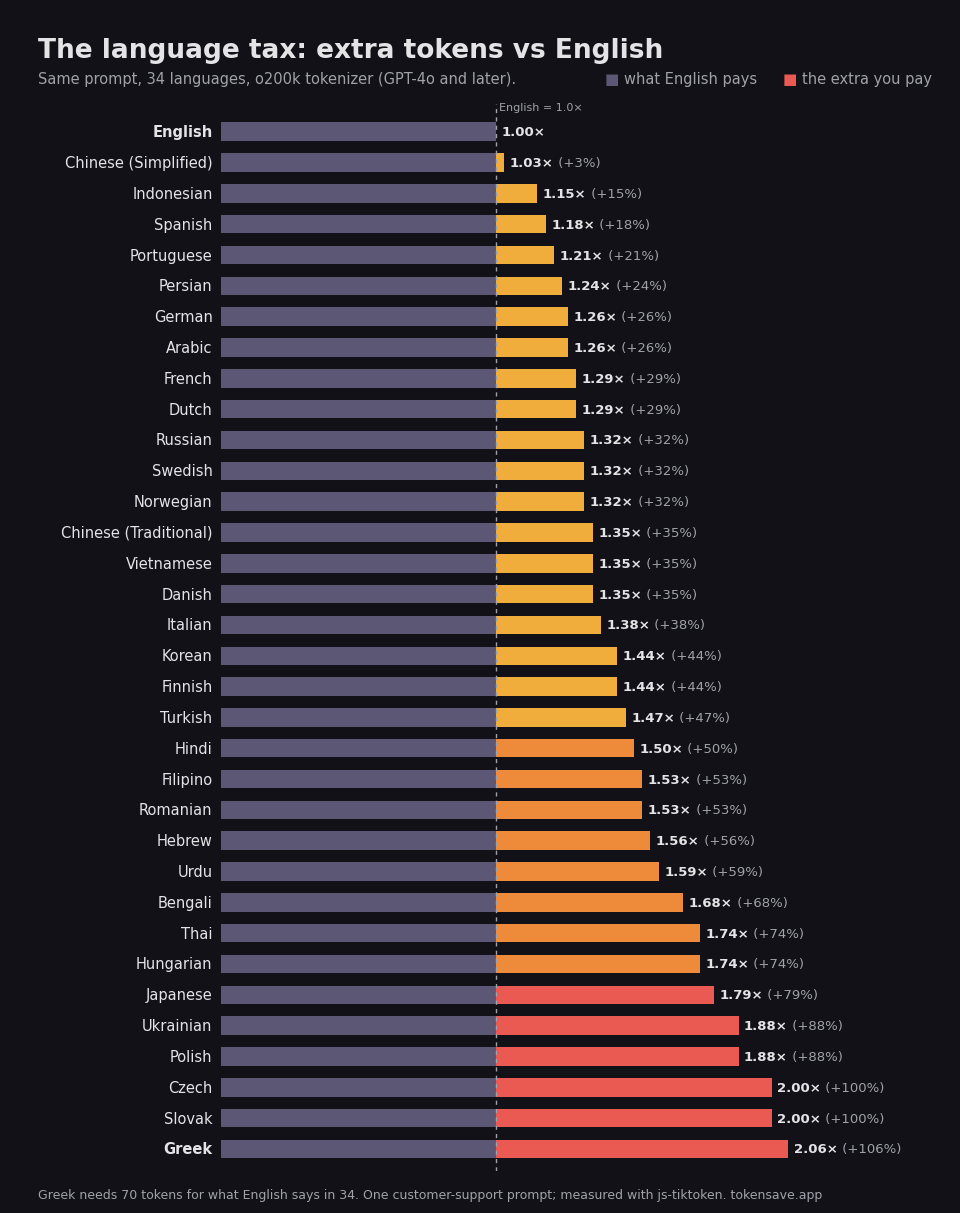
J’ai traduit le même prompt de service client dans 34 langues et compté les tokens avec o200k_base, le tokeniseur actuel d’OpenAI (GPT-4o et suivants). L’anglais demande 34 tokens ; le français 44, soit 1,29× l’anglais, rang 9 sur 34 (1 = le moins cher).
La version française :
Résumez l'e-mail du client ci-dessous en trois points et proposez une réponse polie. Le client indique que la commande est arrivée avec deux jours de retard et qu'un article manquait dans le colis.
Résultats
| Langue | Tokens | Par rapport à l’anglais | Ancien tokeniseur GPT-4 |
|---|---|---|---|
| English | 34 | 1,00× | 1,00× |
| 简体中文 | 35 | 1,03× | 1,53× |
| Español | 40 | 1,18× | 1,29× |
| Deutsch | 43 | 1,26× | 1,50× |
| Français | 44 | 1,29× | 1,44× |
| 한국어 | 49 | 1,44× | 2,50× |
| 日本語 | 61 | 1,79× | 2,21× |
| Čeština | 68 | 2,00× | 2,59× |
| Ελληνικά | 70 | 2,06× | 4,94× |
Pourquoi
Le tokeniseur apprend surtout sur du texte anglais : des mots comme « polite » ou « customer » tiennent en un seul token, alors que beaucoup de mots français sont découpés en morceaux :
- Résumez →
Rés | ume | z· 3 - ci-dessous →
ci | -dessous· 2 - proposez →
propose | z· 2
Par rapport à l’ancien tokeniseur
Avec le tokeniseur de l’époque GPT-4 (cl100k), le même prompt coûtait 1,44× ; aujourd’hui 1,29×.
En argent
Avec un modèle à 2 $ le million de tokens d’entrée, envoyer ce prompt un million de fois coûte 68 $ en anglais et 88 $ en français. Si la réponse est aussi en français, le même multiplicateur s’applique aux tokens de sortie, généralement 4 à 5× plus chers.
Comment économiser
- Rédigez le prompt système et les consignes fixes en anglais ; gardez en français seulement ce que saisit l’utilisateur.
- Demandez les étapes intermédiaires (classification, extraction, appels d’outils) en anglais ou en JSON, et seule la réponse finale en français.
- Utilisez le prompt caching pour la partie fixe du prompt.
Limites
- Un seul prompt mesuré ; selon le texte, le ratio peut varier de ±0,1–0,2.
- Claude et Gemini utilisent d’autres tokeniseurs : ces chiffres ne valent que pour les modèles OpenAI.
- La traduction repose sur une traduction automatique relue.
Résultats complets des 34 langues (en anglais) : comparaison de 34 langues
Mesurez votre propre texte : combien de tokens et d’argent coûte votre prompt en français par rapport à l’anglais.
Ouvrir le compteur de tokens →