 TokenSave
Claude Opus 5.5 : les niveaux d'effort testés, de low à max
Jonhisking · 9 octobre 2026
Claude Opus 5.5 dispose d'un réglage effort qui détermine la profondeur de sa réflexion, avec cinq niveaux : low, medium, high, xhigh et max. Plus le niveau est élevé, meilleur le résultat est censé être, mais la documentation officielle ne chiffre ni le temps ni l'argent supplémentaires qu'exige chaque niveau. Le 9 octobre 2026, nous avons donc lancé la même demande de création de jeu à chaque niveau, avec un seul essai par niveau, puis comparé le temps, les tokens, le coût et le résultat. Le niveau le plus rapide a pris 32 secondes, le plus lent 22 minutes. Voici ce qui change d'un niveau à l'autre et quel niveau choisir selon la tâche, avec en prime un retour d'expérience.
Ce qu'est l'effort
- Il règle la quantité de réflexion du modèle. Sur Opus 5.5, la réflexion ne peut pas être désactivée ; l'effort en contrôle la profondeur. Les tokens de réflexion sont facturés comme des tokens de sortie.
- La valeur par défaut est medium. Opus 5 était réglé sur high par défaut ; Opus 5.5 descend d'un cran, à medium (selon la documentation d'Anthropic).
- Comment le modifier : dans Claude Code, avec l'option
--effort(de low à max) ; dans l'API, avec le paramètreeffort.
Notre méthode de mesure
- Modèle : Claude Opus 5.5 dans Claude Code, sur un PC Windows
- Prompt (tel quel) : "Make a brick-breaker game that runs in the browser as a single file named index.html in the current folder. It needs 2 levels, a score display and 3 lives, and it must be playable with the keyboard and the mouse. Write the file and finish." Il demande un casse-briques jouable dans le navigateur, en un seul fichier index.html, avec 2 niveaux, un score, 3 vies et des commandes au clavier et à la souris.
- Méthode : le même prompt lancé à cinq reprises, seul l'effort change. Chaque niveau a tourné dans son propre dossier pour que les essais ne s'influencent pas.
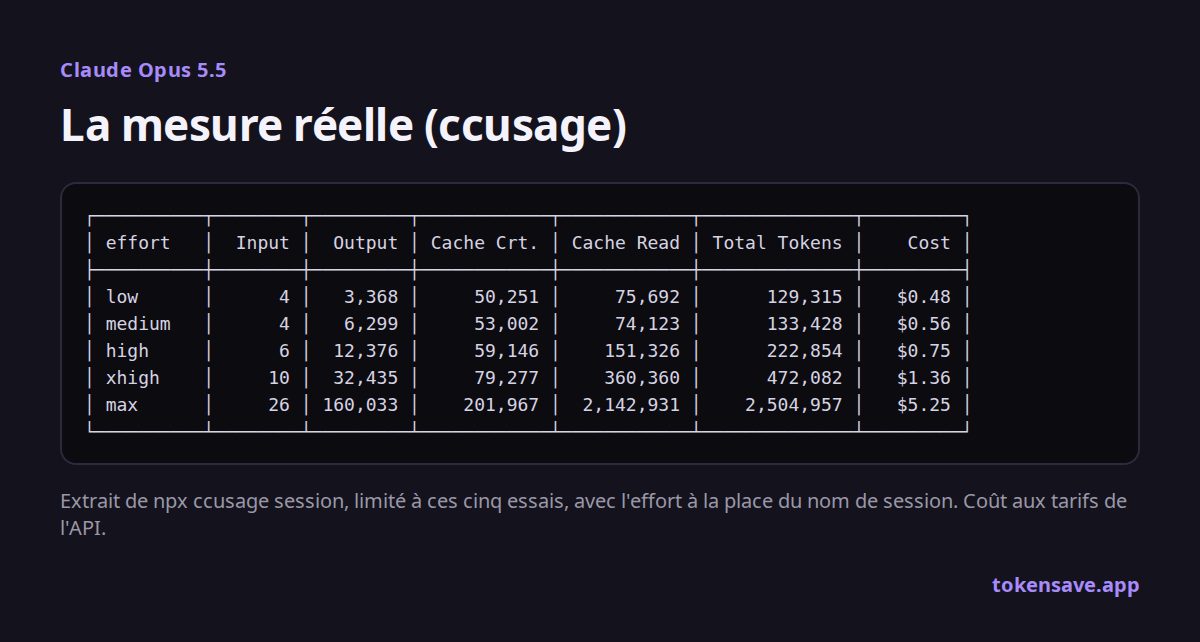
- Mesure : tokens et coût avec l'outil gratuit ccusage, durée calculée à partir des horodatages de début et de fin. Le coût est converti aux tarifs de l'API.
Résultats : temps, tokens et coût
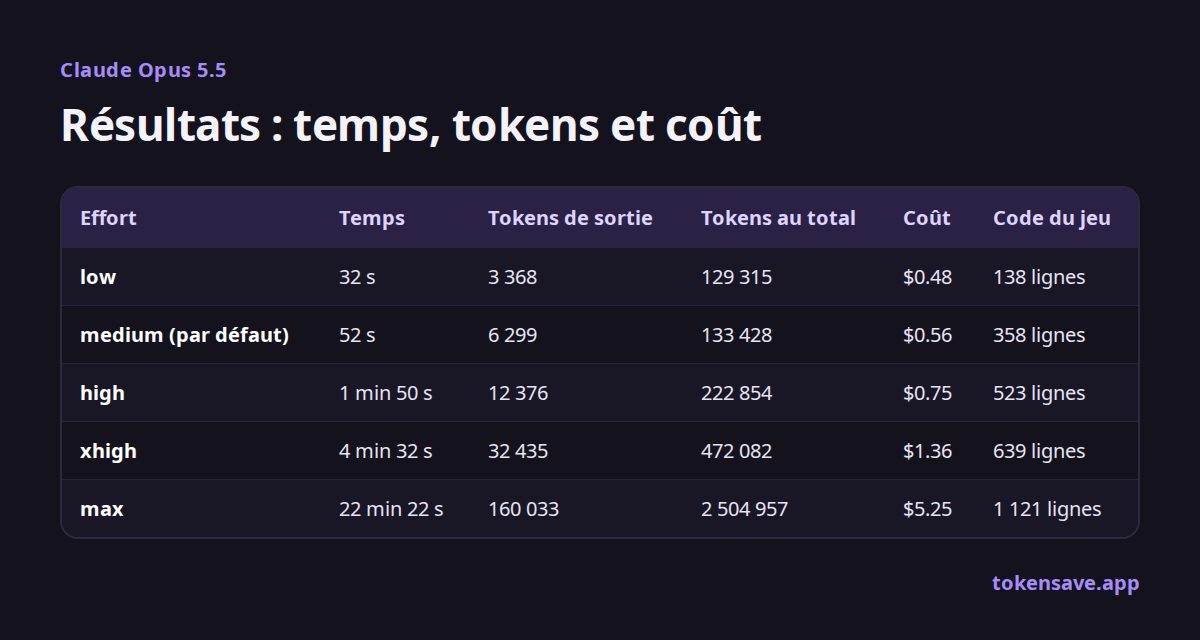
| Effort | Temps | Tokens de sortie | Tokens au total | Coût | Code du jeu |
|---|---|---|---|---|---|
| low | 32 s | 3 368 | 129 315 | $0.48 | 138 lignes |
| medium (par défaut) | 52 s | 6 299 | 133 428 | $0.56 | 358 lignes |
| high | 1 min 50 s | 12 376 | 222 854 | $0.75 | 523 lignes |
| xhigh | 4 min 32 s | 32 435 | 472 082 | $1.36 | 639 lignes |
| max | 22 min 22 s | 160 033 | 2 504 957 | $5.25 | 1 121 lignes |
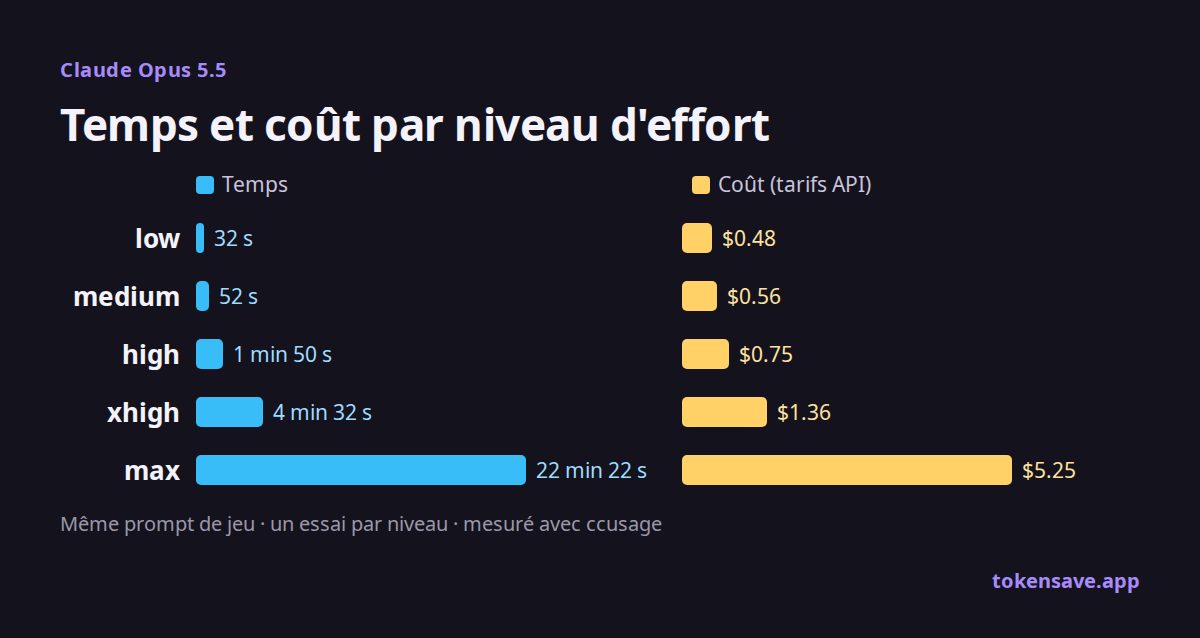
- Low et medium se valent presque. Low a coûté 14 % de moins et pris 38 % de temps en moins, mais l'écart n'est que de 8 cents.
- High n'a coûté que 34 % de plus que medium. Le temps est passé de 52 secondes à 1 minute 50 secondes.
- C'est avec xhigh que les coûts s'envolent. Il a coûté 143 % de plus que medium et pris 4 minutes 32 secondes.
- Max joue dans une autre catégorie. Medium a pris 52 secondes pour $0.56 ; max a pris 22 minutes 22 secondes pour $5.25. Les tokens de sortie sont passés de 6 299 à 160 033.
Les cinq jeux côte à côte
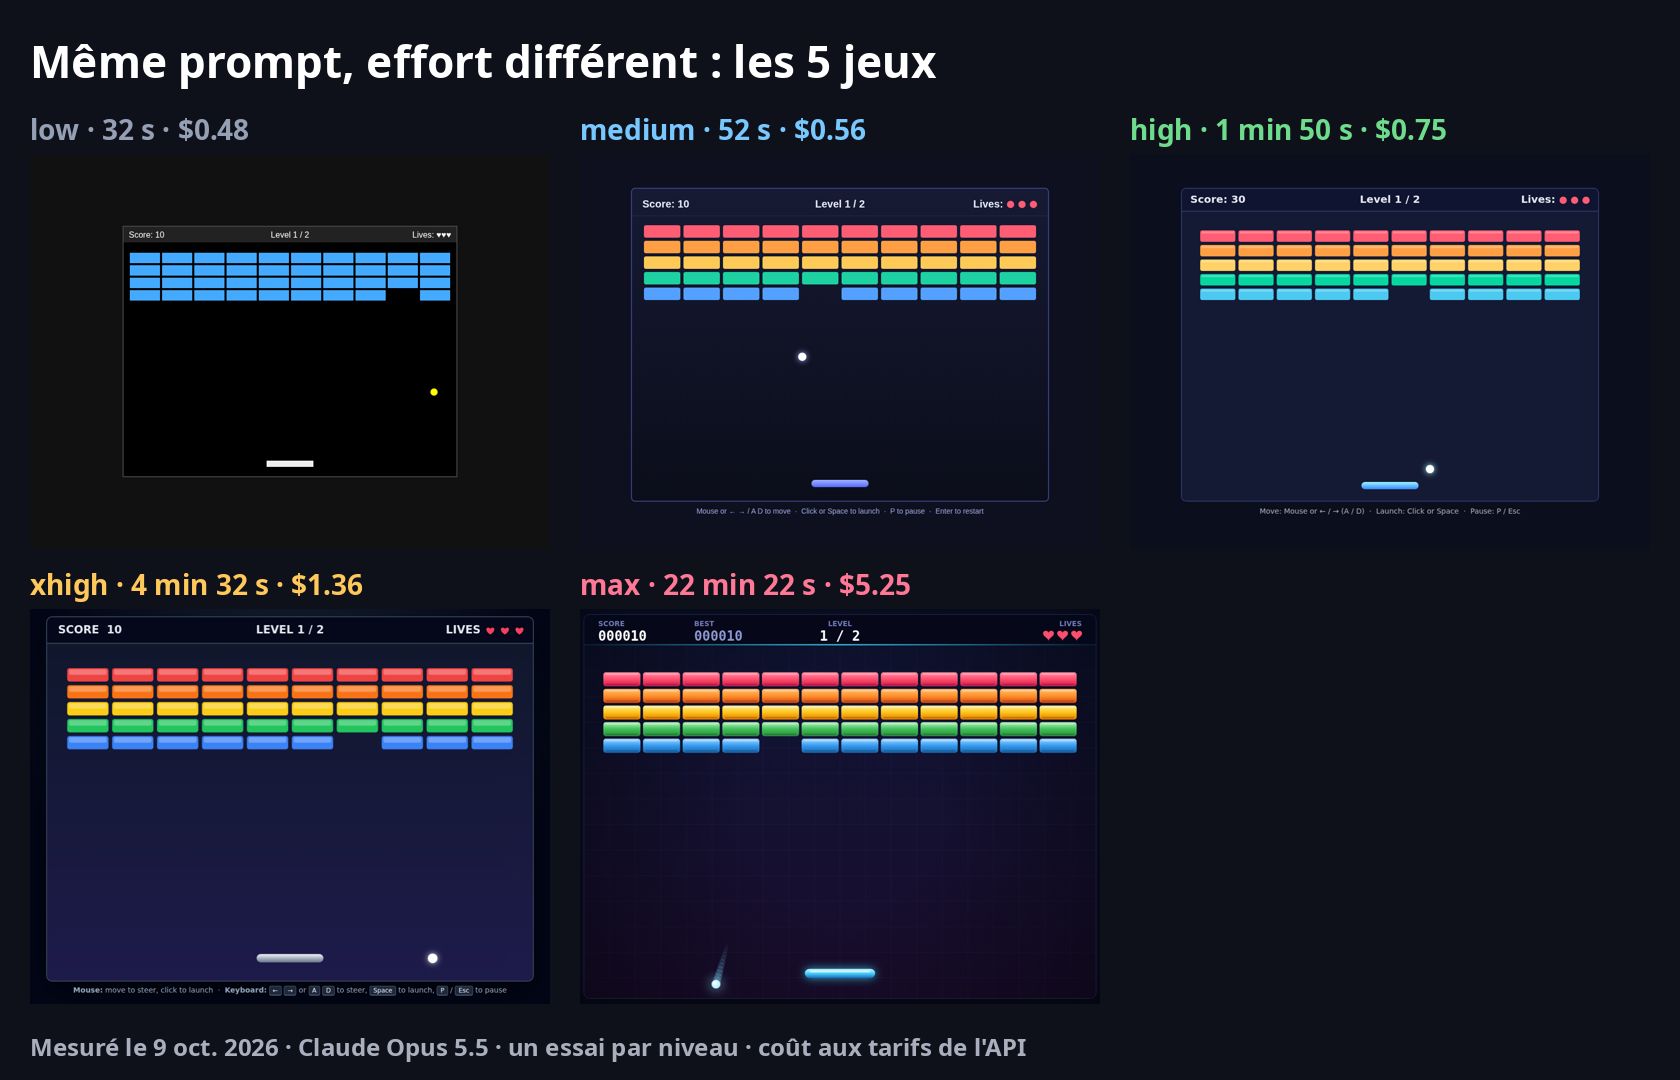
Les cinq jeux ont fonctionné sans erreur et respectent la demande : 2 niveaux, un score, 3 vies, des commandes au clavier et à la souris. Les différences tiennent à ce que chaque niveau a ajouté en plus.
| Effort | Ce qu'il a ajouté |
|---|---|
| low | Briques d'une seule couleur, l'écran le plus dépouillé, pas de pause |
| medium | Briques arc-en-ciel, pause, redémarrage |
| high | + effets de particules, meilleur score sauvegardé |
| xhigh | Effets de particules, design plus soigné (pas de meilleur score sauvegardé) |
| max | + effets sonores, noms de niveaux, un niveau 2 en forme d'envahisseur, tremblement d'écran, feu d'artifice de victoire |
- À partir de high, le modèle a tenté de vérifier son propre travail. High et xhigh ont tenté une vérification de la syntaxe du code, et max un test de jeu automatisé. Les trois demandaient une autorisation pour s'exécuter, donc aucun n'a réellement tourné ; chacun indique avoir relu le code à la place. Low et medium ont terminé sans vérification.
- Des briques qui résistent à deux coups sont apparues à tous les niveaux, alors que nous ne les avions pas demandées.
Revue niveau par niveau
Nous avons joué à chaque jeu et l'avons comparé au résumé laissé par le modèle à la fin ainsi qu'au code lui-même.
low : 32 s, $0.48
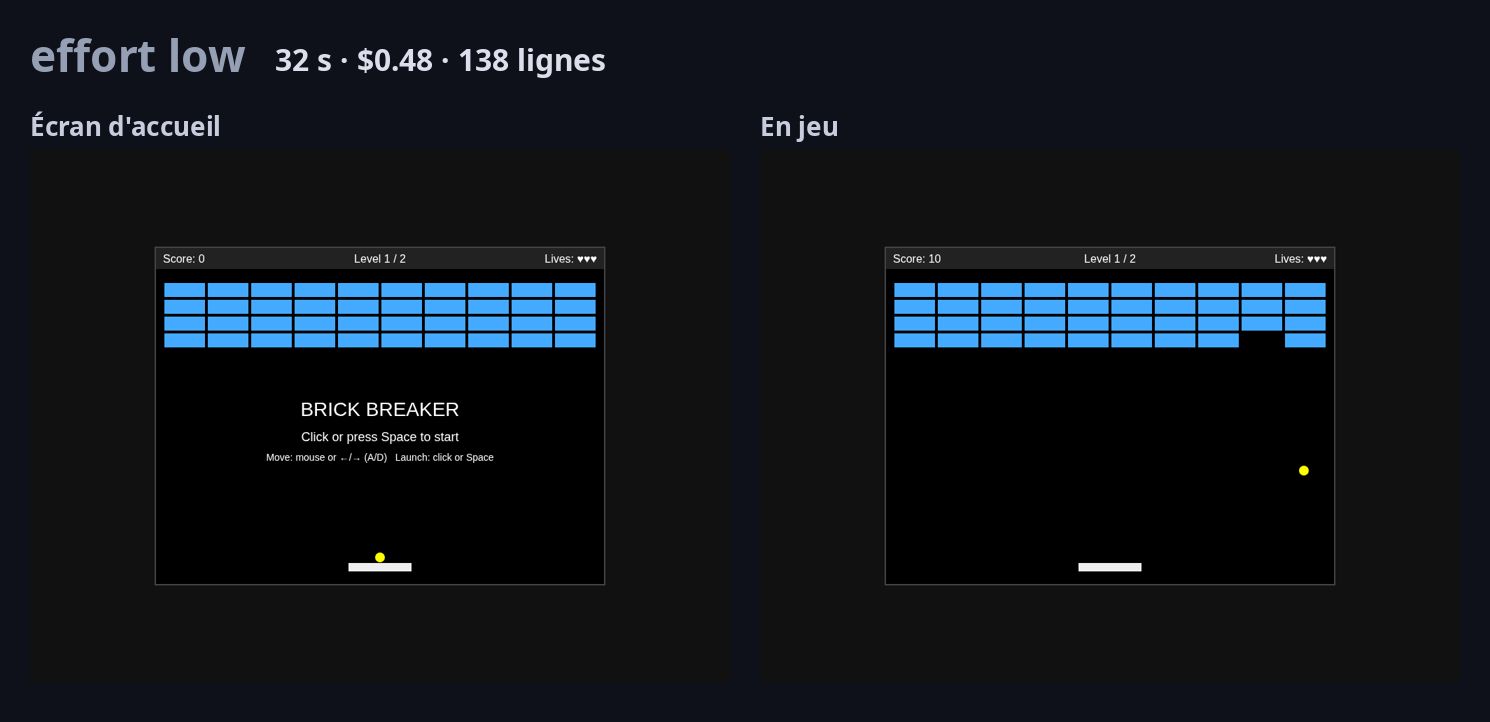
- Ce qu'il a construit : le niveau 1 compte quatre rangées de briques bleues ; le niveau 2 mélange des briques orange qui résistent à deux coups et des espaces vides, avec une balle plus rapide. Il y a des écrans de niveau terminé, de game over et de victoire, ainsi qu'un redémarrage.
- Points forts : toutes les fonctionnalités demandées sont là, et l'angle de la balle dépend de l'endroit où elle touche la raquette. Terminé en 32 secondes.
- Points faibles : fond noir et briques d'une seule couleur, c'est le plus dépouillé. Pas de pause, et avec 138 lignes, c'est le code le plus court.
- À utiliser quand : vous voulez juste vérifier que quelque chose fonctionne et comptez peaufiner plus tard.
medium : 52 s, $0.56 (par défaut)
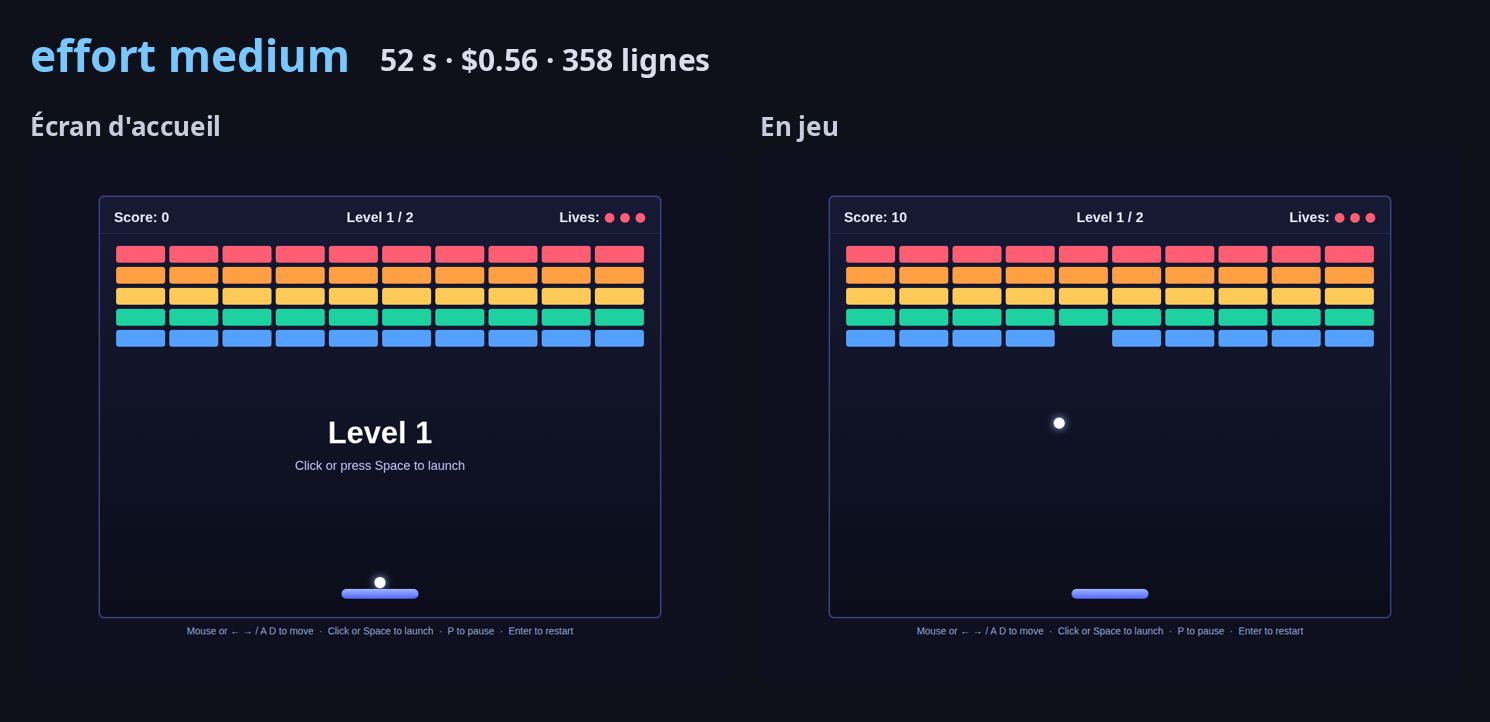
- Ce qu'il a construit : le niveau 1 est une grille arc-en-ciel 5×10 ; le niveau 2 comporte des espaces vides et des briques qui résistent à 2 ou 3 coups, affichent les coups restants et pâlissent à mesure qu'elles sont touchées.
- Points forts : pause (P ou Échap), redémarrage (Entrée) et pause automatique quand la fenêtre perd le focus. Le score dépend de la solidité des briques et du niveau.
- Points faibles : ni sons ni effets de particules.
- À utiliser quand : la plupart du temps. Il coûte 8 cents de plus que low et marque un net progrès.
high : 1 min 50 s, $0.75
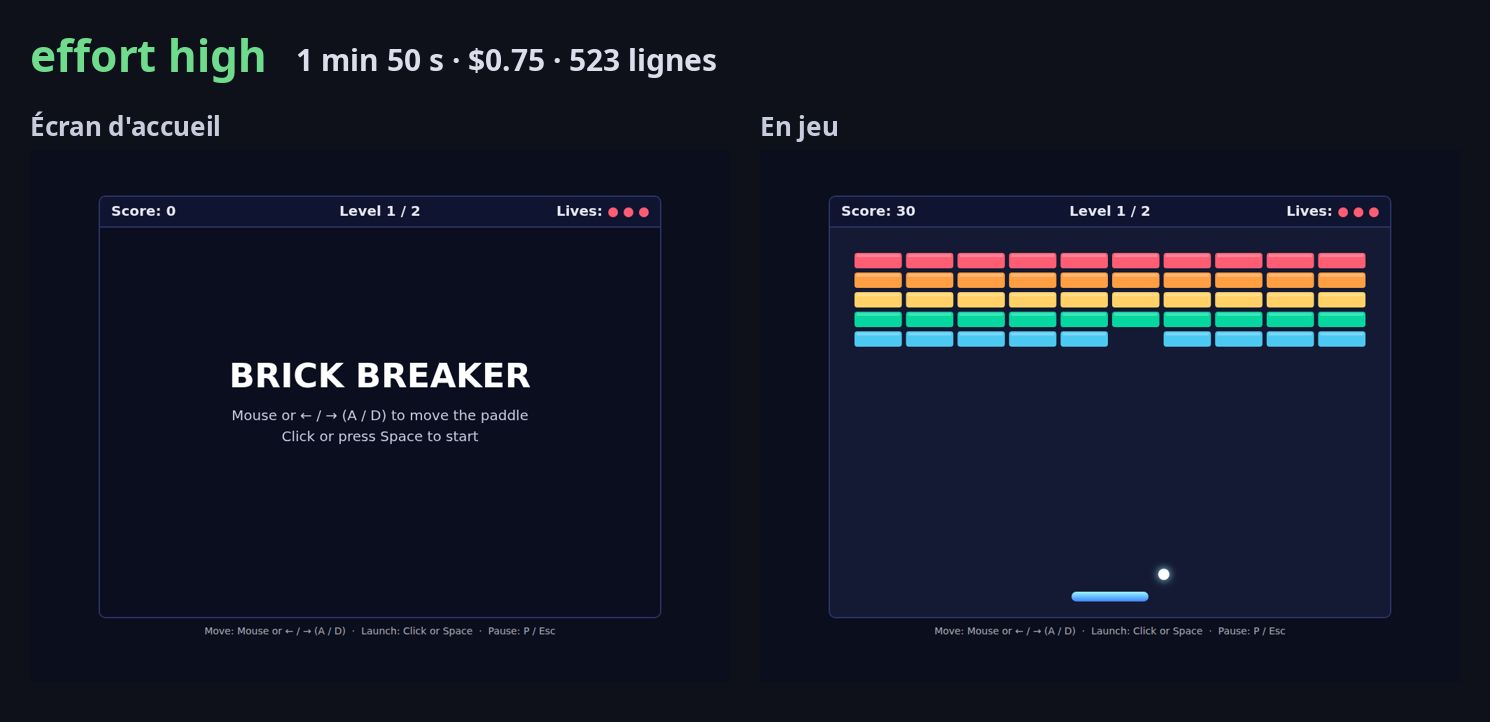
- Ce qu'il a construit : le niveau 2 dessine un losange de briques qui résistent à 2 ou 3 coups, et les briques projettent des particules en se brisant.
- Points forts : un bonus de fin de niveau, un bonus pour les vies restantes, un meilleur score sauvegardé et des commandes tactiles. Il a aussi tenté de vérifier la syntaxe de son propre code.
- Points faibles : il a pris 112 % de temps en plus que medium (de 52 secondes à 1 minute 50 secondes).
- À utiliser quand : vous avez besoin d'un prototype à montrer ou codez là où la qualité compte. Il n'a coûté que 34 % de plus que medium.
xhigh : 4 min 32 s, $1.36
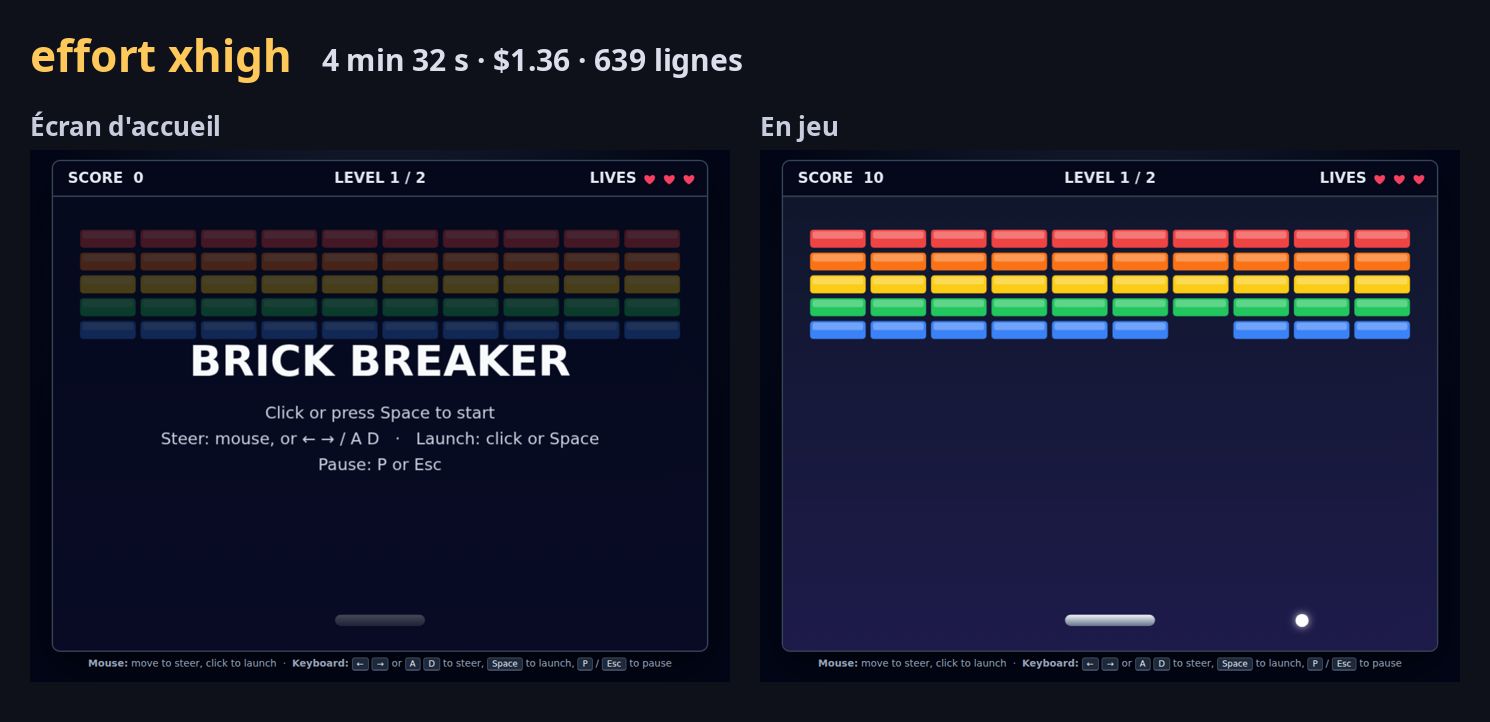
- Ce qu'il a construit : le niveau 2 est un losange entouré de briques d'acier qui se fissurent au premier coup. Les briques rapportent de 10 à 50 points selon leur couleur.
- Points forts : l'écran le plus soigné, et l'alternance souris-clavier fonctionne sans accroc : c'est le dernier utilisé qui déplace la raquette.
- Points faibles : il a abandonné le meilleur score sauvegardé et les commandes tactiles que high proposait. Il a coûté 143 % de plus que medium sans ajouter de fonctionnalités par rapport à high.
- À utiliser quand : pas pour une petite tâche comme celle-ci. Selon Anthropic, il convient aux travaux de longue durée.
max : 22 min 22 s, $5.25
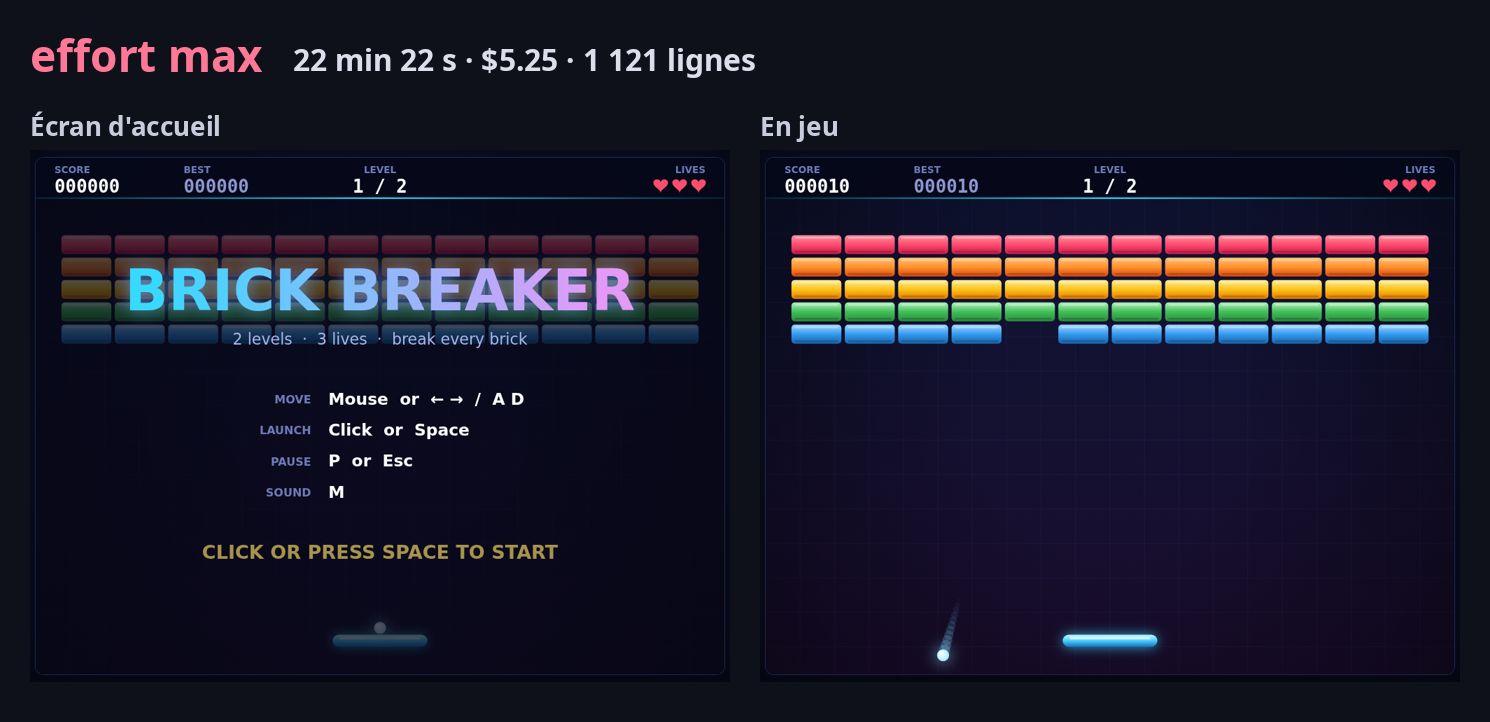
- Ce qu'il a construit : des niveaux nommés ("Rainbow Wall", "Space Invader"), un niveau 2 en forme d'envahisseur dont les 14 briques argentées résistent à deux coups, et une raquette plus étroite au niveau 2.
- Points forts : effets sonores (touche M pour les couper ou les activer), meilleur score sauvegardé, commandes tactiles, tremblement d'écran, feu d'artifice de victoire et pause automatique : le plus complet de tous les niveaux. On dirait un jeu fini.
- Points faibles : de loin le plus lent, en partie parce qu'il a tenté de lancer un test de jeu automatisé qui demandait une autorisation.
- À utiliser quand : la qualité prime avant tout et vous avez du temps et des limites à revendre, ou rien d'autre ne résout le problème.
Retour d'expérience : medium au quotidien, high pour coder
J'utilise (Jaehyun) Opus 5.5 avec l'abonnement Claude Max 20x pour créer des jeux. Il s'agit de mon ressenti au quotidien, pas d'une mesure.
- Mon réglage : je laisse l'effort en automatique. Il tourne généralement en medium et monte en high quand je code.
- low : je l'ai trouvé poussif, je l'ai essayé à quelques reprises puis j'ai arrêté.
- high : les résultats sont nettement meilleurs.
- xhigh et max : je les ai essayés environ à une reprise chacun et j'ai rarement une raison de m'en servir.
Comparé aux mesures, low était en réalité le plus rapide mais donnait le résultat le plus dépouillé : l'impression de lenteur venait donc du résultat plutôt que de la vitesse. Le sentiment que high donne de meilleurs résultats, et que xhigh et max sont rarement nécessaires, correspond aux chiffres.
Ce que recommande Anthropic
- Medium est solide. Dans les tests d'Anthropic, Opus 5.5 en medium a égalé ou dépassé Opus 5 en high pour le code et le travail intellectuel.
- Low s'approche de medium en code, pour un coût bien inférieur, selon Anthropic. Dans notre test, l'écart de résultat était visible.
- Réservez xhigh et max aux tâches où vous avez mesuré un gain de qualité.
- Changer l'effort en cours de conversation peut invalider le cache de prompt. Dans l'API, modifiez l'effort message par message pour conserver le cache.
- Des tests indépendants vont dans le même sens. Selon Artificial Analysis, Opus 5.5 en effort max a utilisé 63 % de tokens de sortie en plus par tâche qu'Opus 5 (d'après la presse).
Quel effort pour quelle tâche
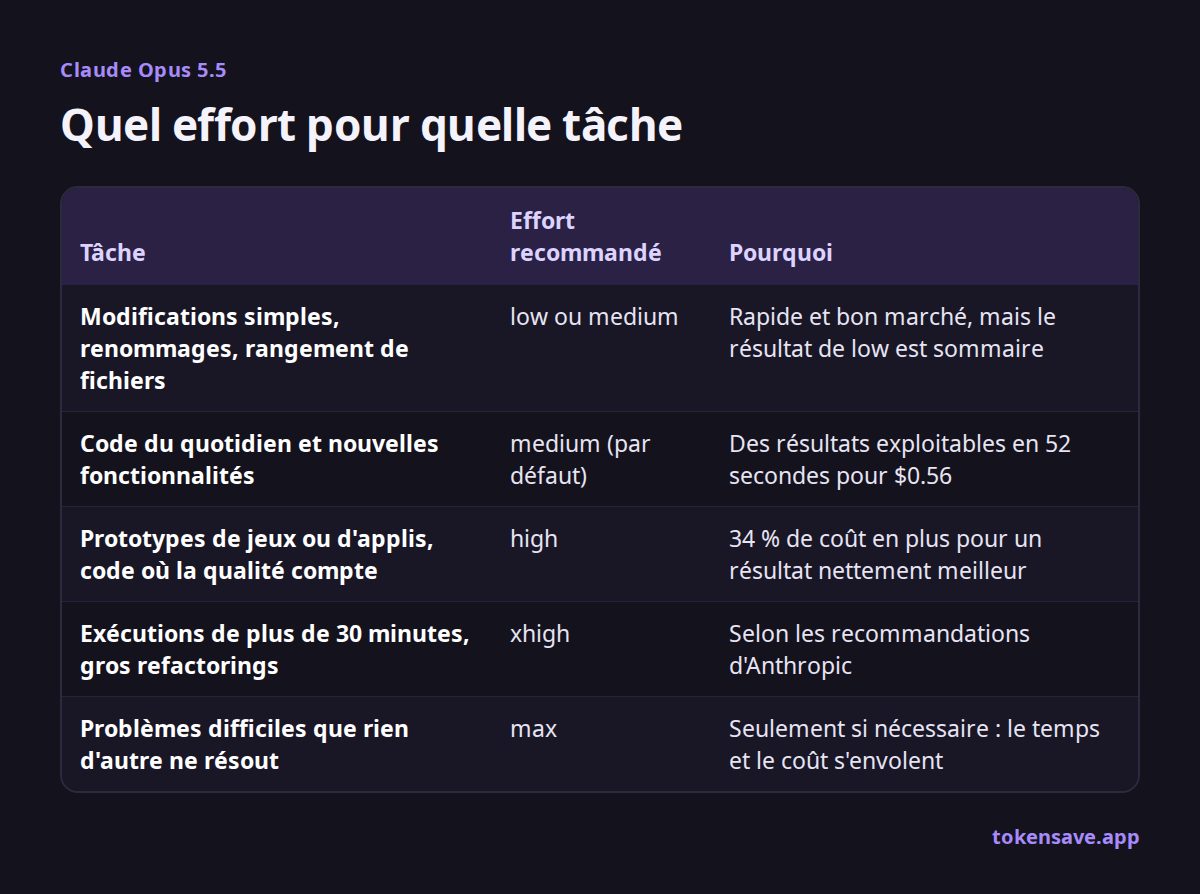
Nos recommandations, qui combinent les mesures, l'expérience de Jaehyun et les conseils d'Anthropic :
| Tâche | Effort recommandé | Pourquoi |
|---|---|---|
| Modifications simples, renommages, rangement de fichiers | low ou medium | Rapide et bon marché, mais le résultat de low est sommaire |
| Code du quotidien et nouvelles fonctionnalités | medium (par défaut) | Des résultats exploitables en 52 secondes pour $0.56 |
| Prototypes de jeux ou d'applis, code où la qualité compte | high | 34 % de coût en plus pour un résultat nettement meilleur |
| Exécutions de plus de 30 minutes, gros refactorings | xhigh | Selon les recommandations d'Anthropic |
| Problèmes difficiles que rien d'autre ne résout | max | Seulement si nécessaire : le temps et le coût s'envolent |
- Commencez en medium. Ne passez en high que les tâches dont le résultat est insuffisant.
- Avec un abonnement, raisonnez en limites. Plus le coût équivalent API est élevé, plus votre limite Max ou Pro s'épuise vite. Un seul essai en max a consommé plus que neuf essais en medium.
- Réserve : un seul essai par niveau, sur une tâche assez petite. Sur de plus gros projets, les écarts peuvent être différents.
Conclusion : medium par défaut, high quand ça compte
- Par défaut : medium. Des résultats exploitables en 52 secondes pour $0.56.
- Quand la qualité compte : high. Seulement 34 % de plus que medium pour un résultat nettement meilleur. Le meilleur rapport qualité-prix des cinq.
- xhigh : à éviter pour les petites tâches. 143 % de plus que medium, sans plus de fonctionnalités que high. Ne vaut le coup que pour les longues exécutions.
- max : uniquement si nécessaire. Le résultat le plus spectaculaire, mais 22 minutes et $5.25.
- low : déconseillé. Économiser 8 cents par rapport à medium ne vous apporte qu'un résultat plus sommaire.
Questions fréquentes
Quel est l'effort par défaut d'Opus 5.5 ? Medium. Opus 5 était réglé sur high par défaut. Les requêtes API qui ne précisent pas l'effort tournent en medium sur Opus 5.5.
Max est-il toujours meilleur ? Dans notre test, il a ajouté le plus de fonctionnalités et de finitions, mais a pris 22 minutes et $5.25, contre 52 secondes et $0.56 pour medium. C'est trop pour un travail simple.
Low permet-il de beaucoup économiser ? Dans notre test, low n'était que 14 % moins cher que medium. Vu son résultat plus sommaire, medium est le meilleur choix.
Calculez-le pour votre propre travail
Dans le calculateur de coût des agents de code, saisissez la taille des tâches et le nombre de tâches par jour pour voir ce que représente un mois sur Opus 5.5. Vérifiez le coût d'un seul prompt avec le compteur de tokens. Pour les différences de prix et de performances entre Opus 5 et 5.5, consultez Claude Opus 5 vs 5.5 (en anglais).
Mesures effectuées le 9 octobre 2026. Le coût correspond à la conversion de ccusage aux tarifs de l'API ; les résultats peuvent évoluer avec les mises à jour du modèle et de Claude Code.
Sources
- Anthropic : Effort
- Anthropic : Rédiger des prompts pour Claude Opus 5.5
- Anthropic : Migrer de Claude Opus 5 vers Opus 5.5
- OfficeChai : rapport sur l'Artificial Analysis Intelligence Index
- ccusage : outil de suivi d'utilisation de Claude Code (GitHub)
Autres articles
- ChatGPT gratuit ou payant en 2026 : Gratuit, Go, Plus, Pro, quelles différences ?
- Gemini gratuit limité à Flash-Lite le 9 octobre : que faire ?
- ChatGPT Go ou Plus : 8 € ou 23 €, lequel choisir ?
- Abonnements IA 2026 : ChatGPT, Claude, Gemini, Mistral en euros TTC
- Souveraineté de l'IA : ce que ça change pour vos prompts (langue, données, coût)
Saisissez la taille des tâches et le nombre de tâches par jour pour comparer un mois sur Opus 5.5, Sonnet 5.5 et GPT-6 Sol.
Ouvrir le calculateur de coût des agents de code →