 TokenSave
El español gasta 1,18× más tokens que el inglés en GPT
Jonhisking · 2026-10-01
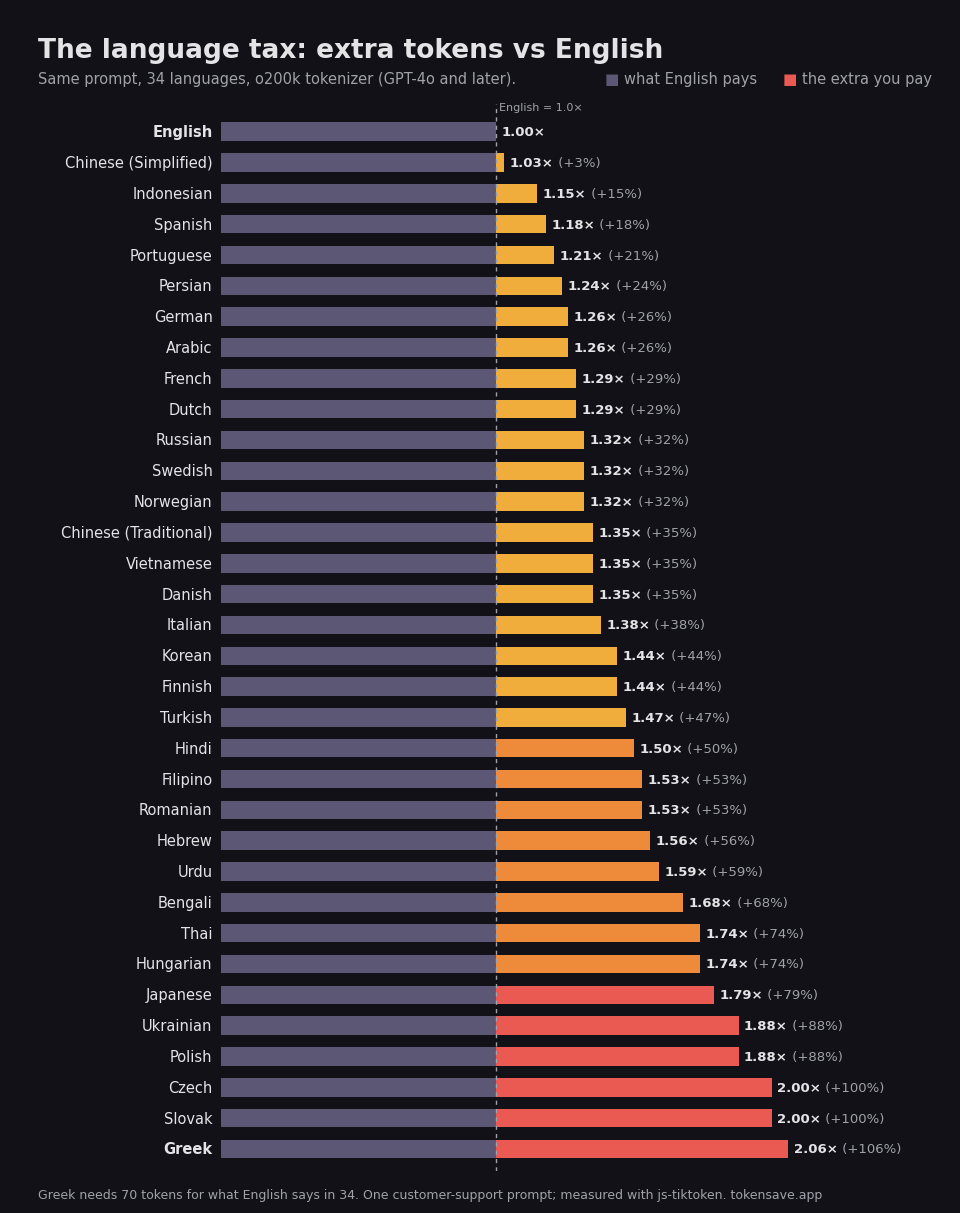
Traduje el mismo prompt de atención al cliente a 34 idiomas y conté los tokens con o200k_base, el tokenizador actual de OpenAI (GPT-4o y posteriores). En inglés son 34 tokens; en español, 40: 1,18× el inglés, puesto 4 de 34 (1 = el más barato).
La versión en español:
Resume el siguiente correo del cliente en tres puntos y sugiere una respuesta amable. El cliente dice que el pedido llegó con dos días de retraso y que faltaba un artículo en la caja.
Resultados
| Idioma | Tokens | Frente al inglés | Tokenizador GPT-4 antiguo |
|---|---|---|---|
| English | 34 | 1,00× | 1,00× |
| 简体中文 | 35 | 1,03× | 1,53× |
| Español | 40 | 1,18× | 1,29× |
| Deutsch | 43 | 1,26× | 1,50× |
| 한국어 | 49 | 1,44× | 2,50× |
| 日本語 | 61 | 1,79× | 2,21× |
| Čeština | 68 | 2,00× | 2,59× |
| Ελληνικά | 70 | 2,06× | 4,94× |
Por qué
El tokenizador aprende sobre todo de texto en inglés: palabras como " polite" o " customer" son un solo token, mientras que muchas palabras en español se parten en trozos:
- sugiere →
su | gi | ere· 3 - retraso →
retras | o· 2 - faltaba →
falt | aba· 2
Frente al tokenizador antiguo
Con el tokenizador de la era GPT-4 (cl100k), el mismo prompt costaba 1,29×; hoy es 1,18×.
En dinero
Con un modelo a 2 $ por millón de tokens de entrada, enviar este prompt un millón de veces cuesta 68 $ en inglés y 80 $ en español. Si la respuesta también es en español, el mismo multiplicador se aplica a los tokens de salida, que suelen costar 4–5× más.
Cómo ahorrar
- Escribe el prompt de sistema y las instrucciones fijas en inglés; deja en español solo lo que escribe el usuario.
- Pide los pasos intermedios (clasificación, extracción, llamadas a herramientas) en inglés o JSON y solo la respuesta final en español.
- Usa prompt caching para la parte fija del prompt.
Limitaciones
- Es un solo prompt; con otros textos la proporción puede variar ±0,1–0,2.
- Claude y Gemini usan otros tokenizadores: estas cifras valen solo para modelos de OpenAI.
- La traducción parte de una traducción automática revisada.
Resultados completos de los 34 idiomas (en inglés): comparativa de 34 idiomas
Mide tu propio texto: cuántos tokens y cuánto dinero cuesta tu prompt en español frente al inglés.
Abrir el contador de tokens →