 TokenSave
Claude Opus 5.5: niveles de effort probados, de low a max
Jonhisking · 9 de octubre de 2026
Claude Opus 5.5 tiene un ajuste llamado effort que controla cuánto razona el modelo, con cinco niveles: low, medium, high, xhigh y max. En teoría, cuanto más alto el nivel, mejor el resultado, pero la documentación oficial no dice cuánto tiempo ni cuánto dinero extra cuesta cada nivel. Por eso, el 9 de octubre de 2026 lanzamos la misma petición para crear un juego en cada nivel, con una ejecución por nivel, y comparamos tiempo, tokens, costo y resultado. El nivel más rápido tardó 32 segundos y el más lento, 22 minutos. Aquí verás qué cambió en cada nivel y qué nivel conviene para cada tarea, junto con la experiencia de uso real.
Qué es effort
- Define cuánto piensa el modelo. En Opus 5.5 el razonamiento no se puede desactivar; effort controla su profundidad. Los tokens de razonamiento se cobran como tokens de salida.
- El valor predeterminado es medium. Opus 5 usaba high por defecto; Opus 5.5 usa un nivel menos, medium (según la documentación de Anthropic).
- Cómo cambiarlo: en Claude Code, con la opción
--effort(de low a max); en la API, con el valoreffort.
Cómo lo medimos
- Modelo: Claude Opus 5.5 en Claude Code, en un PC con Windows
- Prompt (literal): "Make a brick-breaker game that runs in the browser as a single file named index.html in the current folder. It needs 2 levels, a score display and 3 lives, and it must be playable with the keyboard and the mouse. Write the file and finish." Pide un juego de romper ladrillos para el navegador en un único archivo index.html, con 2 niveles, marcador y 3 vidas, jugable con teclado y ratón.
- Método: el mismo prompt en cinco ejecuciones, cambiando solo effort. Cada nivel se ejecutó en su propia carpeta para que las ejecuciones no se influyeran entre sí.
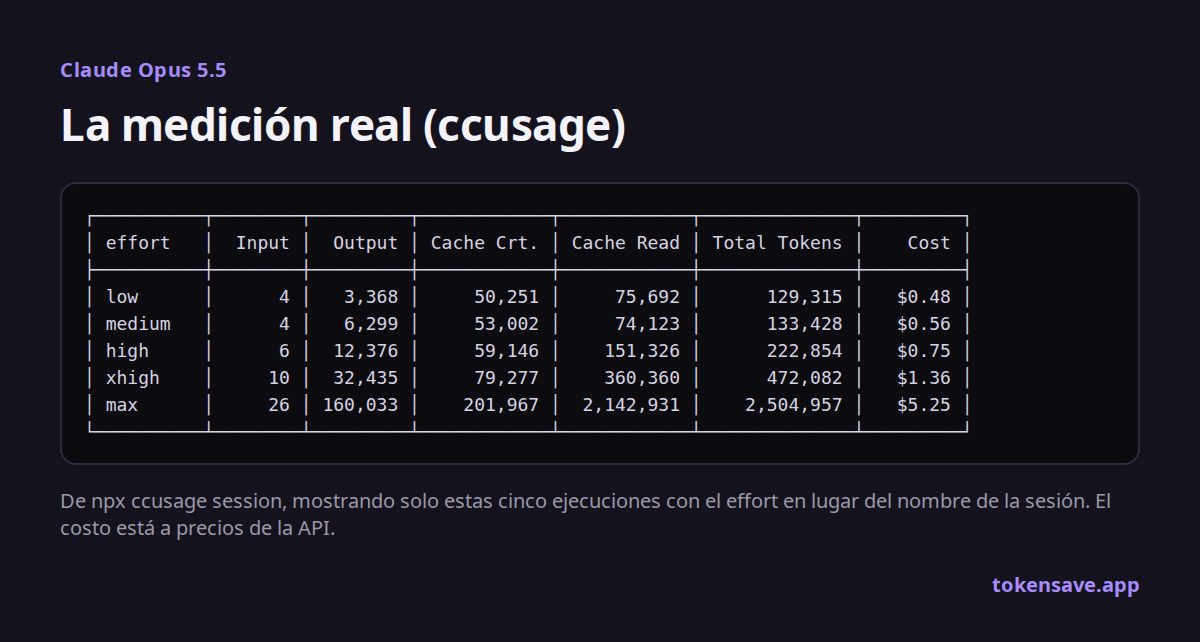
- Medición: tokens y costo con la herramienta gratuita ccusage; tiempo a partir de las marcas de inicio y fin. El costo está calculado a precios de la API.
Resultados: tiempo, tokens y costo
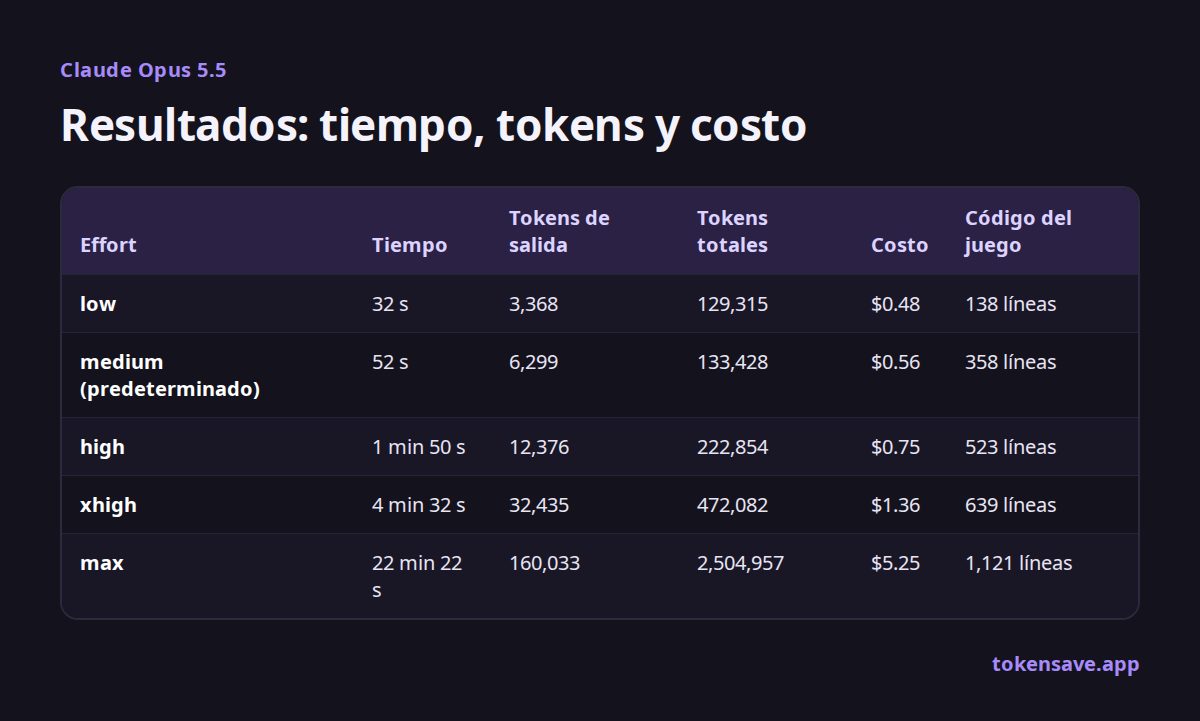
| Effort | Tiempo | Tokens de salida | Tokens totales | Costo | Código del juego |
|---|---|---|---|---|---|
| low | 32 s | 3,368 | 129,315 | $0.48 | 138 líneas |
| medium (predeterminado) | 52 s | 6,299 | 133,428 | $0.56 | 358 líneas |
| high | 1 min 50 s | 12,376 | 222,854 | $0.75 | 523 líneas |
| xhigh | 4 min 32 s | 32,435 | 472,082 | $1.36 | 639 líneas |
| max | 22 min 22 s | 160,033 | 2,504,957 | $5.25 | 1,121 líneas |
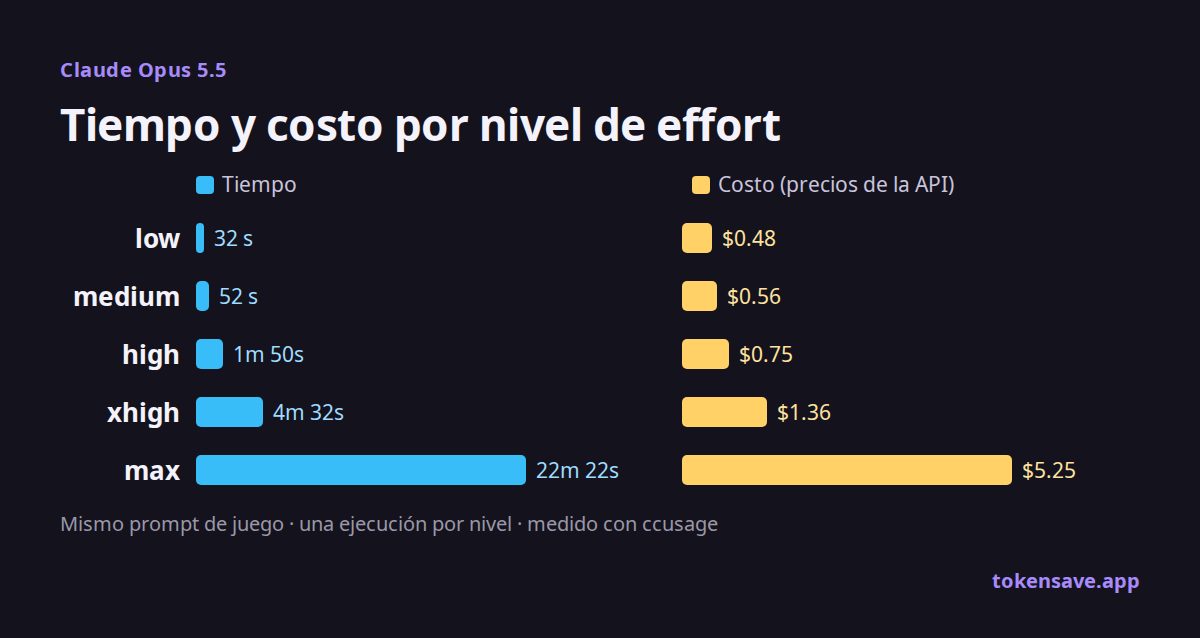
- Low y medium son casi iguales. Low costó un 14% menos y tardó un 38% menos, pero la diferencia es de 8 centavos.
- High costó solo un 34% más que medium. El tiempo pasó de 52 segundos a 1 minuto 50 segundos.
- En xhigh el costo se dispara. Costó un 143% más que medium y tardó 4 minutos 32 segundos.
- Max juega en otra liga. Medium tardó 52 segundos y costó $0.56; max tardó 22 minutos 22 segundos y costó $5.25. Los tokens de salida pasaron de 6,299 a 160,033.
Los cinco juegos, uno al lado del otro
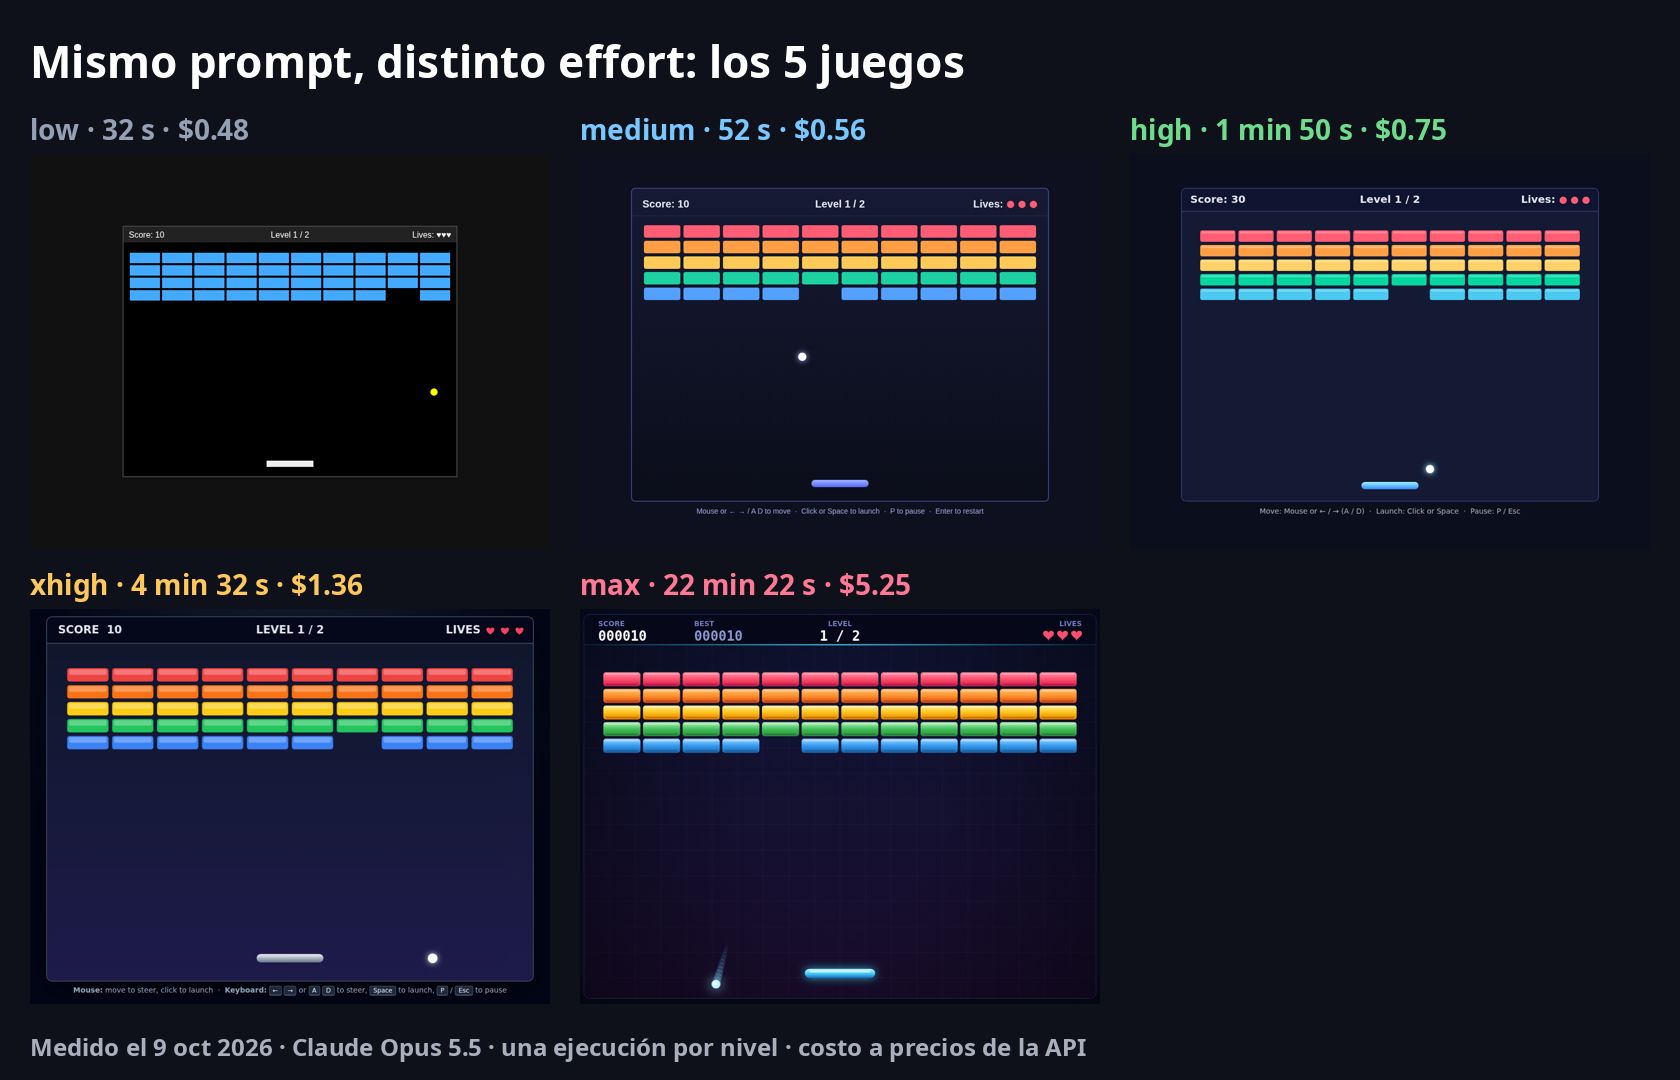
Los cinco juegos funcionaron sin errores y cumplieron la petición: 2 niveles, marcador, 3 vidas y control con teclado y ratón. Las diferencias están en lo que cada nivel añadió por su cuenta.
| Effort | Qué añadió |
|---|---|
| low | Ladrillos de un solo color, la pantalla más sencilla, sin pausa |
| medium | Ladrillos arcoíris, pausa, reinicio |
| high | + efectos de partículas, mejor puntuación guardada |
| xhigh | Efectos de partículas, diseño más pulido (sin mejor puntuación guardada) |
| max | + efectos de sonido, nombres de nivel, un nivel 2 con forma de invasor, sacudida de pantalla, fuegos artificiales de victoria |
- A partir de high, el modelo intentó revisar su propio trabajo. High y xhigh intentaron una comprobación de sintaxis del código, y max intentó una prueba de juego automatizada. Las tres necesitaban permiso para ejecutarse, así que ninguna llegó a correr; cada uno dice que volvió a leer el código en su lugar. Low y medium terminaron sin comprobar nada.
- Los ladrillos que necesitan dos golpes aparecieron en todos los niveles aunque no los pedimos.
Análisis nivel por nivel
Jugamos cada juego y lo contrastamos con el resumen que el modelo dejó al final y con el propio código.
low: 32 s, $0.48
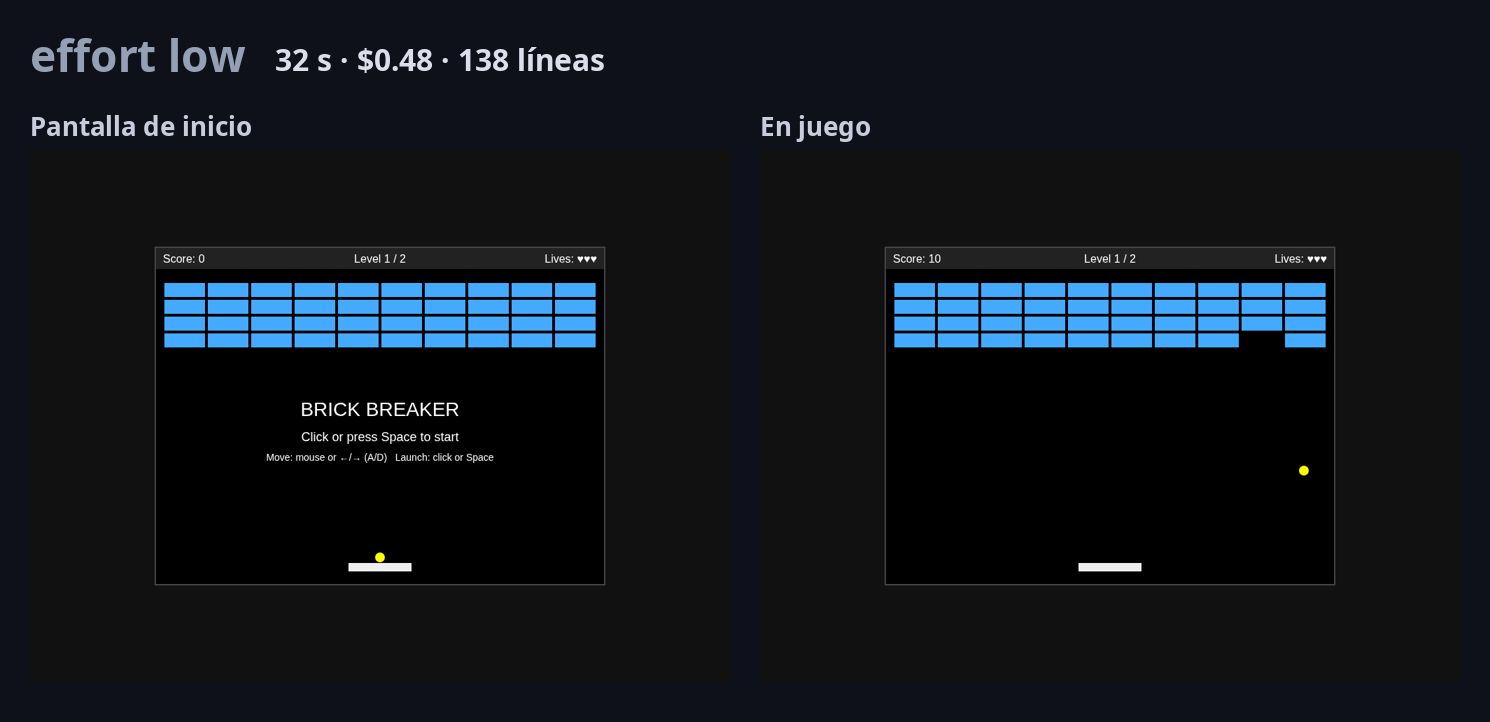
- Qué construyó: el nivel 1 son cuatro filas de ladrillos azules; el nivel 2 mezcla ladrillos naranjas que necesitan dos golpes con huecos, y la bola va más rápido. Tiene pantallas de nivel superado, fin de partida y victoria, además de reinicio.
- Lo bueno: están todas las funciones pedidas, y el punto donde la bola golpea la paleta cambia su ángulo. Listo en 32 segundos.
- Lo flojo: fondo negro y ladrillos de un solo color lo hacen el más sencillo. Sin pausa y, con 138 líneas, el código más corto.
- Úsalo cuando: solo necesitas comprobar que algo funciona y lo pulirás después.
medium: 52 s, $0.56 (predeterminado)
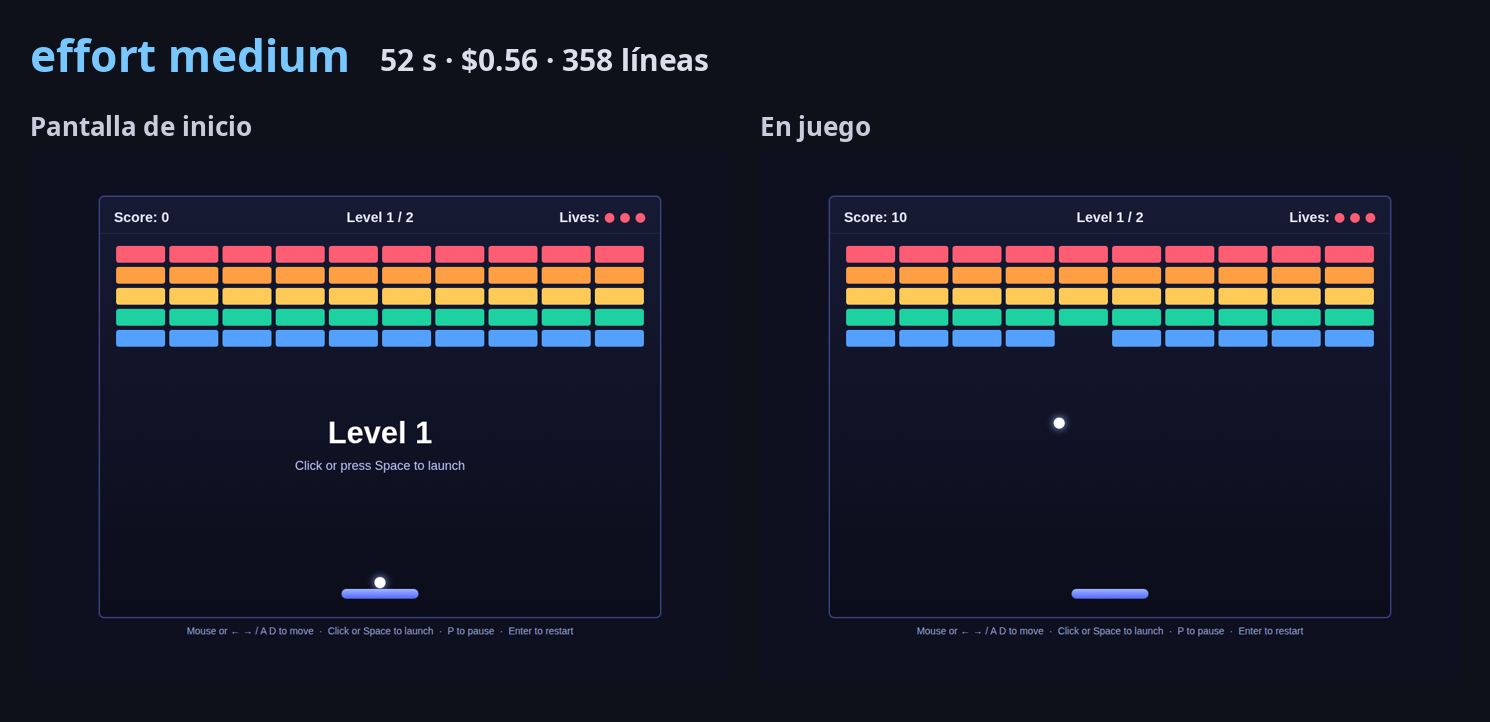
- Qué construyó: el nivel 1 es una cuadrícula arcoíris de 5×10; el nivel 2 tiene huecos y ladrillos que necesitan 2 o 3 golpes, que muestran los golpes restantes y se desvanecen al recibir daño.
- Lo bueno: pausa (P o Esc), reinicio (Enter) y pausa automática cuando la ventana pierde el foco. La puntuación depende de la resistencia del ladrillo y del nivel.
- Lo flojo: sin sonido ni efectos de partículas.
- Úsalo cuando: casi siempre. Cuesta 8 centavos más que low y es una mejora clara.
high: 1 min 50 s, $0.75
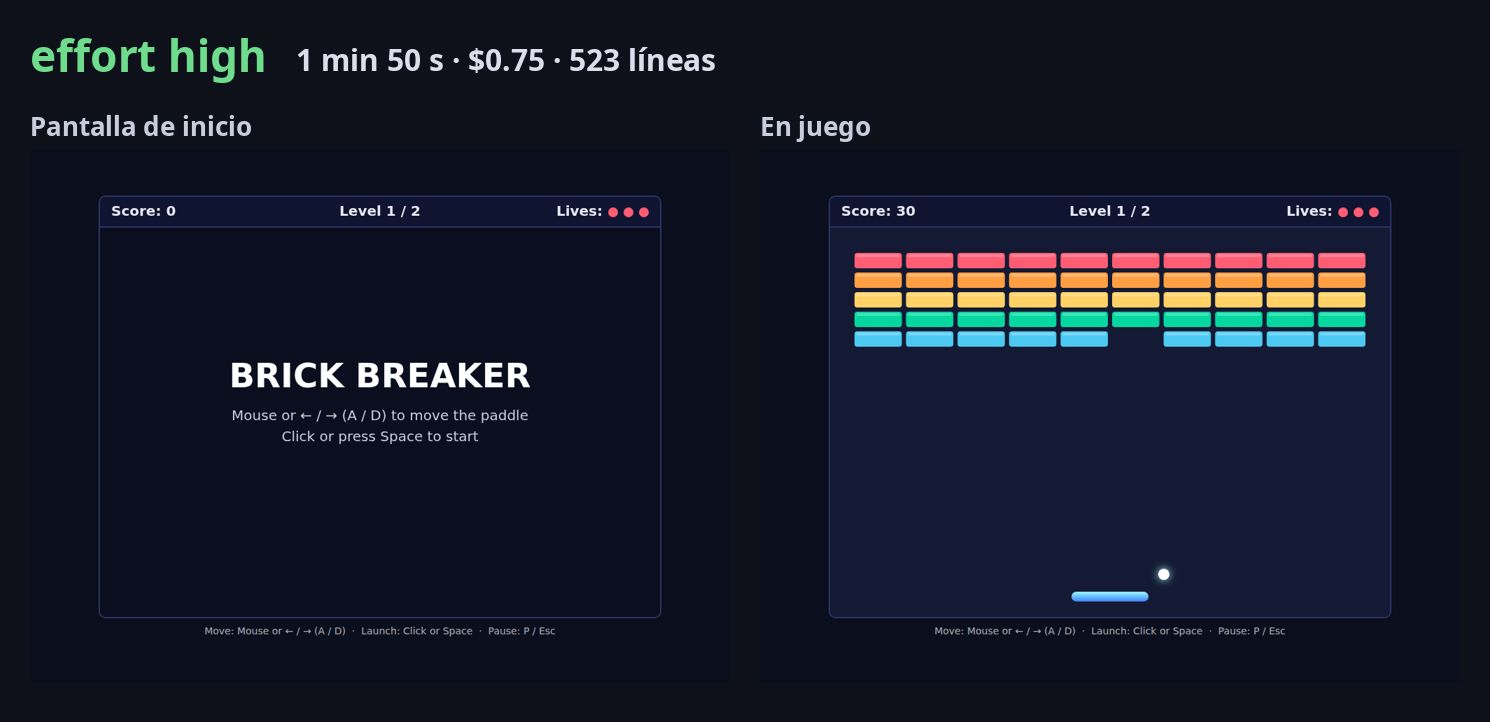
- Qué construyó: el nivel 2 es un patrón en rombo de ladrillos que necesitan 2 o 3 golpes, y los ladrillos sueltan partículas al romperse.
- Lo bueno: bonificación por superar el nivel, bonificación por vidas restantes, mejor puntuación guardada y controles táctiles. Además, intentó por su cuenta una comprobación de sintaxis de su código.
- Lo flojo: tardó un 112% más que medium (de 52 segundos a 1 minuto 50 segundos).
- Úsalo cuando: necesitas un prototipo para enseñar o programas algo donde la calidad importa. Costó solo un 34% más que medium.
xhigh: 4 min 32 s, $1.36
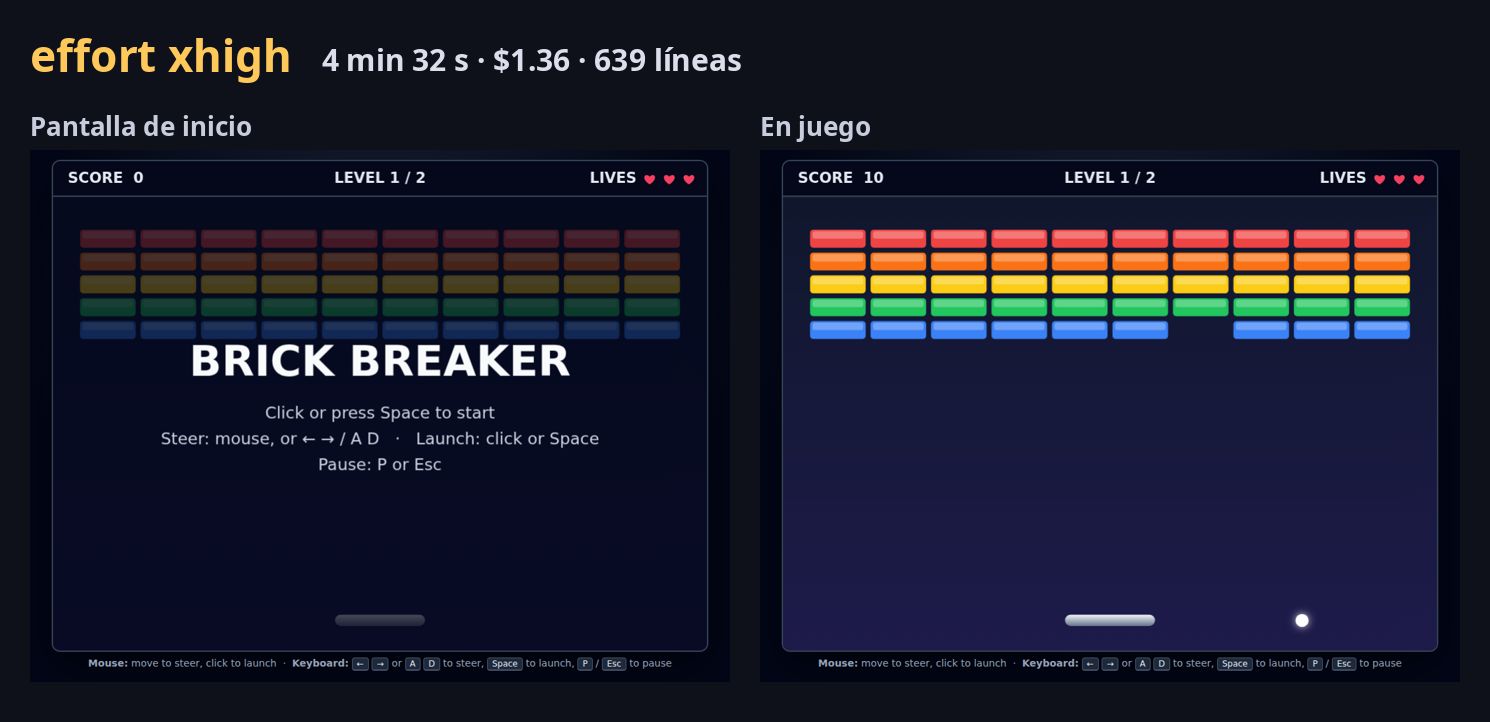
- Qué construyó: el nivel 2 es un rombo rodeado de ladrillos de acero que se agrietan tras el primer golpe. Los ladrillos valen de 10 a 50 puntos según su color.
- Lo bueno: la pantalla de aspecto más cuidado, y combinar ratón y teclado funciona con fluidez: la paleta la mueve lo último que hayas usado.
- Lo flojo: eliminó la mejor puntuación guardada y los controles táctiles que tenía high. Costó un 143% más que medium sin añadir funciones respecto a high.
- Úsalo cuando: no para tareas pequeñas como esta. Según Anthropic, está pensado para trabajos de larga duración.
max: 22 min 22 s, $5.25
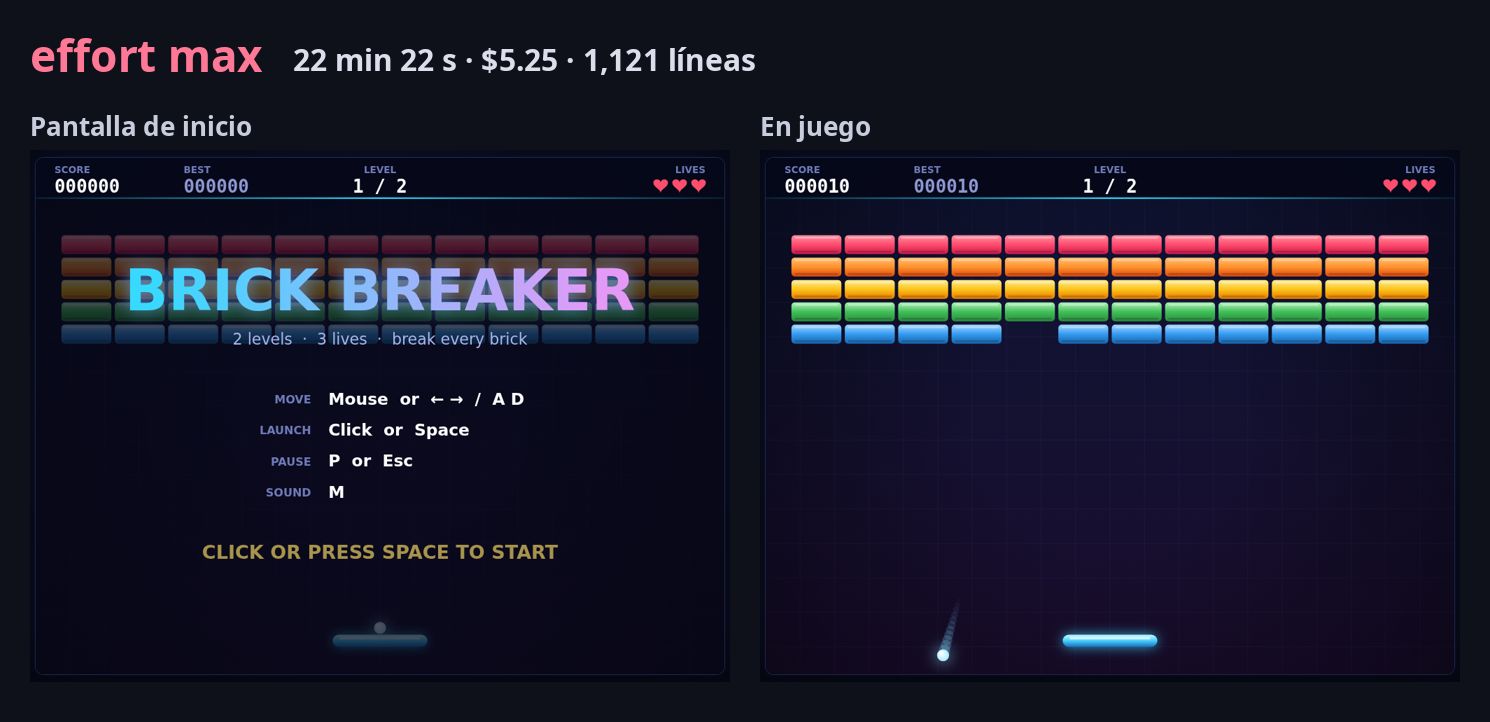
- Qué construyó: niveles con nombre ("Rainbow Wall", "Space Invader"), un nivel 2 con forma de invasor cuyos 14 ladrillos plateados necesitan dos golpes, y una paleta más estrecha en el nivel 2.
- Lo bueno: efectos de sonido (M para activarlos o desactivarlos), mejor puntuación guardada, controles táctiles, sacudida de pantalla, fuegos artificiales de victoria y pausa automática: lo más completo de todos los niveles. Parece un juego terminado.
- Lo flojo: con diferencia el más lento, en parte porque intentó ejecutar una prueba de juego automatizada que necesitaba permiso.
- Úsalo cuando: la calidad es lo primero y te sobran tiempo y límites de uso, o nada más resuelve el problema.
Experiencia real: medium para el día a día, high para programar
Yo (Jaehyun) uso Opus 5.5 con el plan Claude Max 20x para crear juegos. Esto es lo que se siente en el uso diario, no una medición.
- Mi configuración: dejo effort en automático. Normalmente funciona en medium y sube a high cuando estoy programando.
- low: me pareció lento, así que lo usé en unas pocas ocasiones y lo dejé.
- high: los resultados son claramente mejores.
- xhigh y max: los probé más o menos en una ocasión y casi nunca tengo motivo para usarlos.
Comparado con las mediciones, low fue en realidad el más rápido pero dio el resultado más sencillo, así que la sensación de lentitud tenía que ver con el resultado y no con la velocidad. La impresión de que high da mejores resultados, y de que xhigh y max casi nunca hacen falta, coincidió con los números.
Qué recomienda Anthropic
- Medium rinde muy bien. En las pruebas de Anthropic, Opus 5.5 en medium igualó o superó a Opus 5 en high en programación y trabajo de conocimiento.
- Low se acerca a medium en programación, con un costo mucho menor, según Anthropic. En nuestra prueba, la diferencia en el resultado sí se notó.
- Reserva xhigh y max para trabajos en los que hayas medido una mejora de calidad.
- Cambiar effort a mitad de conversación puede romper la caché de prompts. En la API, usa un cambio de effort por mensaje para conservar la caché.
- Las pruebas independientes coinciden. Artificial Analysis encontró que Opus 5.5 en effort max usó un 63% más de tokens de salida por tarea que Opus 5 (según informes de prensa).
Qué effort usar para cada tarea
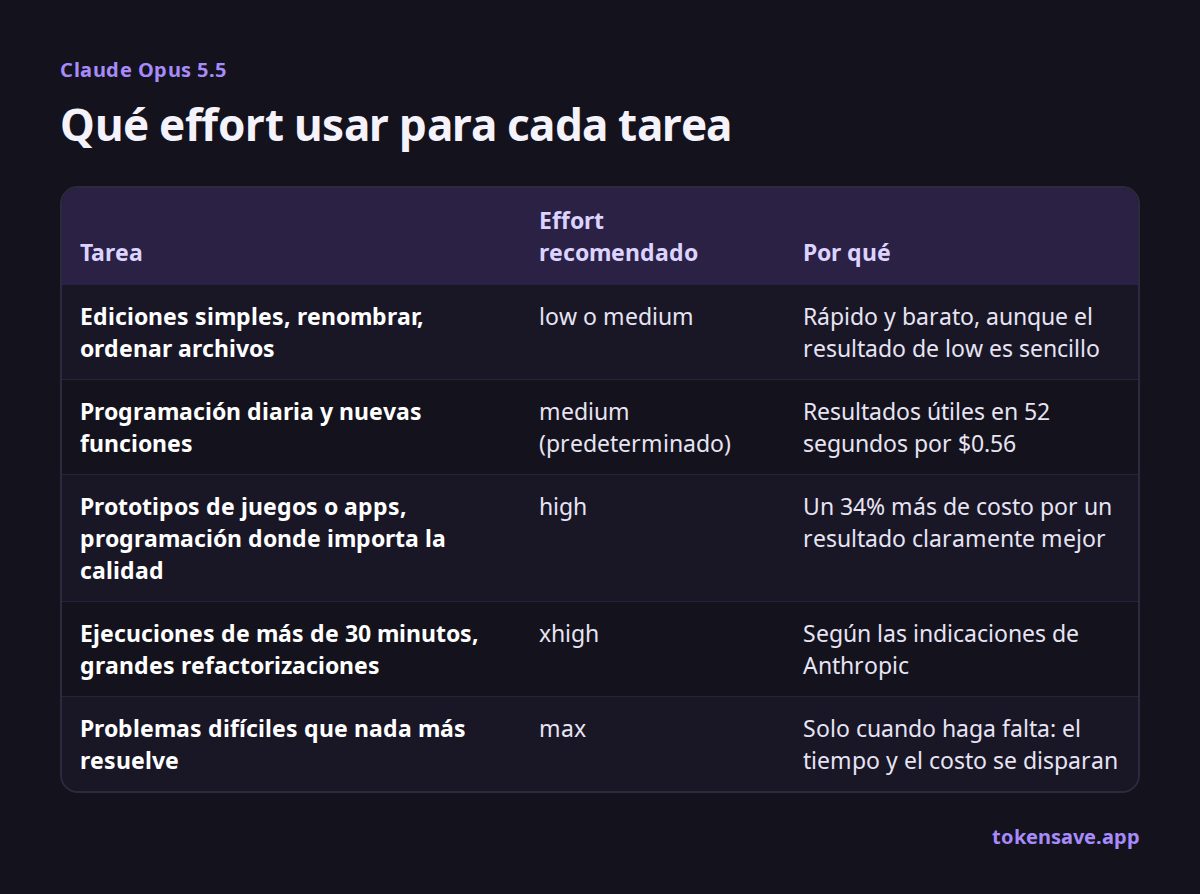
Nuestras recomendaciones, combinando las mediciones, la experiencia de Jaehyun y las indicaciones de Anthropic:
| Tarea | Effort recomendado | Por qué |
|---|---|---|
| Ediciones simples, renombrar, ordenar archivos | low o medium | Rápido y barato, aunque el resultado de low es sencillo |
| Programación diaria y nuevas funciones | medium (predeterminado) | Resultados útiles en 52 segundos por $0.56 |
| Prototipos de juegos o apps, programación donde importa la calidad | high | Un 34% más de costo por un resultado claramente mejor |
| Ejecuciones de más de 30 minutos, grandes refactorizaciones | xhigh | Según las indicaciones de Anthropic |
| Problemas difíciles que nada más resuelve | max | Solo cuando haga falta: el tiempo y el costo se disparan |
- Empieza en medium. Sube a high solo las tareas cuyo resultado se quede corto.
- Si usas un plan, piensa en límites. Cuanto mayor es el costo equivalente en la API, más rápido se agota tu límite de Max o Pro. Una ejecución en max consumió más que nueve ejecuciones en medium.
- Advertencia: una ejecución por nivel en una tarea bastante pequeña. En proyectos más grandes las diferencias pueden ser otras.
Conclusión: medium por defecto, high cuando importa
- Por defecto: medium. Resultados útiles en 52 segundos por $0.56.
- Cuando importa la calidad: high. Solo un 34% más que medium por un resultado claramente mejor. La mejor relación calidad-precio de los cinco.
- xhigh: sáltalo en tareas pequeñas. Un 143% más que medium, pero sin más funciones que high. Solo vale la pena para ejecuciones largas.
- max: solo cuando lo necesites. El resultado más vistoso, pero 22 minutos y $5.25.
- low: no recomendado. Ahorrar 8 centavos frente a medium solo te da un resultado más sencillo.
Preguntas frecuentes
¿Cuál es el effort predeterminado de Opus 5.5? Medium. Opus 5 usaba high por defecto. Las solicitudes a la API que no especifican effort se ejecutan en medium en Opus 5.5.
¿Max siempre es mejor? En nuestra prueba añadió más funciones y pulido que ningún otro nivel, pero tardó 22 minutos y costó $5.25, frente a 52 segundos y $0.56 de medium. Demasiado para trabajos sencillos.
¿Low ahorra mucho? En nuestra prueba, low fue solo un 14% más barato que medium. Teniendo en cuenta su resultado más sencillo, medium es la mejor opción.
Calcúlalo para tu propio trabajo
En la calculadora de costos de agentes de programación, introduce el tamaño de la tarea y las tareas por día para ver un mes con Opus 5.5. Consulta el costo de un solo prompt en el contador de tokens. Para las diferencias de precio y rendimiento entre Opus 5 y 5.5, consulta Claude Opus 5 vs 5.5 (en inglés). Si usas un plan, mira también el precio de Claude Code al mes.
Medido el 9 de octubre de 2026. El costo es la conversión de ccusage a precios de la API; los resultados pueden cambiar con actualizaciones del modelo y de Claude Code.
Fuentes
- Anthropic: Effort
- Anthropic: Cómo escribir prompts para Claude Opus 5.5
- Anthropic: Migrar de Claude Opus 5 a Opus 5.5
- OfficeChai: informe del Artificial Analysis Intelligence Index
- ccusage: herramienta de uso de Claude Code (GitHub)
Más artículos
- Precio de ChatGPT, Claude, Gemini y Grok en euros y pesos (2026)
- Gemini gratis pasa a Flash-Lite el 9 de octubre: qué cambia y precios
- ChatGPT Go vs Plus: diferencias, precio en euros y pesos, y anuncios
- 15 páginas de IA gratis que vale la pena guardar en favoritos
- Precio de Gemini 4 Argon: costo frente a GPT-6 y Claude
Introduce el tamaño de la tarea y las tareas por día para comparar un mes con Opus 5.5, Sonnet 5.5 y GPT-6 Sol.
Abrir la calculadora de costos de agentes de programación →