 TokenSave
Claude Opus 5.5 effort-Stufen im Test: von low bis max
Jonhisking · 9. Oktober 2026
Claude Opus 5.5 hat eine effort-Einstellung, die steuert, wie gründlich das Modell nachdenkt. Es gibt fünf Stufen: low, medium, high, xhigh und max. Höhere Stufen sollen bessere Ergebnisse liefern, doch die offizielle Dokumentation nennt keine Zahlen dazu, wie viel zusätzliche Zeit und wie viel Geld jede Stufe kostet. Deshalb haben wir am 9. Oktober 2026 dieselbe Anfrage zum Bau eines Spiels mit genau einem Durchlauf pro Stufe ausgeführt und Zeit, Tokens, Kosten und Ergebnis verglichen. Die schnellste Stufe brauchte 32 Sekunden, die langsamste 22 Minuten. Hier sehen Sie, was sich auf jeder Stufe geändert hat und welche Stufe zu welcher Aufgabe passt, ergänzt um Erfahrungen aus der Praxis.
Was effort ist
- Es legt fest, wie viel das Modell nachdenkt. Bei Opus 5.5 lässt sich das Nachdenken nicht abschalten; effort bestimmt, wie tief es geht. Denk-Tokens werden als Output-Tokens abgerechnet.
- Der Standard ist medium. Bei Opus 5 war high voreingestellt; Opus 5.5 startet eine Stufe tiefer, auf medium (laut Anthropic-Dokumentation).
- So ändern Sie es: In Claude Code mit der Option
--effort(low bis max), in der API über den Werteffort.
So haben wir gemessen
- Modell: Claude Opus 5.5 in Claude Code auf einem Windows-PC
- Prompt (wörtlich): "Make a brick-breaker game that runs in the browser as a single file named index.html in the current folder. It needs 2 levels, a score display and 3 lives, and it must be playable with the keyboard and the mouse. Write the file and finish." Der Prompt verlangt ein Breakout-Spiel als einzelne Datei index.html mit 2 Levels, Punkteanzeige und 3 Leben, steuerbar per Tastatur und Maus.
- Methode: Derselbe Prompt fünf Durchläufe lang, nur effort wurde geändert. Jede Stufe lief in einem eigenen Ordner, damit sich die Läufe nicht gegenseitig beeinflussen konnten.
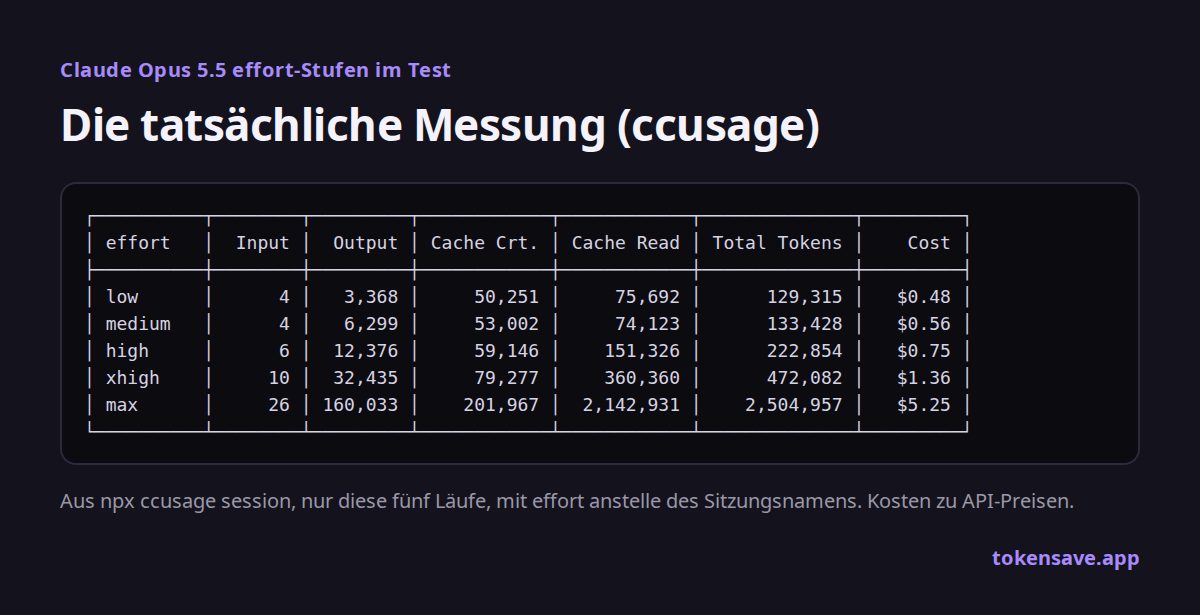
- Messung: Tokens und Kosten mit dem kostenlosen Tool ccusage, die Zeit anhand der Start- und End-Zeitstempel. Die Kosten sind zu API-Preisen umgerechnet.
Ergebnisse: Zeit, Tokens und Kosten
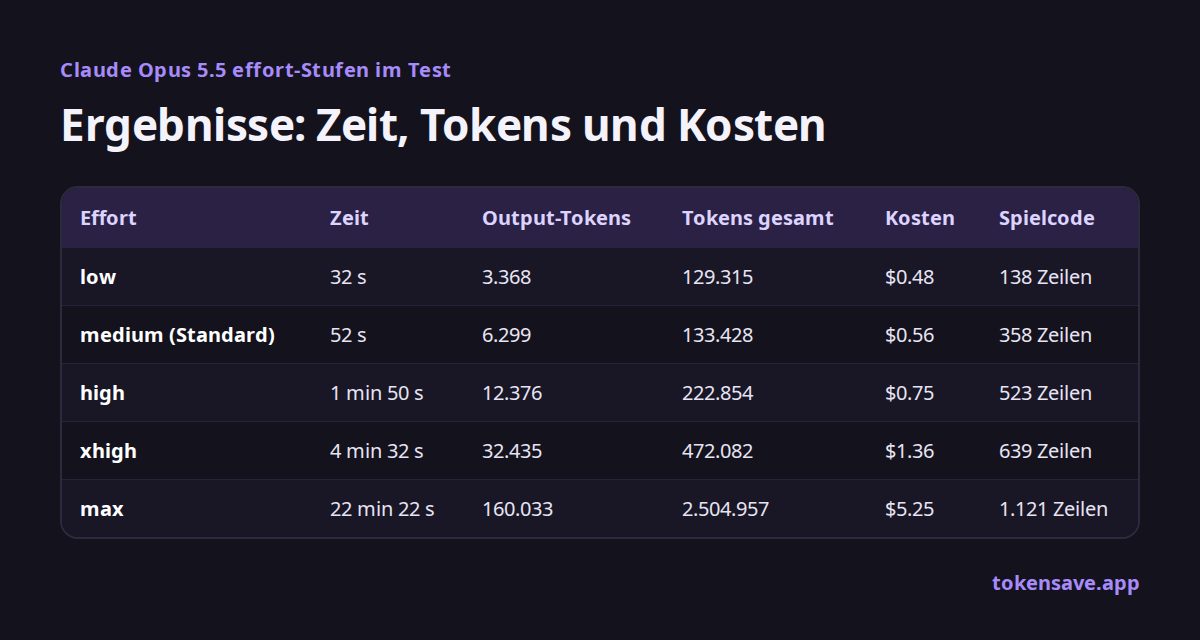
| Effort | Zeit | Output-Tokens | Tokens gesamt | Kosten | Spielcode |
|---|---|---|---|---|---|
| low | 32 s | 3.368 | 129.315 | $0.48 | 138 Zeilen |
| medium (Standard) | 52 s | 6.299 | 133.428 | $0.56 | 358 Zeilen |
| high | 1 min 50 s | 12.376 | 222.854 | $0.75 | 523 Zeilen |
| xhigh | 4 min 32 s | 32.435 | 472.082 | $1.36 | 639 Zeilen |
| max | 22 min 22 s | 160.033 | 2.504.957 | $5.25 | 1.121 Zeilen |
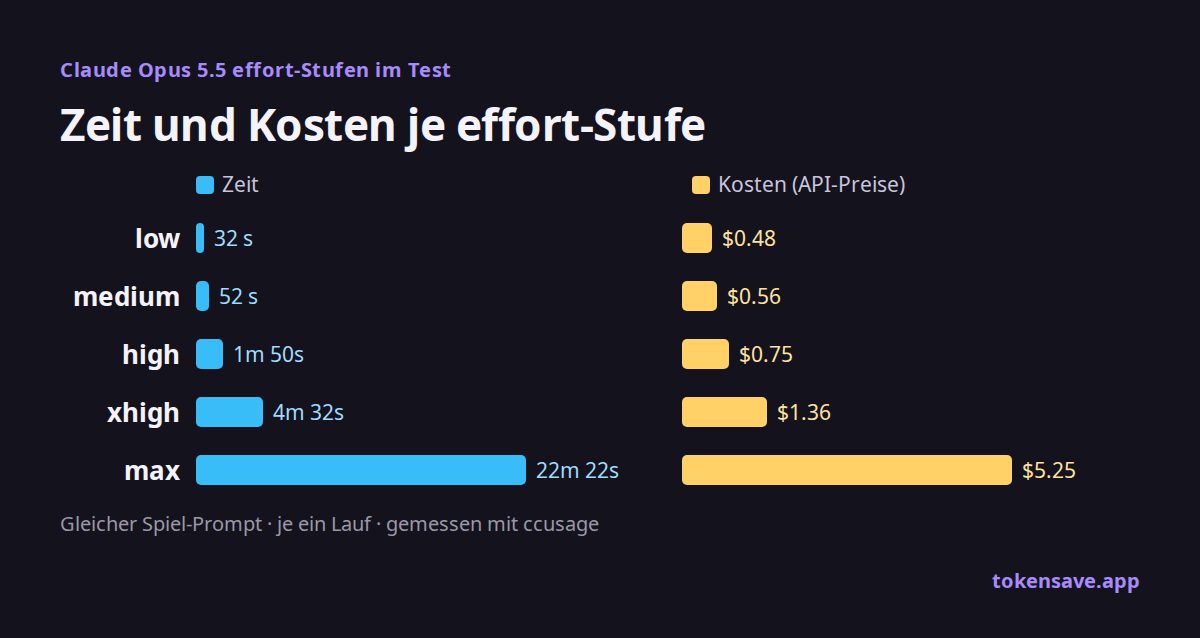
- low und medium liegen fast gleichauf. low war 14% günstiger und brauchte 38% weniger Zeit, aber das sind gerade 8 Cent.
- high kostete nur 34% mehr als medium. Die Zeit stieg von 52 Sekunden auf 1 Minute 50 Sekunden.
- Ab xhigh springen die Kosten. Es kostete 143% mehr als medium und brauchte 4 Minuten 32 Sekunden.
- max spielt in einer eigenen Liga. medium brauchte 52 Sekunden und $0.56, max 22 Minuten 22 Sekunden und $5.25. Die Output-Tokens stiegen von 6.299 auf 160.033.
Die fünf Spiele im Vergleich
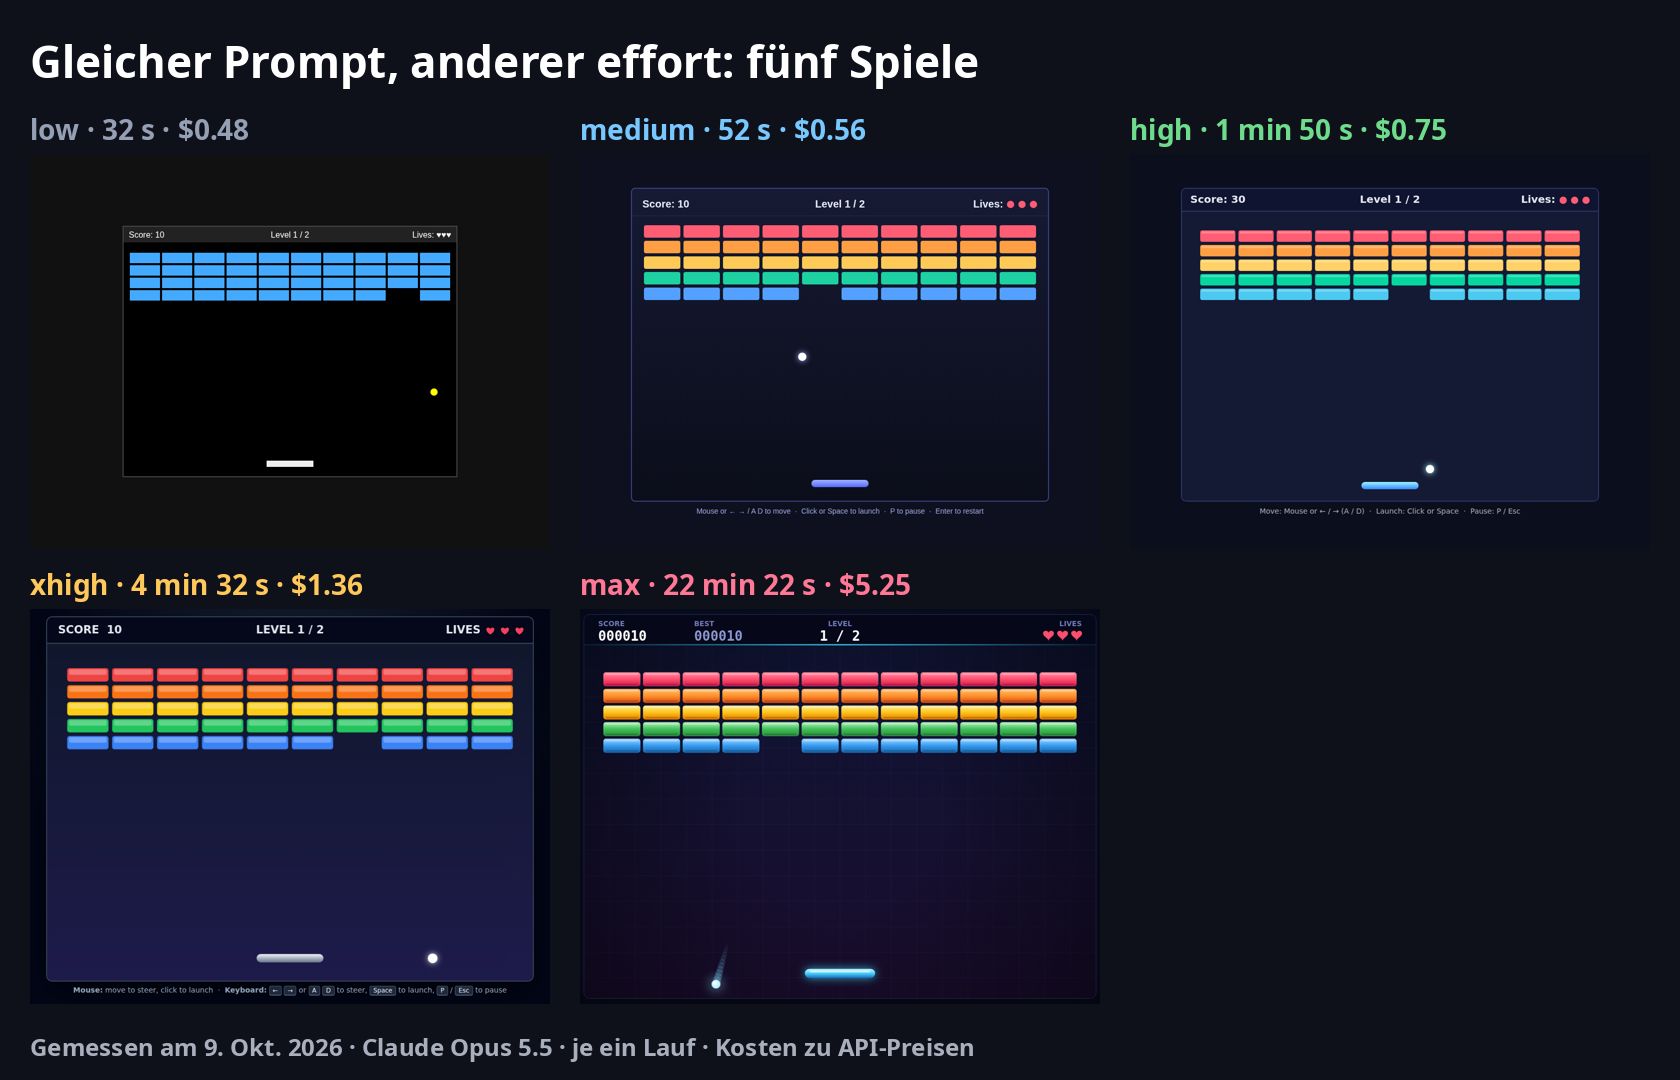
Alle fünf Spiele liefen fehlerfrei und erfüllten die Anfrage: 2 Levels, Punkte, 3 Leben, Steuerung per Tastatur und Maus. Die Unterschiede liegen darin, was jede Stufe zusätzlich eingebaut hat.
| Effort | Was hinzukam |
|---|---|
| low | Einfarbige Steine, der schlichteste Bildschirm, keine Pause |
| medium | Regenbogenfarbene Steine, Pause, Neustart |
| high | + Partikeleffekte, gespeicherter Highscore |
| xhigh | Partikeleffekte, ausgefeilteres Design (kein gespeicherter Highscore) |
| max | + Soundeffekte, Level-Namen, ein Level 2 in Invader-Form, Bildschirmwackeln, Siegesfeuerwerk |
- Ab high versuchte das Modell, die eigene Arbeit zu prüfen. high und xhigh versuchten eine Syntaxprüfung des Codes, max einen automatisierten Spieltest. Alle drei hätten dafür eine Freigabe gebraucht, daher lief keiner davon tatsächlich; jede Stufe gibt an, den Code stattdessen erneut gelesen zu haben. low und medium wurden ohne Prüfung fertig.
- Steine, die zwei Treffer aushalten, tauchten auf jeder Stufe auf, obwohl wir sie nicht verlangt hatten.
Die Stufen im Einzelnen
Wir haben jedes Spiel gespielt und mit der Zusammenfassung des Modells am Ende sowie mit dem Code selbst abgeglichen.
low: 32 s, $0.48
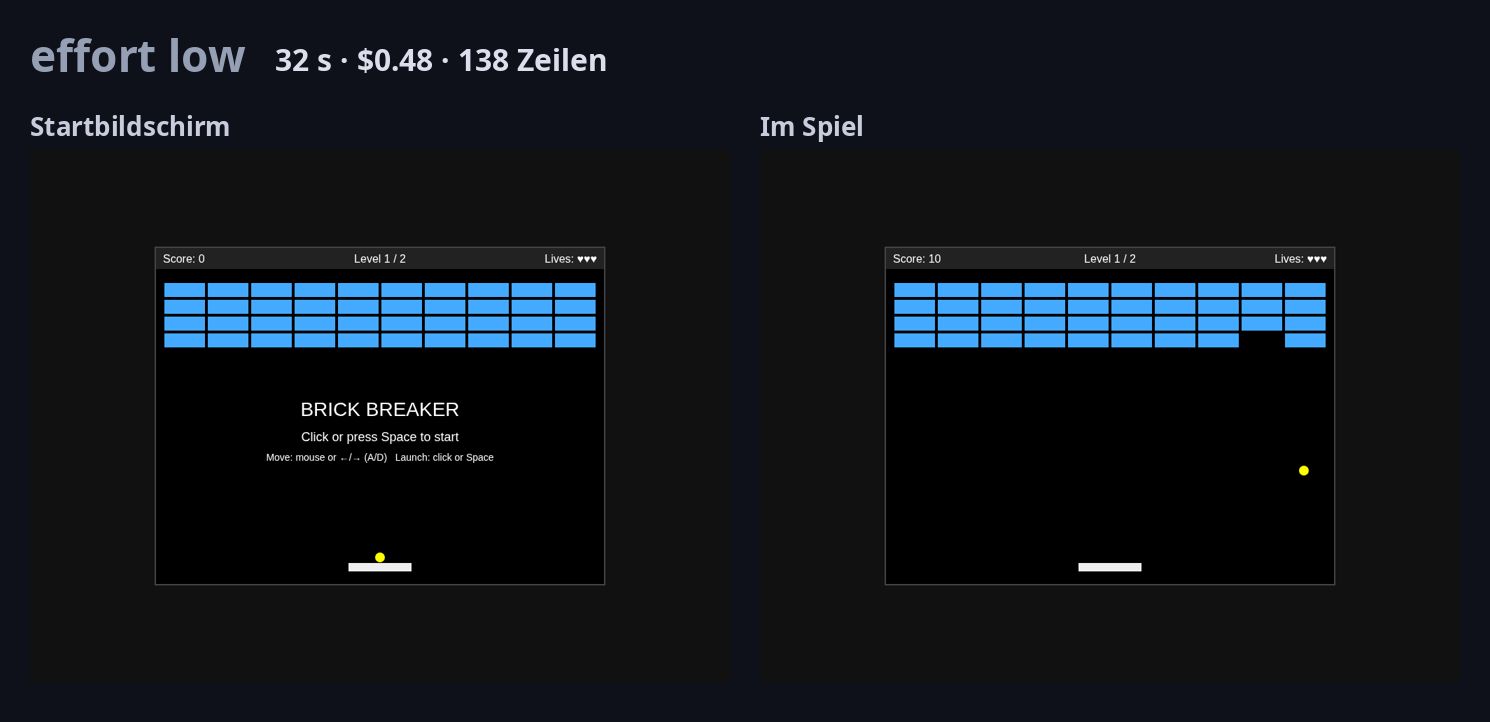
- Was es gebaut hat: Level 1 besteht aus vier Reihen blauer Steine; Level 2 mischt orange Steine, die zwei Treffer aushalten, mit Lücken, und der Ball ist schneller. Es gibt Bildschirme für geschafftes Level, Game Over und Sieg sowie einen Neustart.
- Gut: Alle geforderten Funktionen sind da, und die Stelle, an der der Ball den Schläger trifft, verändert seinen Winkel. Fertig in 32 Sekunden.
- Schwach: Schwarzer Hintergrund und einfarbige Steine machen es zum schlichtesten Spiel. Keine Pause, und mit 138 Zeilen der kürzeste Code.
- Geeignet, wenn: Sie nur prüfen wollen, ob etwas funktioniert, und es später aufpolieren.
medium: 52 s, $0.56 (Standard)
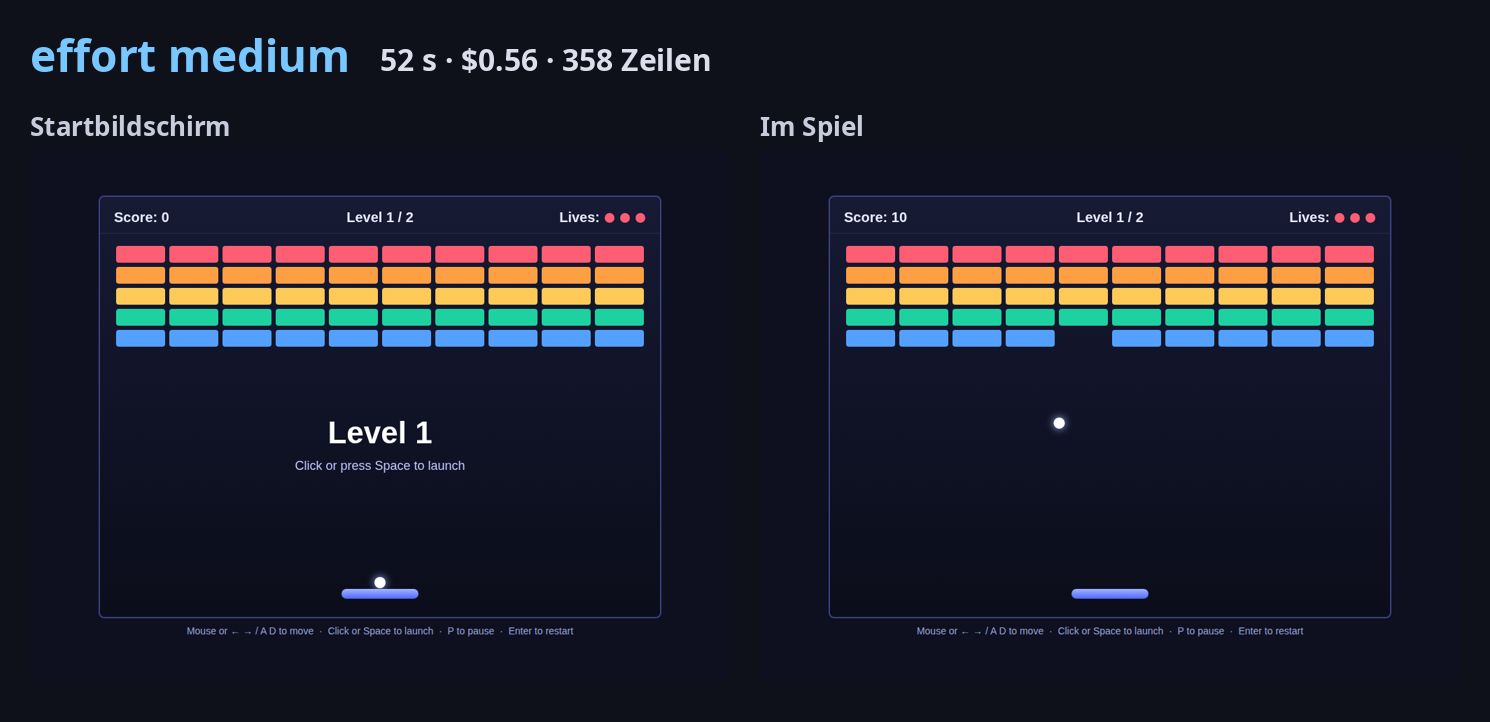
- Was es gebaut hat: Level 1 ist ein 5×10-Raster in Regenbogenfarben; Level 2 hat Lücken und Steine, die 2 oder 3 Treffer aushalten, die verbleibenden Treffer anzeigen und bei Schaden verblassen.
- Gut: Pause (P oder Esc), Neustart (Enter) und automatische Pause, wenn das Fenster den Fokus verliert. Die Punkte hängen von der Stärke der Steine und vom Level ab.
- Schwach: Keine Sound- oder Partikeleffekte.
- Geeignet, wenn: meistens. Es kostet 8 Cent mehr als low und ist ein klarer Schritt nach oben.
high: 1 min 50 s, $0.75
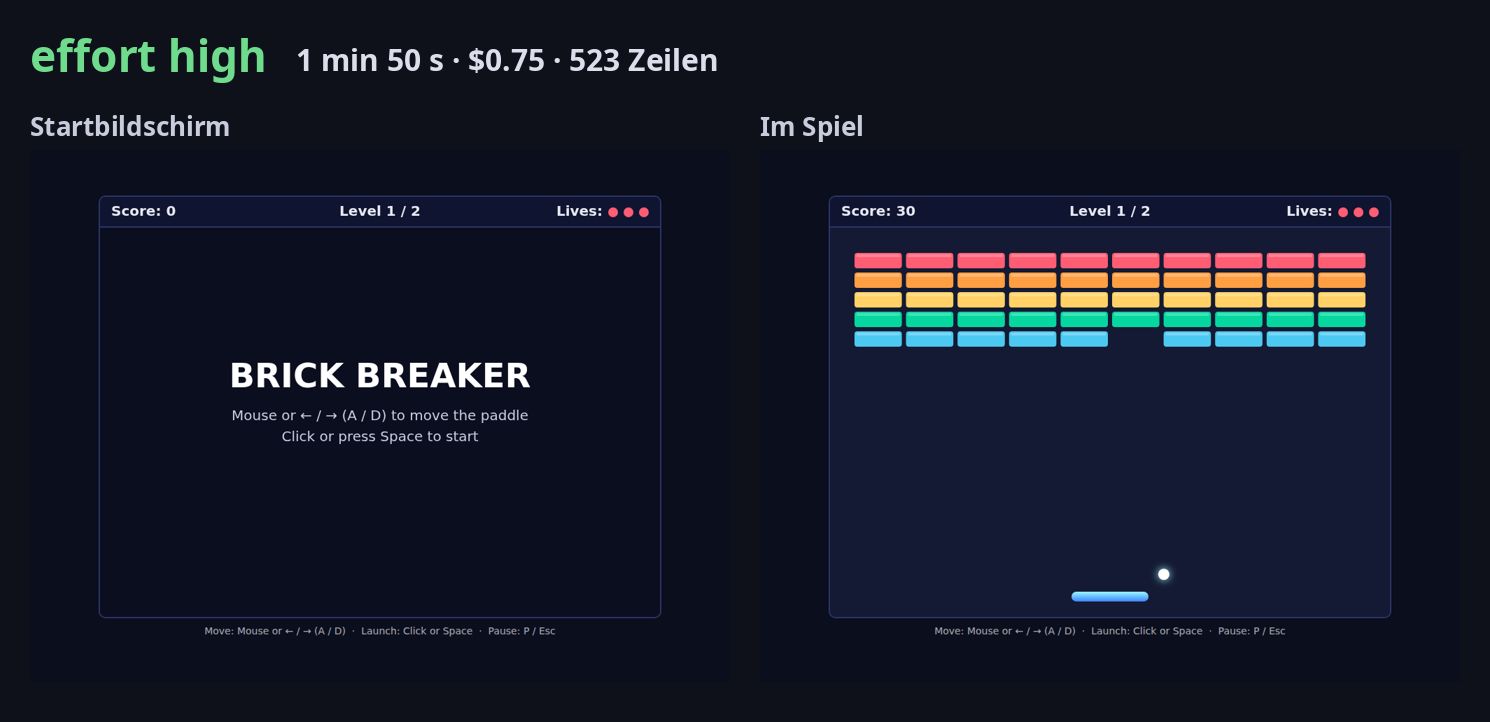
- Was es gebaut hat: Level 2 ist ein Rautenmuster aus Steinen, die 2 oder 3 Treffer aushalten, und zerbrechende Steine sprühen Partikel.
- Gut: Ein Bonus für geschaffte Level, ein Bonus für übrige Leben, ein gespeicherter Highscore und Touch-Steuerung. Außerdem versuchte es von sich aus eine Syntaxprüfung des eigenen Codes.
- Schwach: Es brauchte 112% länger als medium (52 Sekunden gegenüber 1 Minute 50 Sekunden).
- Geeignet, wenn: Sie einen Prototyp brauchen, den Sie anderen zeigen, oder beim Coden, wo Qualität zählt. Es kostete nur 34% mehr als medium.
xhigh: 4 min 32 s, $1.36
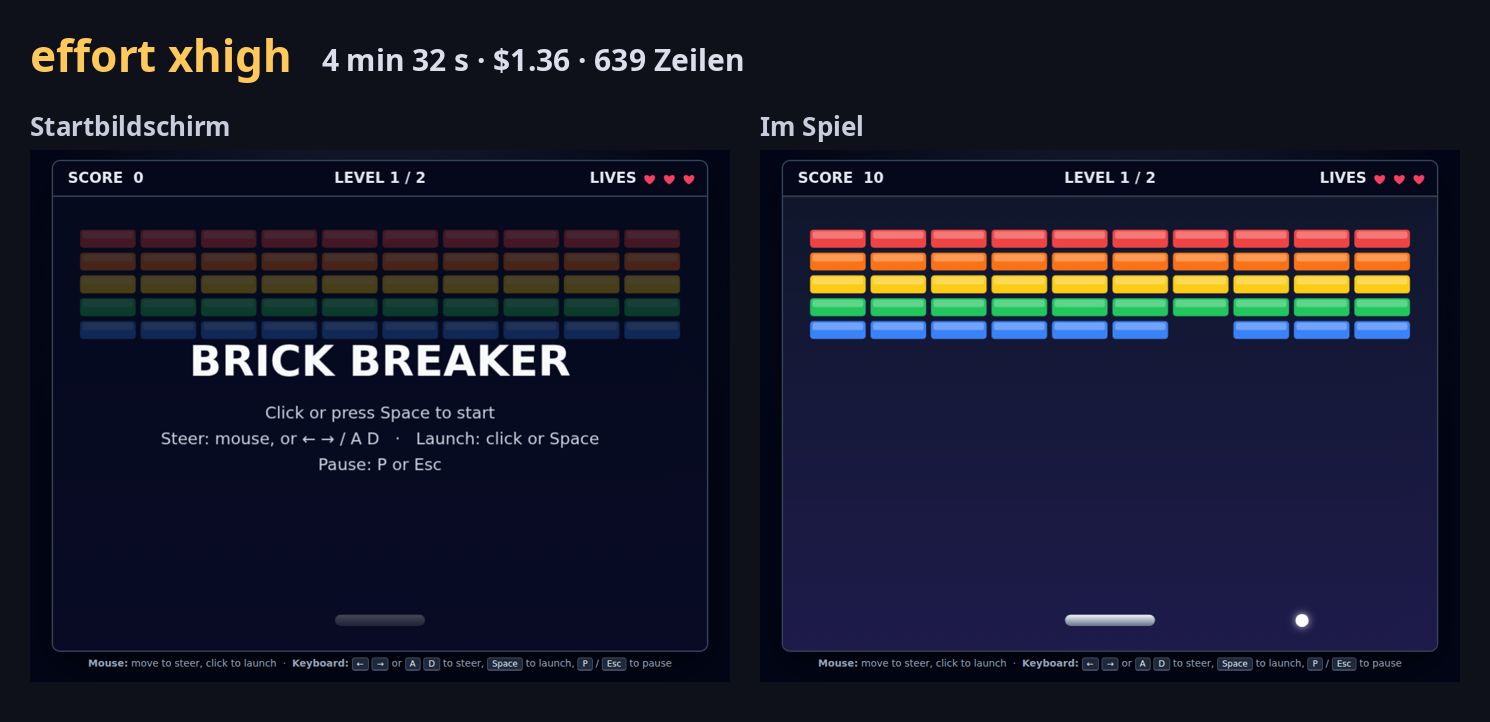
- Was es gebaut hat: Level 2 ist eine Raute, umringt von Stahlsteinen, die nach dem ersten Treffer Risse bekommen. Steine bringen je nach Farbe 10 bis 50 Punkte.
- Gut: Der aufgeräumteste Bildschirm, und das Wechseln zwischen Maus und Tastatur klappt reibungslos: Was Sie zuletzt benutzt haben, bewegt den Schläger.
- Schwach: Der gespeicherte Highscore und die Touch-Steuerung aus high fehlen. Es kostete 143% mehr als medium, ohne gegenüber high Funktionen hinzuzufügen.
- Geeignet, wenn: nicht für kleine Aufgaben wie diese. Laut Anthropic eignet es sich für lang laufende Arbeiten.
max: 22 min 22 s, $5.25
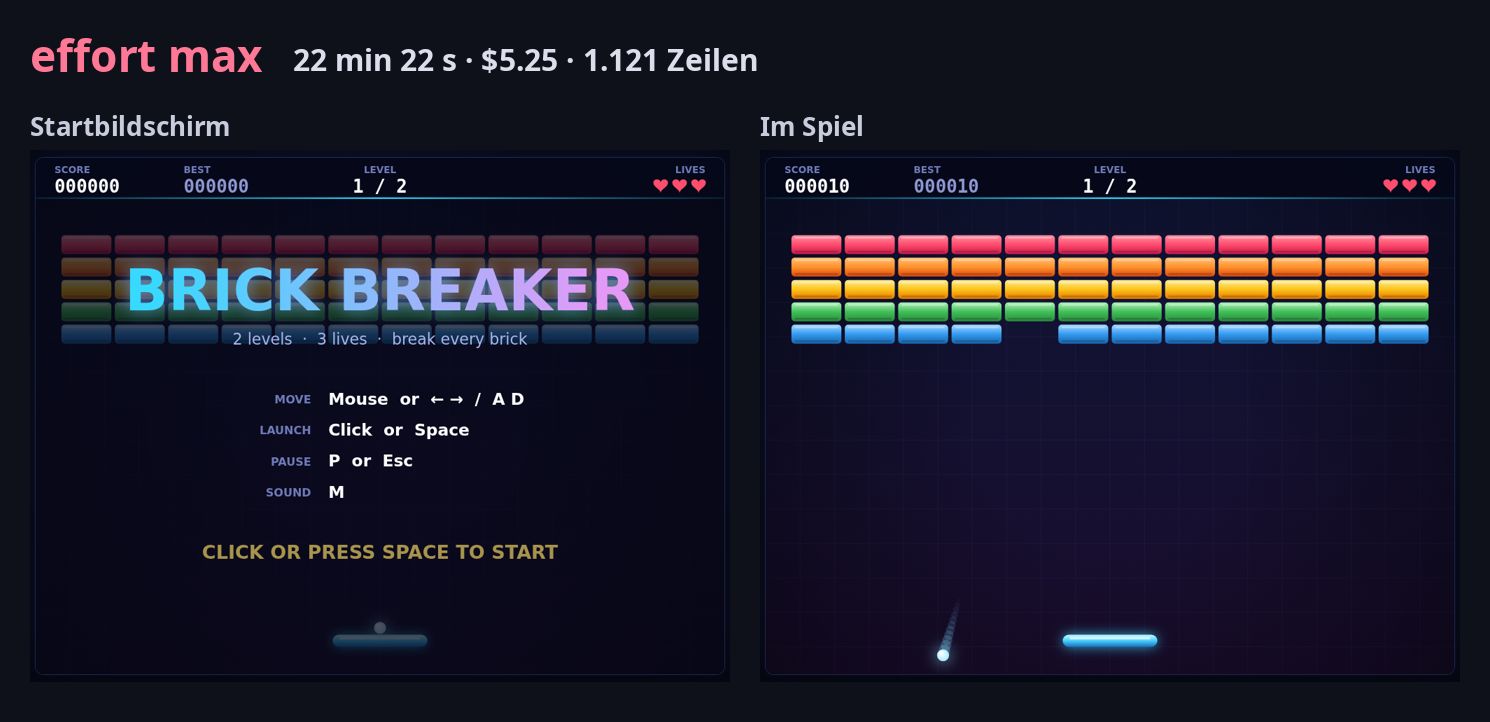
- Was es gebaut hat: Level mit Namen ("Rainbow Wall", "Space Invader"), ein Level 2 in Invader-Form, dessen 14 silberne Steine zwei Treffer aushalten, und ein kürzerer Schläger in Level 2.
- Gut: Soundeffekte (mit M umschaltbar), gespeicherter Highscore, Touch-Steuerung, Bildschirmwackeln, Siegesfeuerwerk und automatische Pause: die meisten Extras aller Stufen. Es wirkt wie ein fertiges Spiel.
- Schwach: Mit Abstand die langsamste Stufe, unter anderem weil es einen automatisierten Spieltest starten wollte, der eine Freigabe brauchte.
- Geeignet, wenn: Qualität an erster Stelle steht und Sie Zeit und Limits übrig haben, oder wenn nichts anderes das Problem löst.
Praxis: medium im Alltag, high fürs Coden
Ich (Jaehyun) nutze Opus 5.5 im Plan Claude Max 20x, um Spiele zu bauen. So fühlt es sich im täglichen Einsatz an, das ist keine Messung.
- Meine Einstellung: Ich lasse effort auf auto. Meist läuft es auf medium und geht beim Coden auf high hoch.
- low: Es wirkte träge, deshalb habe ich es nur ein paar Läufe lang genutzt und dann aufgehört.
- high: Die Ergebnisse sind deutlich besser.
- xhigh und max: Beide habe ich jeweils etwa einen Durchlauf lang ausprobiert und habe selten einen Grund, sie zu nutzen.
Im Vergleich mit den Messungen war low tatsächlich am schnellsten, lieferte aber das schlichteste Ergebnis; das träge Gefühl lag also am Resultat, nicht an der Geschwindigkeit. Der Eindruck, dass high bessere Ergebnisse liefert und xhigh und max selten nötig sind, deckte sich mit den Zahlen.
Was Anthropic empfiehlt
- medium ist stark. In Anthropics Tests erreichte oder übertraf Opus 5.5 auf medium Opus 5 auf high beim Coden und bei Wissensarbeit.
- low kommt beim Coden nah an medium heran, bei deutlich geringeren Kosten, so Anthropic. In unserem Test war der Unterschied im Ergebnis spürbar.
- Heben Sie xhigh und max für Arbeiten auf, bei denen Sie einen Qualitätsgewinn gemessen haben.
- Ein Wechsel des effort mitten im Gespräch kann den Prompt-Cache brechen. In der API ändern Sie effort pro Nachricht, um den Cache zu erhalten.
- Unabhängige Tests bestätigen das. Artificial Analysis stellte fest, dass Opus 5.5 auf max effort pro Aufgabe 63% mehr Output-Tokens verbrauchte als Opus 5 (laut Presseberichten).
Welcher effort für welche Aufgabe
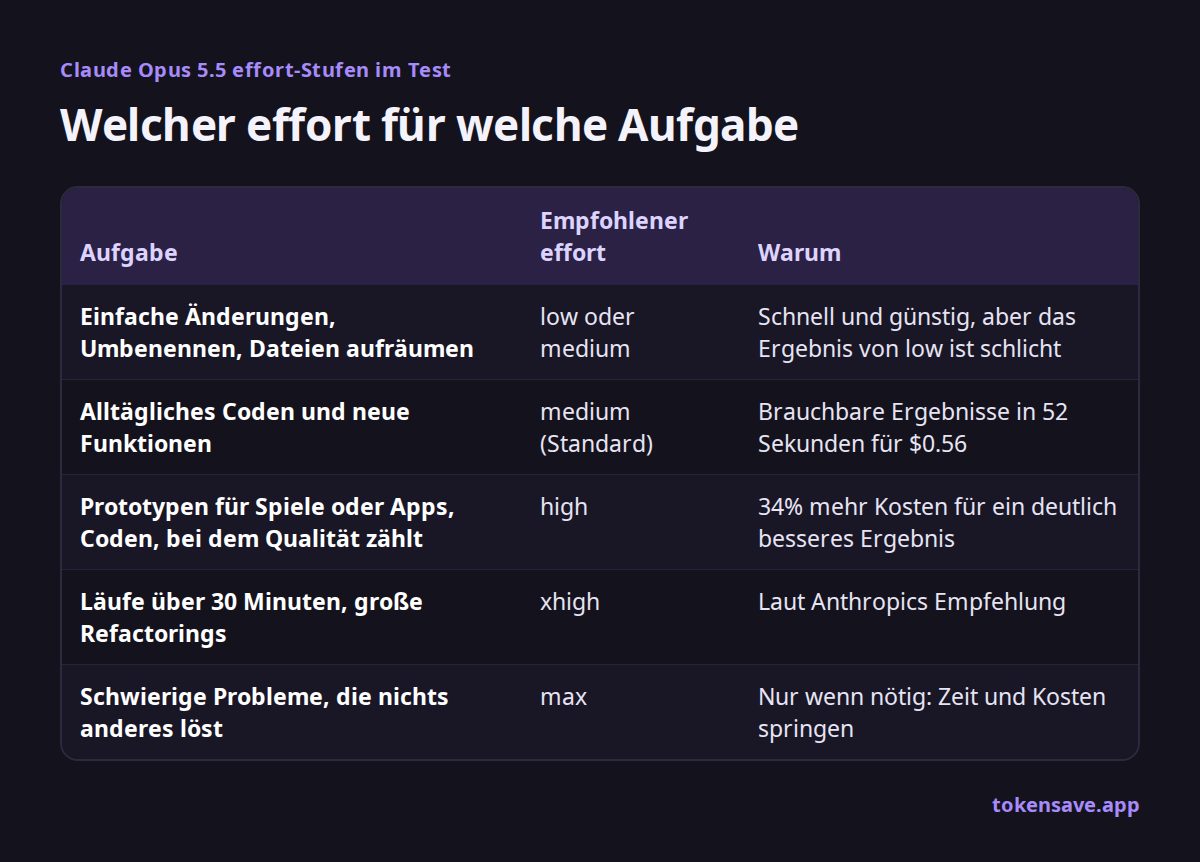
Unsere Empfehlungen, kombiniert aus den Messungen, Jaehyuns Erfahrung und Anthropics Hinweisen:
| Aufgabe | Empfohlener effort | Warum |
|---|---|---|
| Einfache Änderungen, Umbenennen, Dateien aufräumen | low oder medium | Schnell und günstig, aber das Ergebnis von low ist schlicht |
| Alltägliches Coden und neue Funktionen | medium (Standard) | Brauchbare Ergebnisse in 52 Sekunden für $0.56 |
| Prototypen für Spiele oder Apps, Coden, bei dem Qualität zählt | high | 34% mehr Kosten für ein deutlich besseres Ergebnis |
| Läufe über 30 Minuten, große Refactorings | xhigh | Laut Anthropics Empfehlung |
| Schwierige Probleme, die nichts anderes löst | max | Nur wenn nötig: Zeit und Kosten springen |
- Starten Sie mit medium. Stufen Sie nur die Aufgaben auf high hoch, bei denen das Ergebnis nicht reicht.
- Im Abo in Limits denken. Je höher die Kosten zu API-Preisen, desto schneller ist Ihr Max- oder Pro-Limit aufgebraucht. Ein max-Lauf verbrauchte mehr als neun medium-Läufe.
- Einschränkung: ein Lauf pro Stufe bei einer recht kleinen Aufgabe. Größere Projekte können andere Abstände zeigen.
Fazit: standardmäßig medium, high wenn es darauf ankommt
- Standard: medium. Brauchbare Ergebnisse in 52 Sekunden für $0.56.
- Wenn Qualität zählt: high. Nur 34% mehr als medium für ein deutlich besseres Ergebnis. Das beste Preis-Leistungs-Verhältnis der fünf.
- xhigh: für kleine Aufgaben überspringen. 143% mehr als medium, aber nicht mehr Funktionen als high. Lohnt sich nur bei langen Läufen.
- max: nur wenn Sie es brauchen. Das auffälligste Ergebnis, aber 22 Minuten und $5.25.
- low: nicht empfohlen. 8 Cent Ersparnis gegenüber medium bringen Ihnen nur ein schlichteres Ergebnis.
Häufige Fragen
Was ist der Standard-effort von Opus 5.5? medium. Bei Opus 5 war high voreingestellt. API-Anfragen ohne gesetzten effort laufen bei Opus 5.5 auf medium.
Ist max immer besser? In unserem Test brachte es die meisten Funktionen und den meisten Feinschliff, brauchte aber 22 Minuten und $5.25 gegenüber 52 Sekunden und $0.56 bei medium. Zu viel für einfache Arbeiten.
Spart low viel? In unserem Test war low nur 14% günstiger als medium. Angesichts des schlichteren Ergebnisses ist medium die bessere Wahl.
Rechnen Sie es für Ihre eigene Arbeit durch
Im Kostenrechner für Coding-Agents geben Sie Aufgabengröße und Aufgaben pro Tag ein und sehen einen Monat mit Opus 5.5. Die Kosten eines einzelnen Prompts prüfen Sie im Token-Zähler. Zu den Preis- und Leistungsunterschieden zwischen Opus 5 und 5.5 siehe Claude Opus 5 vs 5.5 (auf Englisch).
Gemessen am 9. Oktober 2026. Die Kosten sind die Umrechnung von ccusage zu API-Preisen; die Ergebnisse können sich mit Updates des Modells und von Claude Code ändern.
Quellen
- Anthropic: Effort
- Anthropic: Prompting für Claude Opus 5.5
- Anthropic: Umstieg von Claude Opus 5 auf Opus 5.5
- OfficeChai: Bericht zum Artificial Analysis Intelligence Index
- ccusage: Nutzungs-Tool für Claude Code (GitHub)
Weitere Artikel
- ChatGPT kostenlos vs. Plus 2026: Lohnt sich das Bezahl-Abo?
- KI-Abos im Preisvergleich 2026: ChatGPT, Claude, Gemini in Euro
- Gemini kostenlos nur noch mit Flash-Lite: Was sich ab 9. Oktober ändert
- ChatGPT Go vs. Plus: Lohnen sich 15 € mehr im Monat?
- Deutsch braucht in GPT 26 % mehr Tokens als Englisch
Geben Sie Aufgabengröße und Aufgaben pro Tag ein, um einen Monat mit Opus 5.5, Sonnet 5.5 und GPT-6 Sol zu vergleichen.
Kostenrechner für Coding-Agents öffnen →