 TokenSave
Deutsch braucht in GPT 1,26× so viele Tokens wie Englisch
Jonhisking · 2026-10-01
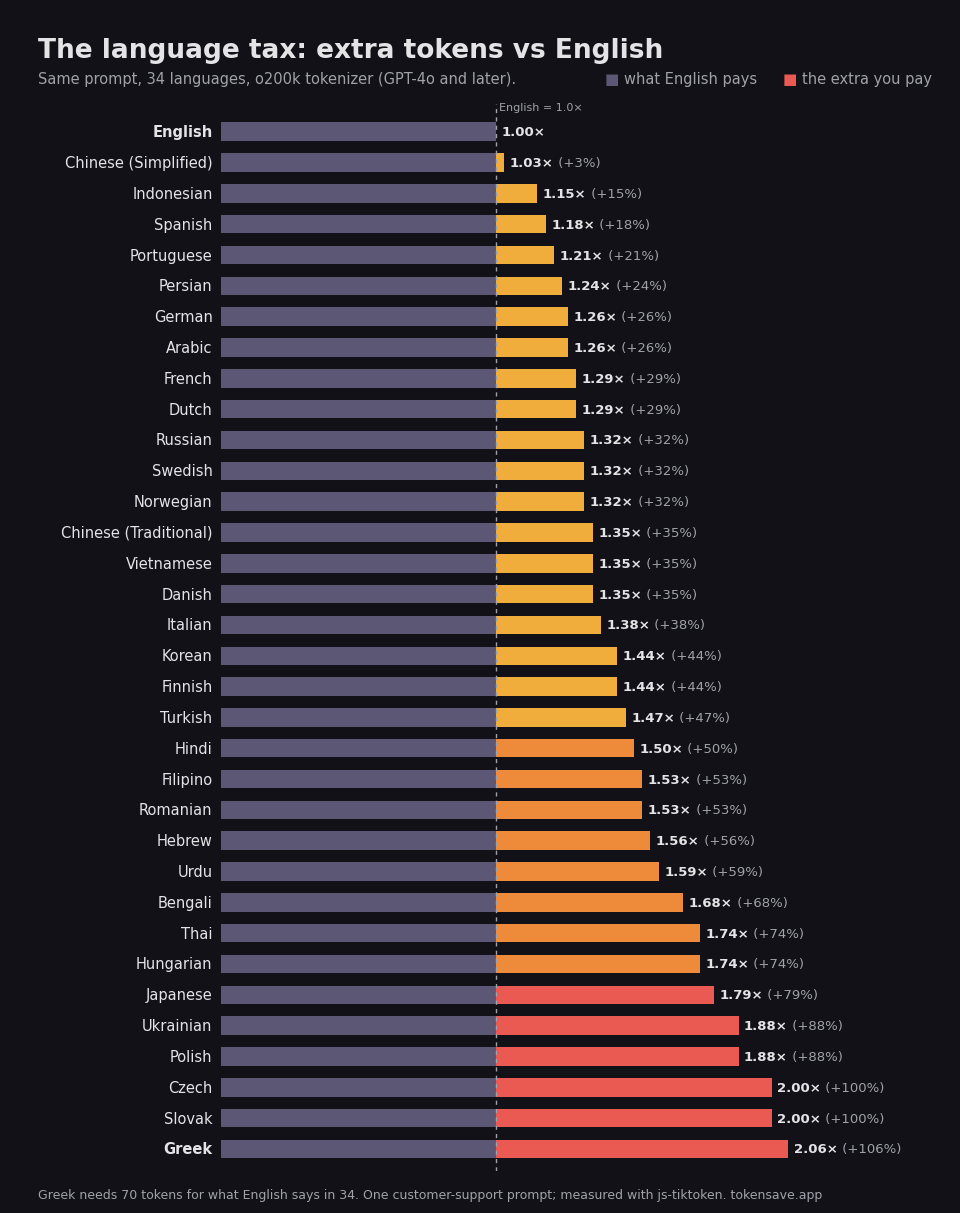
Ich habe denselben Kundenservice-Prompt in 34 Sprachen übersetzt und die Tokens mit o200k_base gezählt, dem aktuellen Tokenizer von OpenAI (GPT-4o und neuer). Englisch braucht 34 Tokens, Deutsch 43 – also 1,26× so viele, Platz 7 von 34 (1 = am günstigsten).
Die deutsche Fassung:
Fasse die folgende Kunden-E-Mail in drei Stichpunkten zusammen und schlage eine höfliche Antwort vor. Der Kunde sagt, dass die Bestellung zwei Tage zu spät ankam und ein Artikel im Paket fehlte.
Ergebnisse
| Sprache | Tokens | Im Vergleich zu Englisch | Alter GPT-4-Tokenizer |
|---|---|---|---|
| English | 34 | 1,00× | 1,00× |
| 简体中文 | 35 | 1,03× | 1,53× |
| Español | 40 | 1,18× | 1,29× |
| Deutsch | 43 | 1,26× | 1,50× |
| 한국어 | 49 | 1,44× | 2,50× |
| 日本語 | 61 | 1,79× | 2,21× |
| Čeština | 68 | 2,00× | 2,59× |
| Ελληνικά | 70 | 2,06× | 4,94× |
Warum
Der Tokenizer lernt vor allem aus englischem Text: Wörter wie „ polite“ oder „ customer“ sind ein einziger Token, deutsche Wörter – besonders Komposita – werden dagegen zerlegt:
- Kunden-E-Mail →
Kunden | -E | -Mail· 3 - Stichpunkten →
Stich | punk | ten· 3 - höfliche →
höf | liche· 2
Im Vergleich zum alten Tokenizer
Mit dem Tokenizer aus der GPT-4-Zeit (cl100k) brauchte derselbe Prompt 1,50×, heute 1,26×.
In Geld
Bei einem Modell mit 2 $ pro 1 Mio. Input-Tokens kostet es 68 $ auf Englisch und 86 $ auf Deutsch, diesen Prompt eine Million Mal zu senden. Antwortet das Modell auch auf Deutsch, gilt derselbe Faktor für die Output-Tokens, die meist 4–5× teurer sind.
So sparst du
- System-Prompt und feste Anweisungen auf Englisch schreiben; nur die Eingaben der Nutzer bleiben auf Deutsch.
- Zwischenschritte (Klassifizierung, Extraktion, Tool-Aufrufe) auf Englisch oder als JSON ausgeben lassen, nur die finale Antwort auf Deutsch.
- Prompt Caching für den festen Teil des Prompts nutzen.
Einschränkungen
- Gemessen wurde ein einziger Prompt; bei anderen Texten kann der Faktor um ±0,1–0,2 abweichen.
- Claude und Gemini haben andere Tokenizer – die Zahlen gelten nur für OpenAI-Modelle.
- Die Übersetzung basiert auf einer geprüften maschinellen Übersetzung.
Alle Ergebnisse für 34 Sprachen (auf Englisch): Vergleich von 34 Sprachen
Miss deinen eigenen Text: wie viele Tokens und wie viel Geld dein deutscher Prompt im Vergleich zu Englisch kostet.
Token-Zähler öffnen →