 TokenSave
O português gasta 1,21× mais tokens que o inglês no GPT
Jonhisking · 2026-10-01
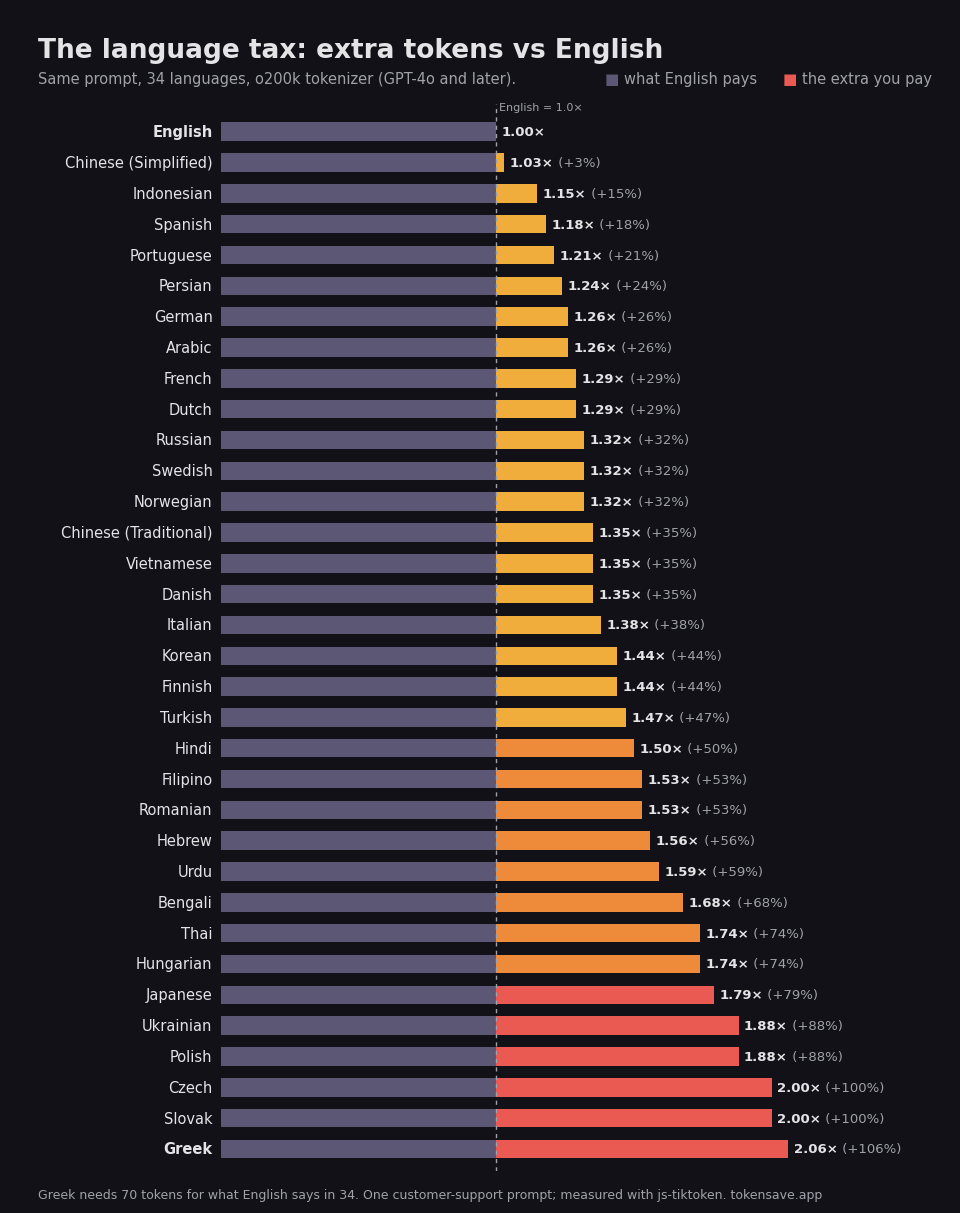
Traduzi o mesmo prompt de atendimento ao cliente para 34 idiomas e contei os tokens com o o200k_base, o tokenizador atual da OpenAI (GPT-4o e posteriores). Em inglês são 34 tokens; em português, 41: 1,21× o inglês, posição 5 de 34 (1 = o mais barato).
A versão em português:
Resuma o e-mail do cliente abaixo em três tópicos e sugira uma resposta educada. O cliente diz que o pedido chegou com dois dias de atraso e que faltava um item na caixa.
Resultados
| Idioma | Tokens | Em relação ao inglês | Tokenizador antigo do GPT-4 |
|---|---|---|---|
| English | 34 | 1,00× | 1,00× |
| 简体中文 | 35 | 1,03× | 1,53× |
| Español | 40 | 1,18× | 1,29× |
| Português | 41 | 1,21× | 1,41× |
| Deutsch | 43 | 1,26× | 1,50× |
| 한국어 | 49 | 1,44× | 2,50× |
| 日本語 | 61 | 1,79× | 2,21× |
| Čeština | 68 | 2,00× | 2,59× |
| Ελληνικά | 70 | 2,06× | 4,94× |
Por quê
O tokenizador aprende principalmente com texto em inglês: palavras como " polite" ou " customer" são um único token, enquanto muitas palavras em português são quebradas em pedaços:
- tópicos →
tóp | icos· 2 - educada →
educ | ada· 2 - faltava →
falt | ava· 2
Comparado ao tokenizador antigo
No tokenizador da era GPT-4 (cl100k), o mesmo prompt custava 1,41×; hoje custa 1,21×.
Em dinheiro
Com um modelo a US$ 2 por milhão de tokens de entrada, enviar este prompt um milhão de vezes custa US$ 68 em inglês e US$ 82 em português. Se a resposta também vier em português, o mesmo multiplicador vale para os tokens de saída, que costumam custar 4–5× mais.
Como economizar
- Escreva o prompt de sistema e as instruções fixas em inglês; deixe em português só o que o usuário digita.
- Peça as etapas intermediárias (classificação, extração, chamadas de ferramentas) em inglês ou JSON e só a resposta final em português.
- Use prompt caching para a parte fixa do prompt.
Limitações
- É um único prompt; com outros textos a proporção pode variar ±0,1–0,2.
- Claude e Gemini usam outros tokenizadores: estes números valem só para modelos da OpenAI.
- A tradução parte de uma tradução automática revisada.
Resultados completos dos 34 idiomas (em inglês): comparação de 34 idiomas
Meça seu próprio texto: quantos tokens e quanto dinheiro seu prompt em português custa em relação ao inglês.
Abrir o contador de tokens →