 TokenSave
Claude Opus 5.5: níveis de effort testados, do low ao max
Jonhisking · 9 de outubro de 2026
O Claude Opus 5.5 tem uma configuração de effort que controla o quanto o modelo pensa, com cinco níveis: low, medium, high, xhigh e max. Em tese, níveis mais altos dão resultados melhores, mas a documentação oficial não traz números sobre quanto tempo e dinheiro extra cada nível custa. Por isso, em 9 de outubro de 2026, rodamos o mesmo pedido de criação de jogo uma única rodada em cada nível e comparamos tempo, tokens, custo e resultado. O nível mais rápido levou 32 segundos e o mais lento, 22 minutos. Veja o que mudou em cada nível e qual nível usar em cada tipo de tarefa, junto com a experiência de uso no dia a dia.
O que é o effort
- Ele define o quanto o modelo pensa. No Opus 5.5 não dá para desligar o raciocínio; o effort controla a profundidade. Os tokens de raciocínio são cobrados como tokens de saída.
- O padrão é medium. O Opus 5 usava high como padrão; o Opus 5.5 usa um nível abaixo, medium (segundo a documentação da Anthropic).
- Como mudar: no Claude Code, use a opção
--effort(de low a max); na API, defina o valoreffort.
Como medimos
- Modelo: Claude Opus 5.5 no Claude Code, em um PC com Windows
- Prompt (literal): "Make a brick-breaker game that runs in the browser as a single file named index.html in the current folder. It needs 2 levels, a score display and 3 lives, and it must be playable with the keyboard and the mouse. Write the file and finish." Ou seja: um jogo de quebrar tijolos para o navegador em um único arquivo index.html, com 2 fases, placar e 3 vidas, jogável com teclado e mouse.
- Método: o mesmo prompt em cinco execuções, mudando apenas o effort. Cada nível rodou em uma pasta própria para que uma execução não influenciasse a outra.
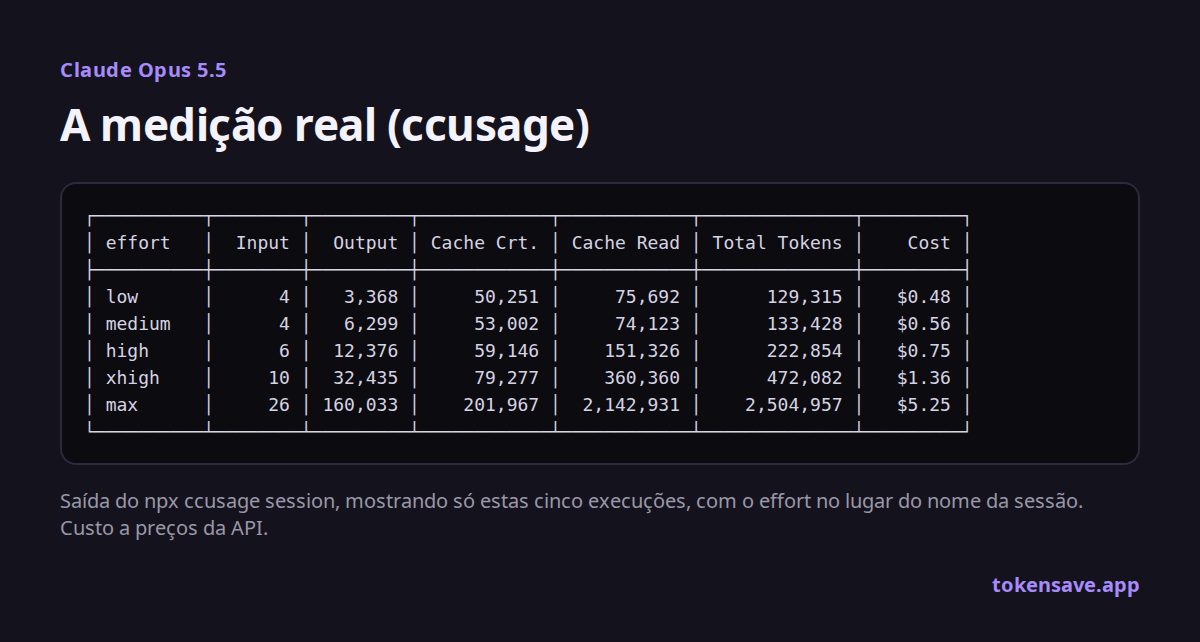
- Medição: tokens e custo com a ferramenta gratuita ccusage; tempo pelos registros de início e fim. O custo foi convertido a preços da API.
Resultados: tempo, tokens e custo
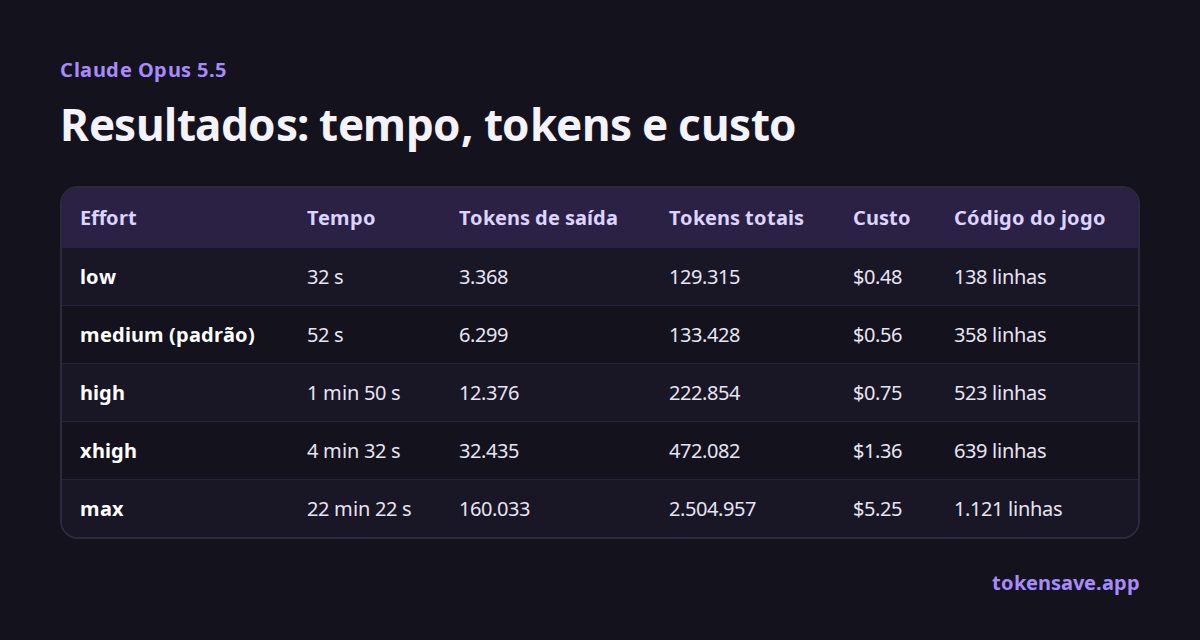
| Effort | Tempo | Tokens de saída | Tokens totais | Custo | Código do jogo |
|---|---|---|---|---|---|
| low | 32 s | 3.368 | 129.315 | $0.48 | 138 linhas |
| medium (padrão) | 52 s | 6.299 | 133.428 | $0.56 | 358 linhas |
| high | 1 min 50 s | 12.376 | 222.854 | $0.75 | 523 linhas |
| xhigh | 4 min 32 s | 32.435 | 472.082 | $1.36 | 639 linhas |
| max | 22 min 22 s | 160.033 | 2.504.957 | $5.25 | 1.121 linhas |
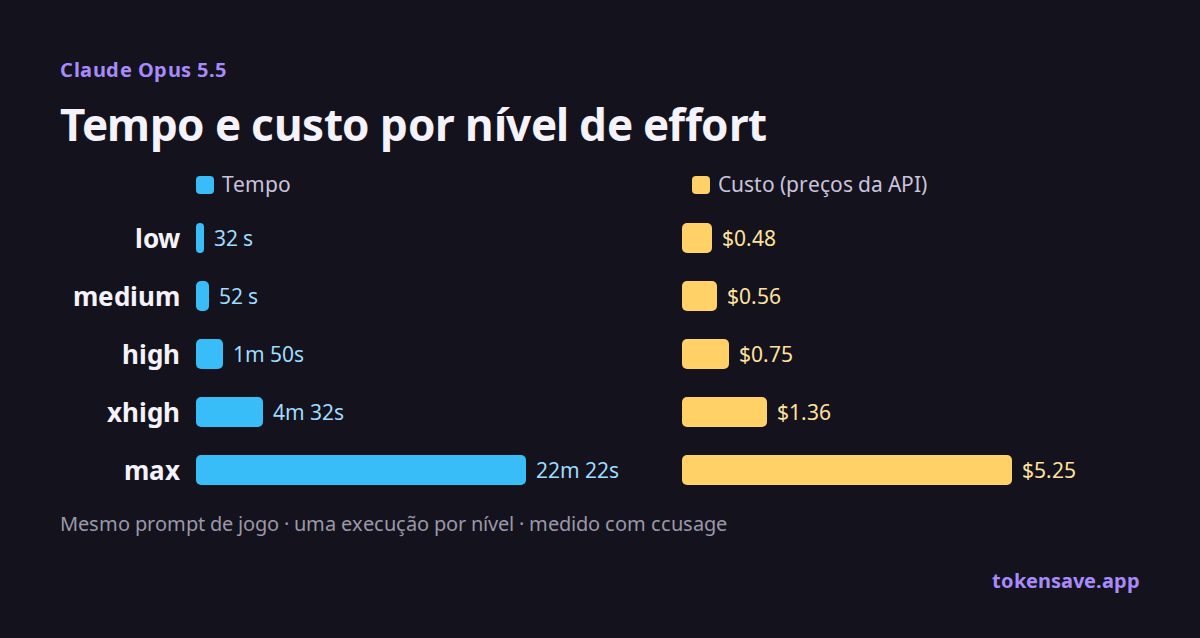
- Low e medium são quase iguais. O low custou 14% menos e levou 38% menos tempo, mas a diferença é de 8 centavos.
- O high custou só 34% a mais que o medium. O tempo foi de 52 segundos para 1 minuto e 50 segundos.
- É no xhigh que o custo dispara. Custou 143% a mais que o medium e levou 4 minutos e 32 segundos.
- O max está em outra categoria. O medium levou 52 segundos e $0.56; o max levou 22 minutos e 22 segundos e $5.25. Os tokens de saída foram de 6.299 para 160.033.
Os cinco jogos lado a lado
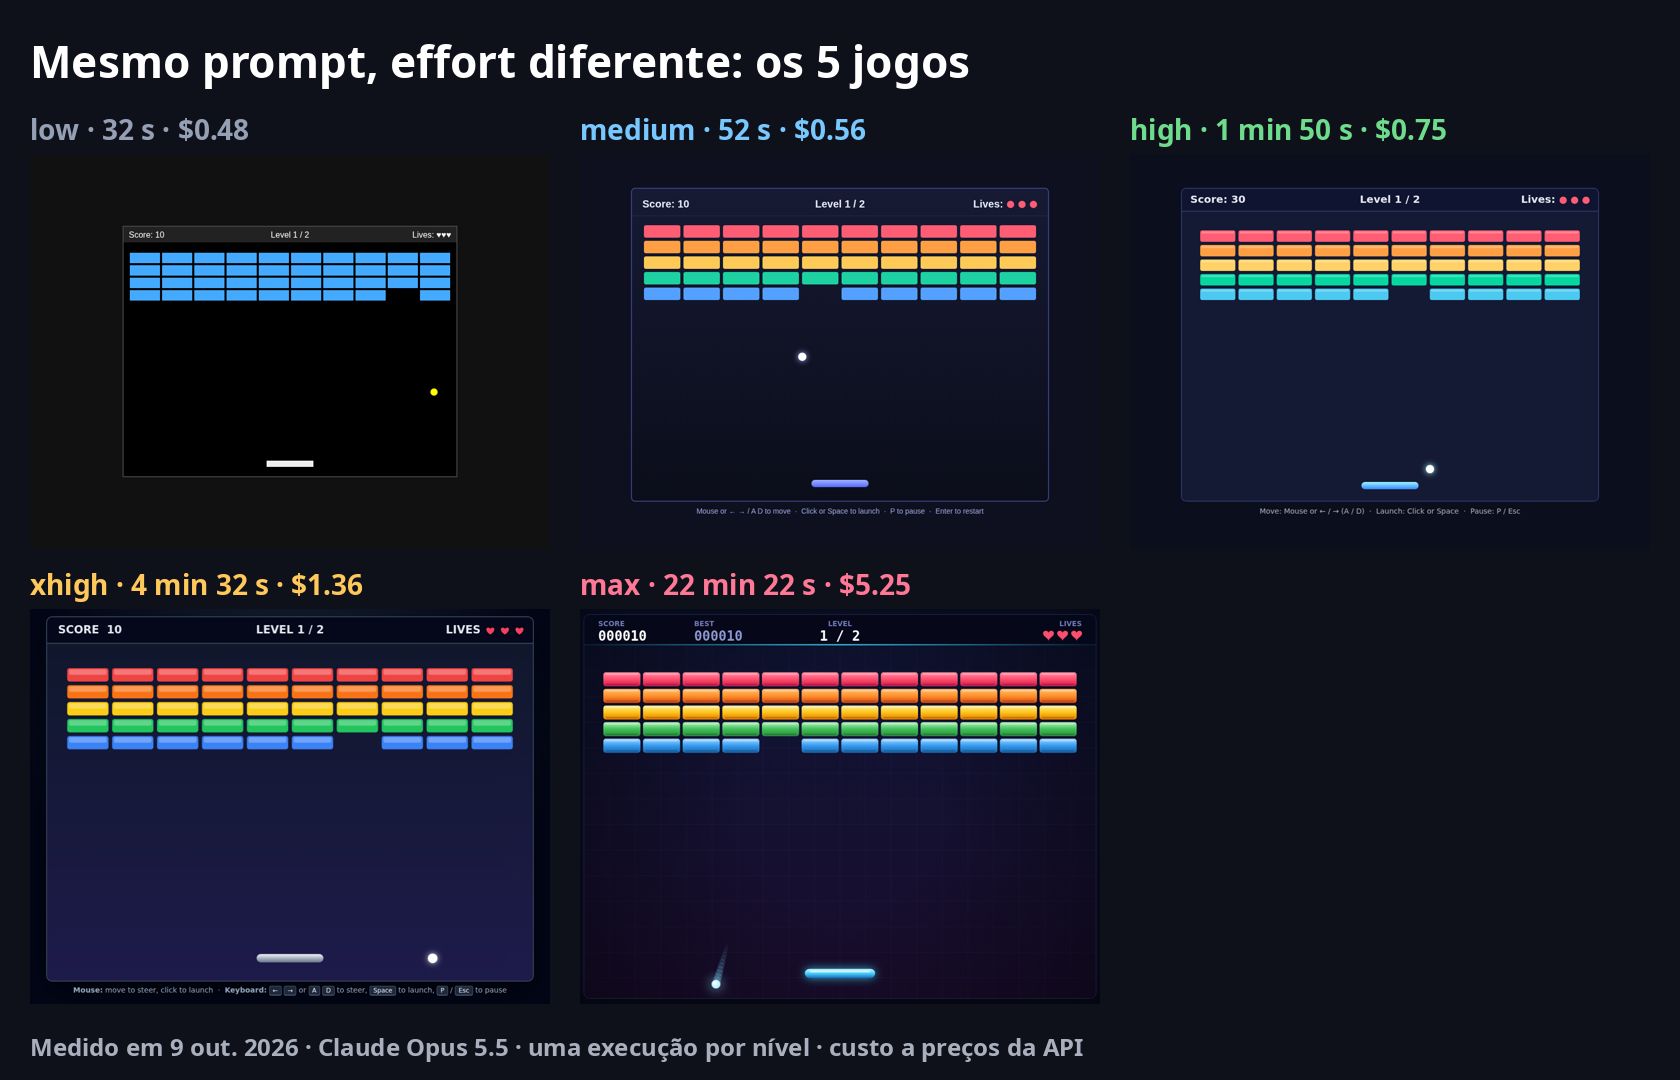
Os cinco jogos rodaram sem erros e cumpriram o pedido: 2 fases, placar, 3 vidas, controles por teclado e mouse. As diferenças estão no que cada nível acrescentou por conta própria.
| Effort | O que acrescentou |
|---|---|
| low | Tijolos de uma cor só, a tela mais simples, sem pausa |
| medium | Tijolos em arco-íris, pausa, reinício |
| high | + efeitos de partículas, recorde salvo |
| xhigh | Efeitos de partículas, visual mais caprichado (sem recorde salvo) |
| max | + efeitos sonoros, nomes de fase, fase 2 em formato de invasor, tremor de tela, fogos de vitória |
- A partir do high, o modelo tentou verificar o próprio trabalho. O high e o xhigh tentaram uma checagem de sintaxe do código, e o max tentou um teste de jogo automatizado. Os três precisavam de permissão para rodar, então nenhum chegou a rodar; cada um diz que releu o código no lugar disso. O low e o medium terminaram sem verificar nada.
- Tijolos que precisam de dois golpes apareceram em todos os níveis, mesmo sem termos pedido.
Análise nível a nível
Jogamos cada jogo e comparamos com o resumo que o modelo deixou no final e com o próprio código.
low: 32 s, $0.48
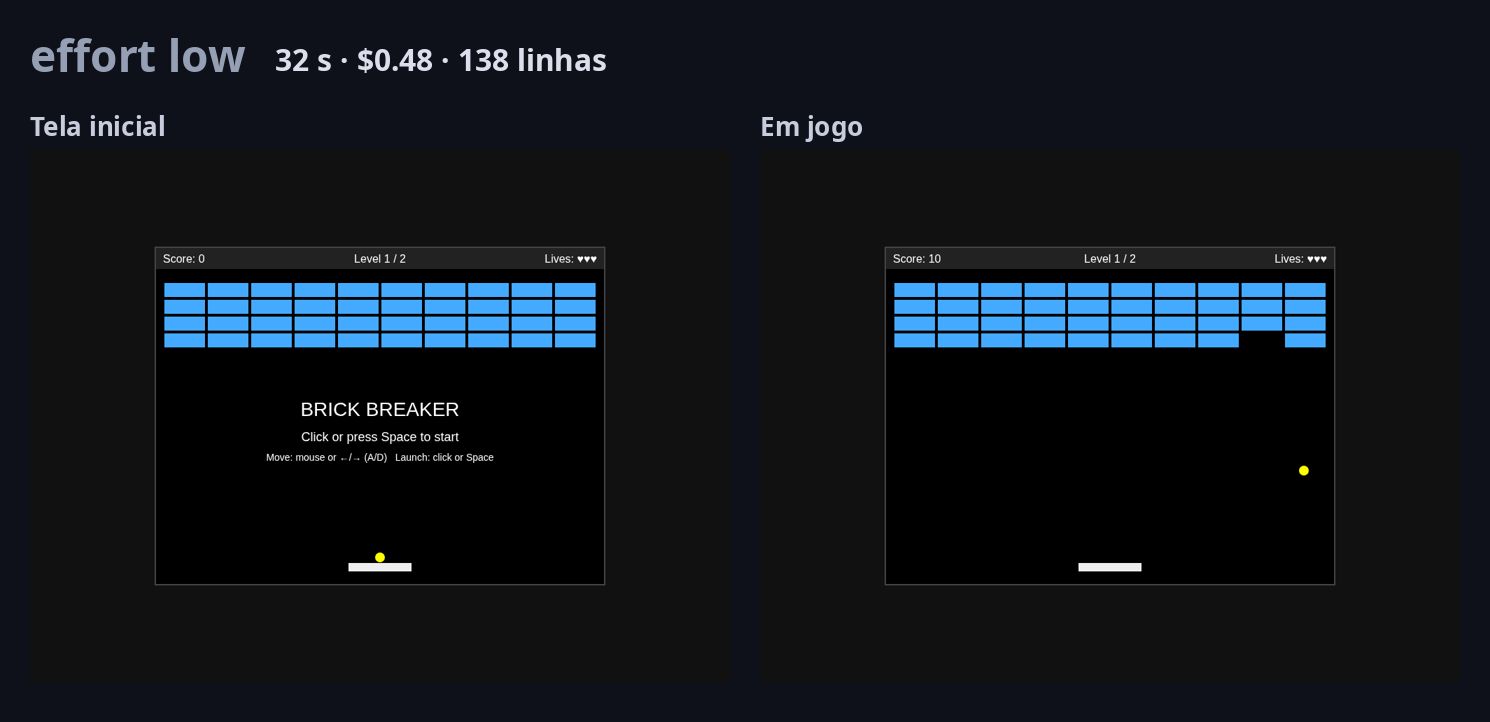
- O que construiu: a fase 1 tem quatro fileiras de tijolos azuis; a fase 2 mistura tijolos laranja que precisam de dois golpes com espaços vazios, e a bola é mais rápida. Tem telas de fase concluída, game over e vitória, além de reinício.
- Pontos fortes: todos os recursos pedidos estão lá, e o ponto em que a bola bate na raquete muda o ângulo. Pronto em 32 segundos.
- Pontos fracos: fundo preto e tijolos de uma cor só deixam este o mais simples. Não tem pausa e, com 138 linhas, é o código mais curto.
- Quando usar: quando você só precisa conferir se algo funciona e vai refinar depois.
medium: 52 s, $0.56 (padrão)
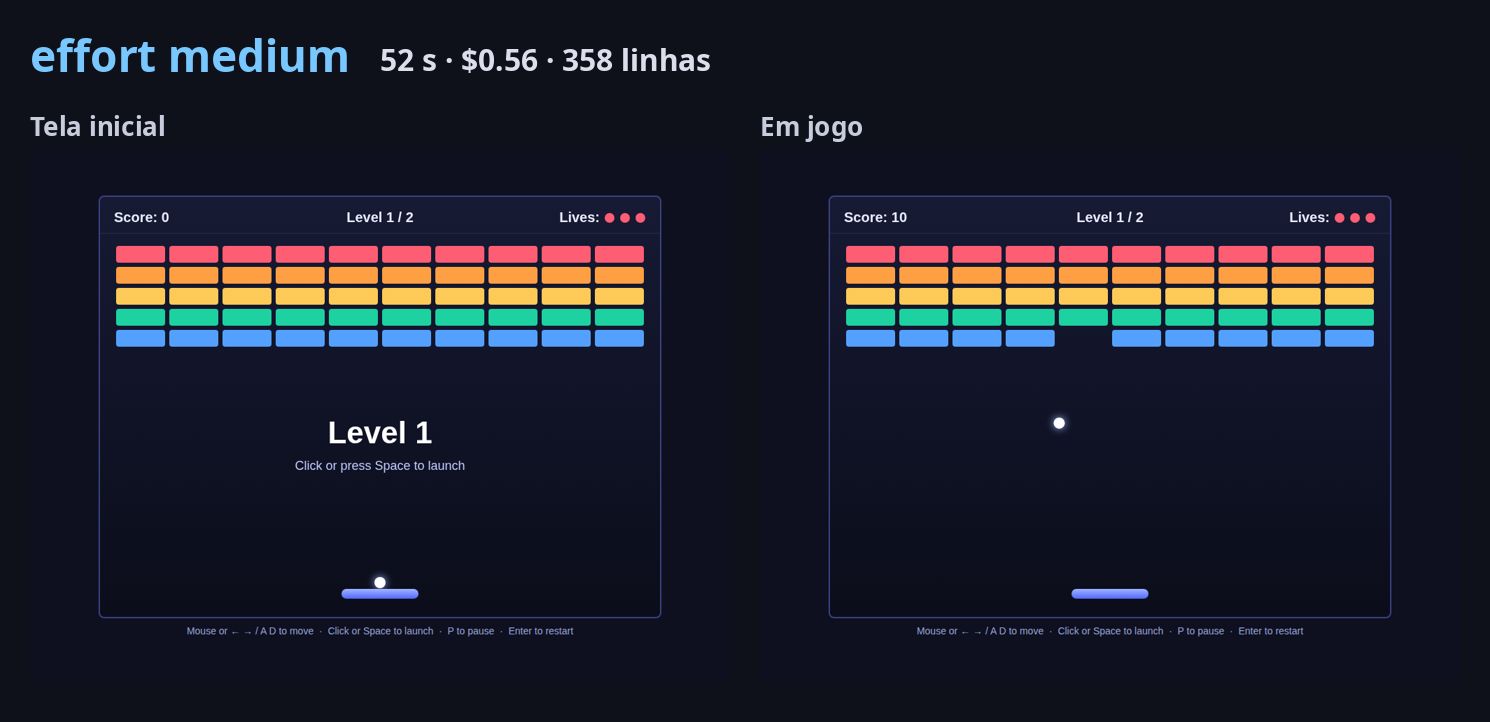
- O que construiu: a fase 1 é uma grade 5×10 em arco-íris; a fase 2 tem espaços vazios e tijolos que precisam de 2 ou 3 golpes, mostrando os golpes restantes e desbotando conforme levam dano.
- Pontos fortes: pausa (P ou Esc), reinício (Enter) e pausa automática quando a janela perde o foco. A pontuação depende da resistência do tijolo e da fase.
- Pontos fracos: sem som nem efeitos de partículas.
- Quando usar: na maior parte do tempo. Custa 8 centavos a mais que o low e é um avanço claro.
high: 1 min 50 s, $0.75
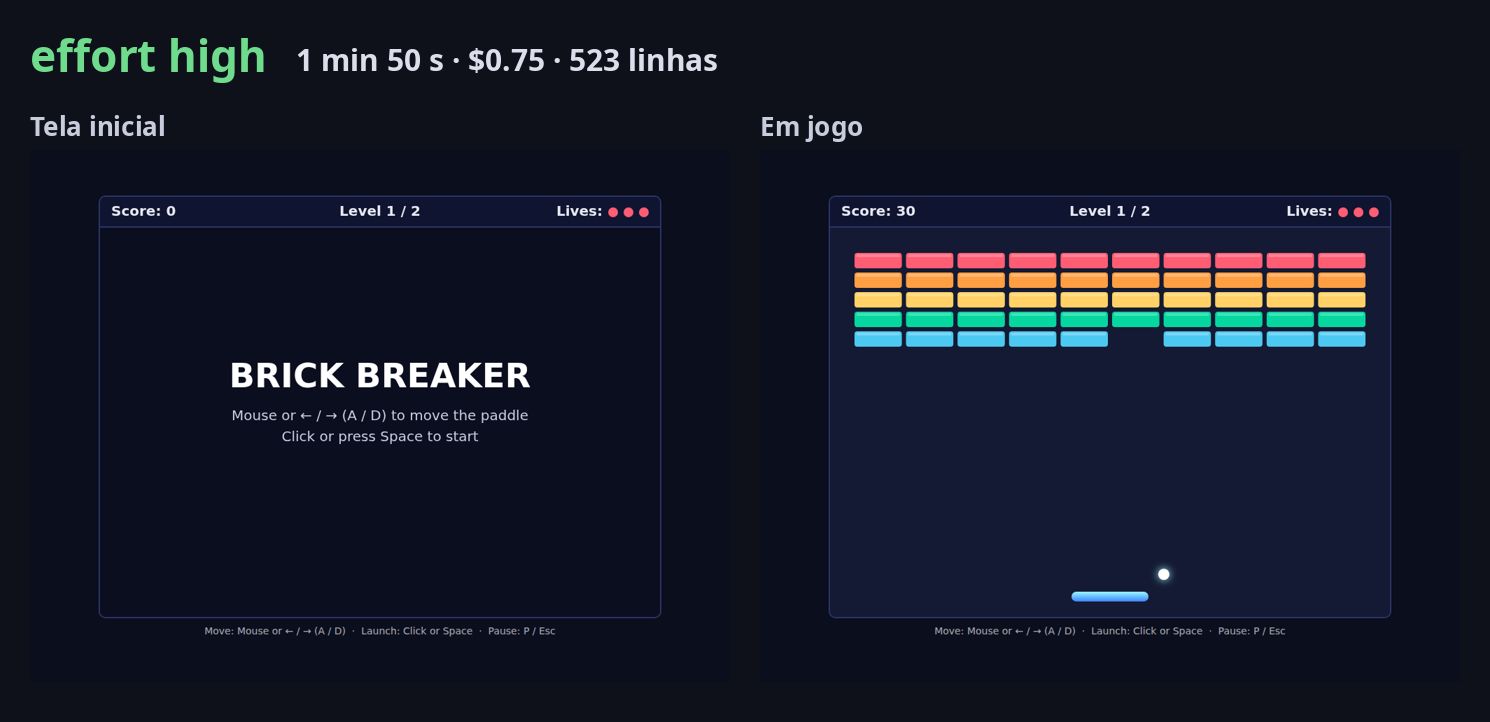
- O que construiu: a fase 2 é um padrão em losango de tijolos que precisam de 2 ou 3 golpes, e os tijolos soltam partículas ao quebrar.
- Pontos fortes: bônus por concluir a fase, bônus pelas vidas restantes, recorde salvo e controles por toque. Também tentou uma checagem de sintaxe no próprio código.
- Pontos fracos: levou 112% mais tempo que o medium (de 52 segundos para 1 minuto e 50 segundos).
- Quando usar: quando você precisa de um protótipo para mostrar a outras pessoas ou em programação em que a qualidade importa. Custou só 34% a mais que o medium.
xhigh: 4 min 32 s, $1.36
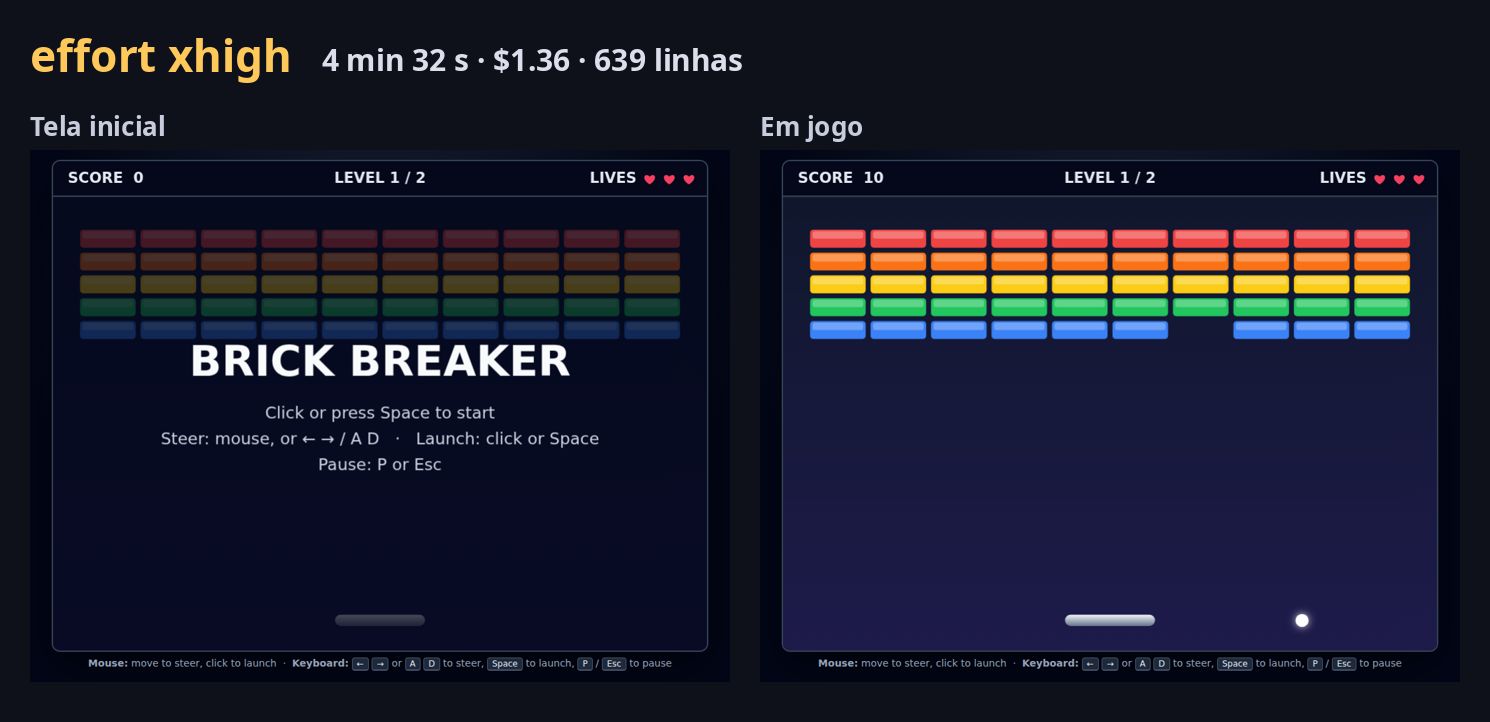
- O que construiu: a fase 2 é um losango cercado por tijolos de aço que racham após o primeiro golpe. Os tijolos valem de 10 a 50 pontos conforme a cor.
- Pontos fortes: a tela de visual mais caprichado, e alternar entre mouse e teclado funciona bem: o último que você usou é o que move a raquete.
- Pontos fracos: perdeu o recorde salvo e os controles por toque que o high tinha. Custou 143% a mais que o medium sem acrescentar recursos em relação ao high.
- Quando usar: não em tarefas pequenas como esta. Segundo a Anthropic, ele é indicado para trabalhos longos.
max: 22 min 22 s, $5.25
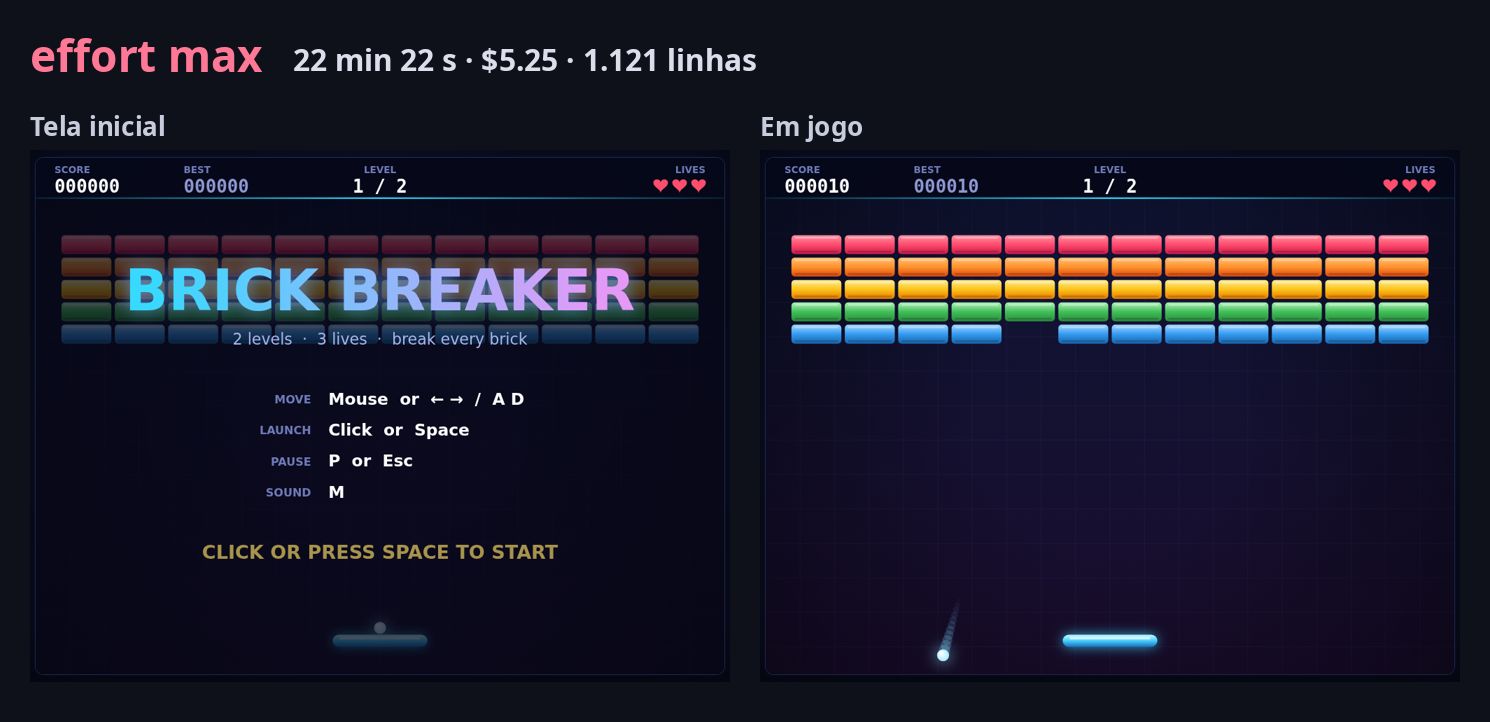
- O que construiu: fases com nome ("Rainbow Wall", "Space Invader"), uma fase 2 em formato de invasor cujos 14 tijolos prateados precisam de dois golpes, e uma raquete mais estreita na fase 2.
- Pontos fortes: efeitos sonoros (M liga e desliga), recorde salvo, controles por toque, tremor de tela, fogos de vitória e pausa automática: o máximo entre todos os níveis. Parece um jogo finalizado.
- Pontos fracos: de longe o mais lento, em parte porque tentou rodar um teste de jogo automatizado que precisava de permissão.
- Quando usar: quando a qualidade é o mais importante e você tem tempo e limite de sobra, ou quando nada mais resolve o problema.
Na prática: medium no dia a dia, high para programar
Eu (Jaehyun) uso o Opus 5.5 no plano Claude Max 20x para criar jogos. Esta é a sensação no uso diário, não uma medição.
- Minha configuração: deixo o effort no automático. Normalmente ele roda em medium e sobe para high quando estou programando.
- low: pareceu fraco, então usei algumas poucas rodadas e parei.
- high: os resultados são claramente melhores.
- xhigh e max: testei cada um mais ou menos em uma única rodada e raramente tenho motivo para usá-los.
Comparando com as medições, o low foi na verdade o mais rápido, mas entregou o resultado mais simples, então a sensação de fraqueza vinha do resultado, e não da velocidade. A impressão de que o high dá resultados melhores, e de que o xhigh e o max raramente são necessários, bateu com os números.
O que a Anthropic recomenda
- O medium é forte. Nos testes da Anthropic, o Opus 5.5 em medium igualou ou superou o Opus 5 em high em programação e trabalho com conhecimento.
- O low chega perto do medium em programação, com custo bem menor, segundo a Anthropic. No nosso teste, a diferença no resultado foi perceptível.
- Reserve o xhigh e o max para trabalhos em que você mediu um ganho de qualidade.
- Mudar o effort no meio da conversa pode quebrar o cache de prompt. Na API, use a mudança de effort por mensagem para manter o cache.
- Testes independentes concordam. A Artificial Analysis constatou que o Opus 5.5 em effort max usou 63% mais tokens de saída por tarefa que o Opus 5 (segundo a imprensa).
Qual effort para cada tarefa
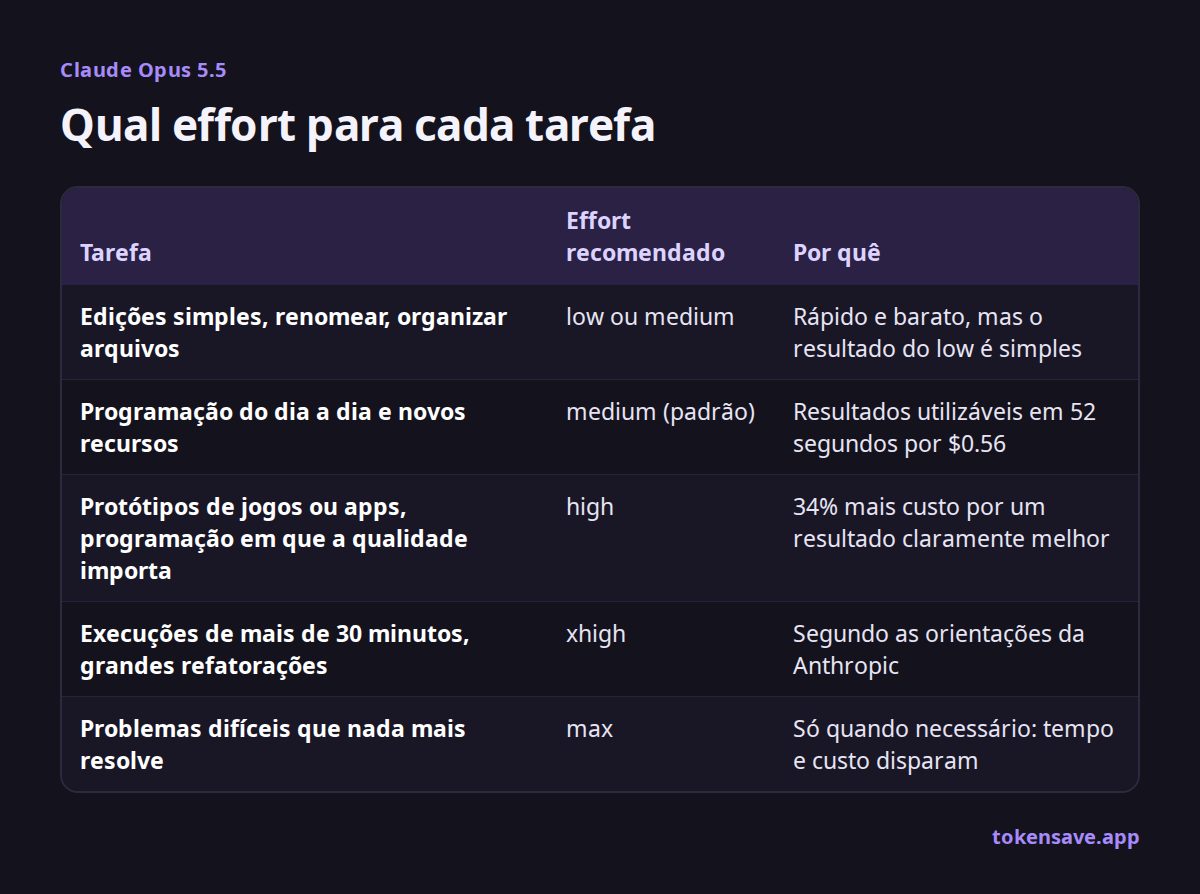
Nossas recomendações, combinando as medições, a experiência de Jaehyun e as orientações da Anthropic:
| Tarefa | Effort recomendado | Por quê |
|---|---|---|
| Edições simples, renomear, organizar arquivos | low ou medium | Rápido e barato, mas o resultado do low é simples |
| Programação do dia a dia e novos recursos | medium (padrão) | Resultados utilizáveis em 52 segundos por $0.56 |
| Protótipos de jogos ou apps, programação em que a qualidade importa | high | 34% mais custo por um resultado claramente melhor |
| Execuções de mais de 30 minutos, grandes refatorações | xhigh | Segundo as orientações da Anthropic |
| Problemas difíceis que nada mais resolve | max | Só quando necessário: tempo e custo disparam |
- Comece no medium. Suba para high apenas as tarefas em que o resultado ficar aquém.
- Em um plano, pense em limites. Quanto maior o custo equivalente na API, mais rápido seu limite do Max ou do Pro se esgota. Uma execução em max consumiu mais do que nove execuções em medium.
- Ressalva: uma execução por nível, em uma tarefa relativamente pequena. Projetos maiores podem mostrar diferenças distintas.
Conclusão: medium como padrão, high quando importa
- Padrão: medium. Resultados utilizáveis em 52 segundos por $0.56.
- Quando a qualidade importa: high. Só 34% a mais que o medium por um resultado claramente melhor. O melhor custo-benefício dos cinco.
- xhigh: dispense em tarefas pequenas. 143% a mais que o medium, sem mais recursos que o high. Vale a pena só em execuções longas.
- max: só quando precisar. O resultado mais vistoso, mas 22 minutos e $5.25.
- low: não recomendado. Economizar 8 centavos em relação ao medium só rende um resultado mais simples.
Perguntas frequentes
Qual é o effort padrão do Opus 5.5? Medium. O Opus 5 usava high como padrão. Requisições à API que não definem o effort rodam em medium no Opus 5.5.
O max é sempre melhor? No nosso teste, foi o que acrescentou mais recursos e acabamento, mas levou 22 minutos e $5.25, contra 52 segundos e $0.56 do medium. É demais para trabalhos simples.
O low economiza muito? No nosso teste, o low foi só 14% mais barato que o medium. Considerando o resultado mais simples, o medium é a melhor escolha.
Calcule para o seu próprio trabalho
Na calculadora de custo de agentes de programação, informe o tamanho da tarefa e a quantidade de tarefas por dia para ver um mês no Opus 5.5. Confira o custo de um único prompt no contador de tokens. Para as diferenças de preço e desempenho entre o Opus 5 e o 5.5, veja Claude Opus 5 vs 5.5 (em inglês).
Medido em 9 de outubro de 2026. O custo é a conversão do ccusage a preços da API; os resultados podem mudar com atualizações do modelo e do Claude Code.
Fontes
- Anthropic: Effort
- Anthropic: Como escrever prompts para o Claude Opus 5.5
- Anthropic: Migração do Claude Opus 5 para o Opus 5.5
- OfficeChai: relatório do Artificial Analysis Intelligence Index
- ccusage: ferramenta de uso do Claude Code (GitHub)
Mais artigos
- Preço do ChatGPT, Claude, Gemini e Grok em reais (com IOF)
- Gemini grátis só com Flash-Lite a partir de 9/10: o que muda
- ChatGPT Go vs Plus: diferença, preço em reais e anúncios
- O português gasta 21% mais tokens que o inglês no GPT
- ChatGPT Pro 100, 200 ou 500: qual plano vale a pena?
Informe o tamanho da tarefa e as tarefas por dia para comparar um mês no Opus 5.5, no Sonnet 5.5 e no GPT-6 Sol.
Abrir a calculadora de custo de agentes de programação →