 TokenSave
Claude Opus 5.5 effort-niveaus getest: van low tot max
Jonhisking · 9 oktober 2026
Claude Opus 5.5 heeft een effort-instelling die bepaalt hoe diep het model nadenkt, met vijf niveaus: low, medium, high, xhigh en max. Hogere niveaus zouden betere resultaten moeten geven, maar de officiële documentatie noemt geen cijfers over hoeveel extra tijd en geld elk niveau kost. Daarom hebben we op 9 oktober 2026 dezelfde opdracht om een spel te bouwen op elk niveau één run laten doen en tijd, tokens, kosten en resultaat vergeleken. Het snelste niveau had 32 seconden nodig, het traagste 22 minuten. Hieronder lees je wat er per niveau veranderde en welk niveau bij welke taak past, aangevuld met praktijkervaring.
Wat effort is
- Het bepaalt hoeveel het model nadenkt. Nadenken kun je bij Opus 5.5 niet uitzetten; effort regelt hoe diep het gaat. Denktokens worden afgerekend als outputtokens.
- De standaard is medium. Bij Opus 5 was high de standaard; Opus 5.5 staat standaard een niveau lager, op medium (volgens de documentatie van Anthropic).
- Zo pas je het aan: in Claude Code met de optie
--effort(low tot max); in de API met de waardeeffort.
Hoe we hebben gemeten
- Model: Claude Opus 5.5 in Claude Code op een Windows-pc
- Prompt (letterlijk): "Make a brick-breaker game that runs in the browser as a single file named index.html in the current folder. It needs 2 levels, a score display and 3 lives, and it must be playable with the keyboard and the mouse. Write the file and finish." De prompt vraagt om een brick-breaker-spel als één index.html-bestand in de huidige map, met 2 levels, een scoreweergave en 3 levens, speelbaar met toetsenbord en muis.
- Methode: vijf runs met dezelfde prompt, waarbij alleen effort verschilde. Elk niveau draaide in een eigen map, zodat de runs elkaar niet konden beïnvloeden.
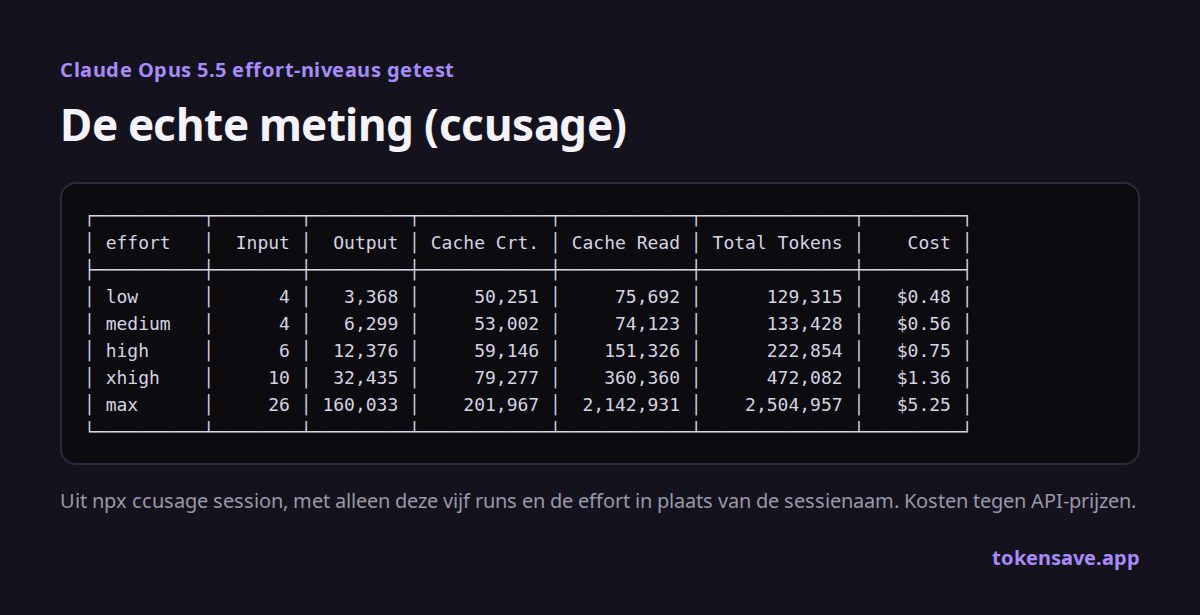
- Meting: tokens en kosten met de gratis tool ccusage, tijd op basis van start- en eindtijdstempels. Kosten zijn omgerekend naar API-prijzen.
Resultaten: tijd, tokens en kosten
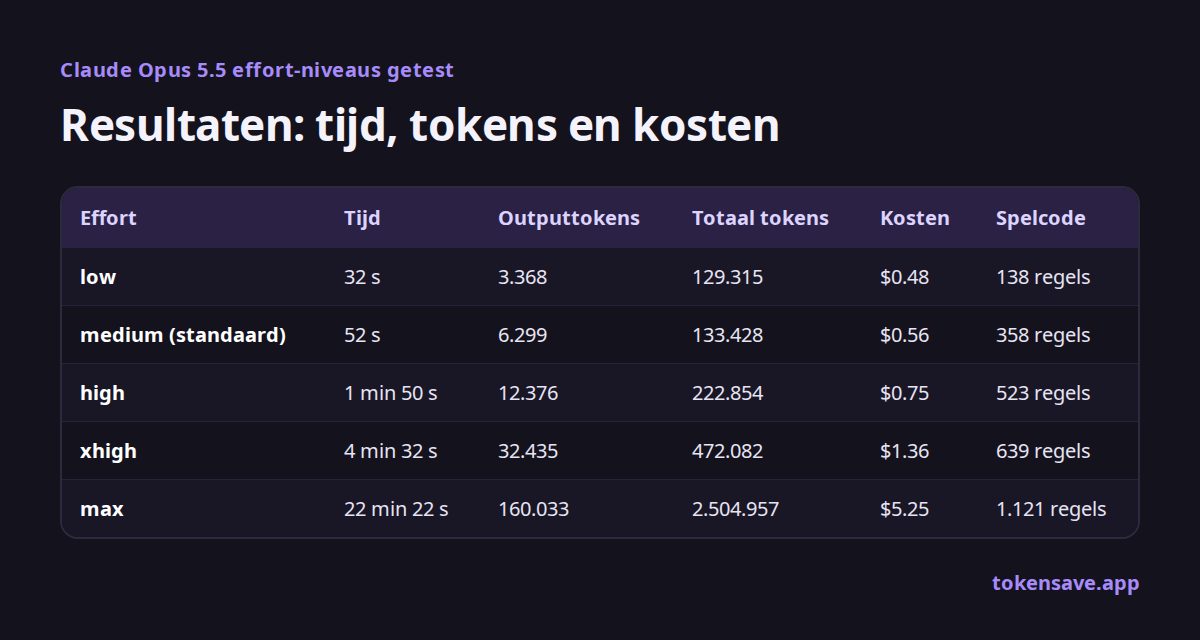
| Effort | Tijd | Outputtokens | Totaal tokens | Kosten | Spelcode |
|---|---|---|---|---|---|
| low | 32 s | 3.368 | 129.315 | $0.48 | 138 regels |
| medium (standaard) | 52 s | 6.299 | 133.428 | $0.56 | 358 regels |
| high | 1 min 50 s | 12.376 | 222.854 | $0.75 | 523 regels |
| xhigh | 4 min 32 s | 32.435 | 472.082 | $1.36 | 639 regels |
| max | 22 min 22 s | 160.033 | 2.504.957 | $5.25 | 1.121 regels |
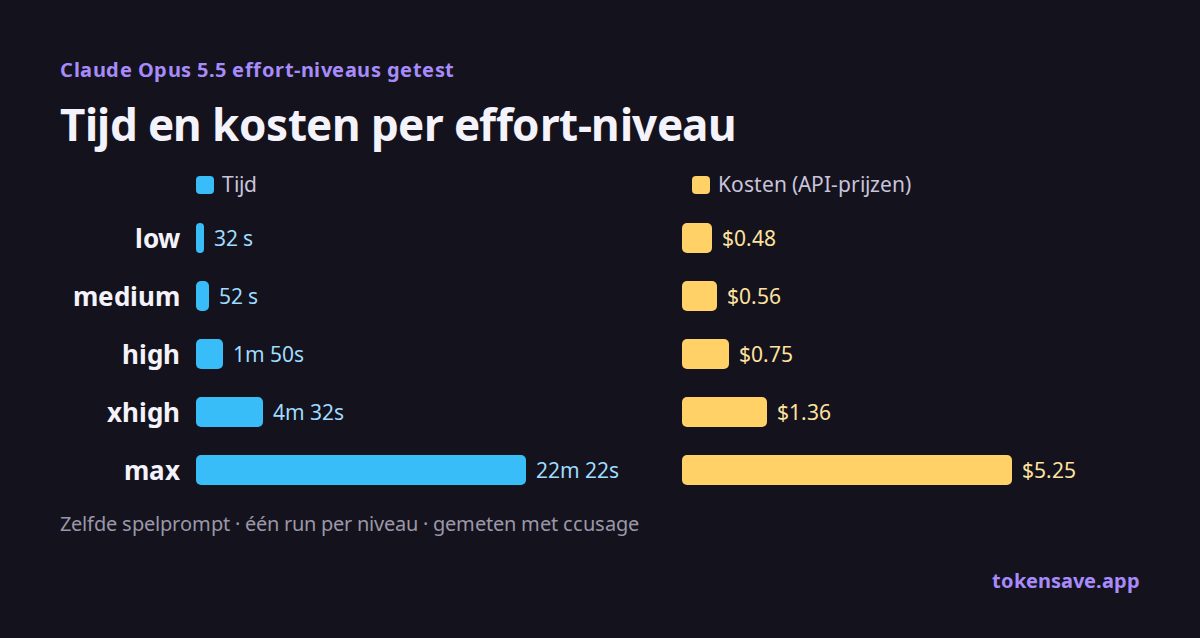
- Low en medium liggen dicht bij elkaar. Low was 14% goedkoper en 38% sneller, maar dat scheelt 8 cent.
- High kostte maar 34% meer dan medium. De tijd ging van 52 seconden naar 1 minuut 50 seconden.
- Bij xhigh springen de kosten omhoog. Het kostte 143% meer dan medium en duurde 4 minuten 32 seconden.
- Max is een klasse apart. Medium deed er 52 seconden over voor $0.56; max had 22 minuten 22 seconden nodig en kostte $5.25. De outputtokens stegen van 6.299 naar 160.033.
De vijf spellen naast elkaar
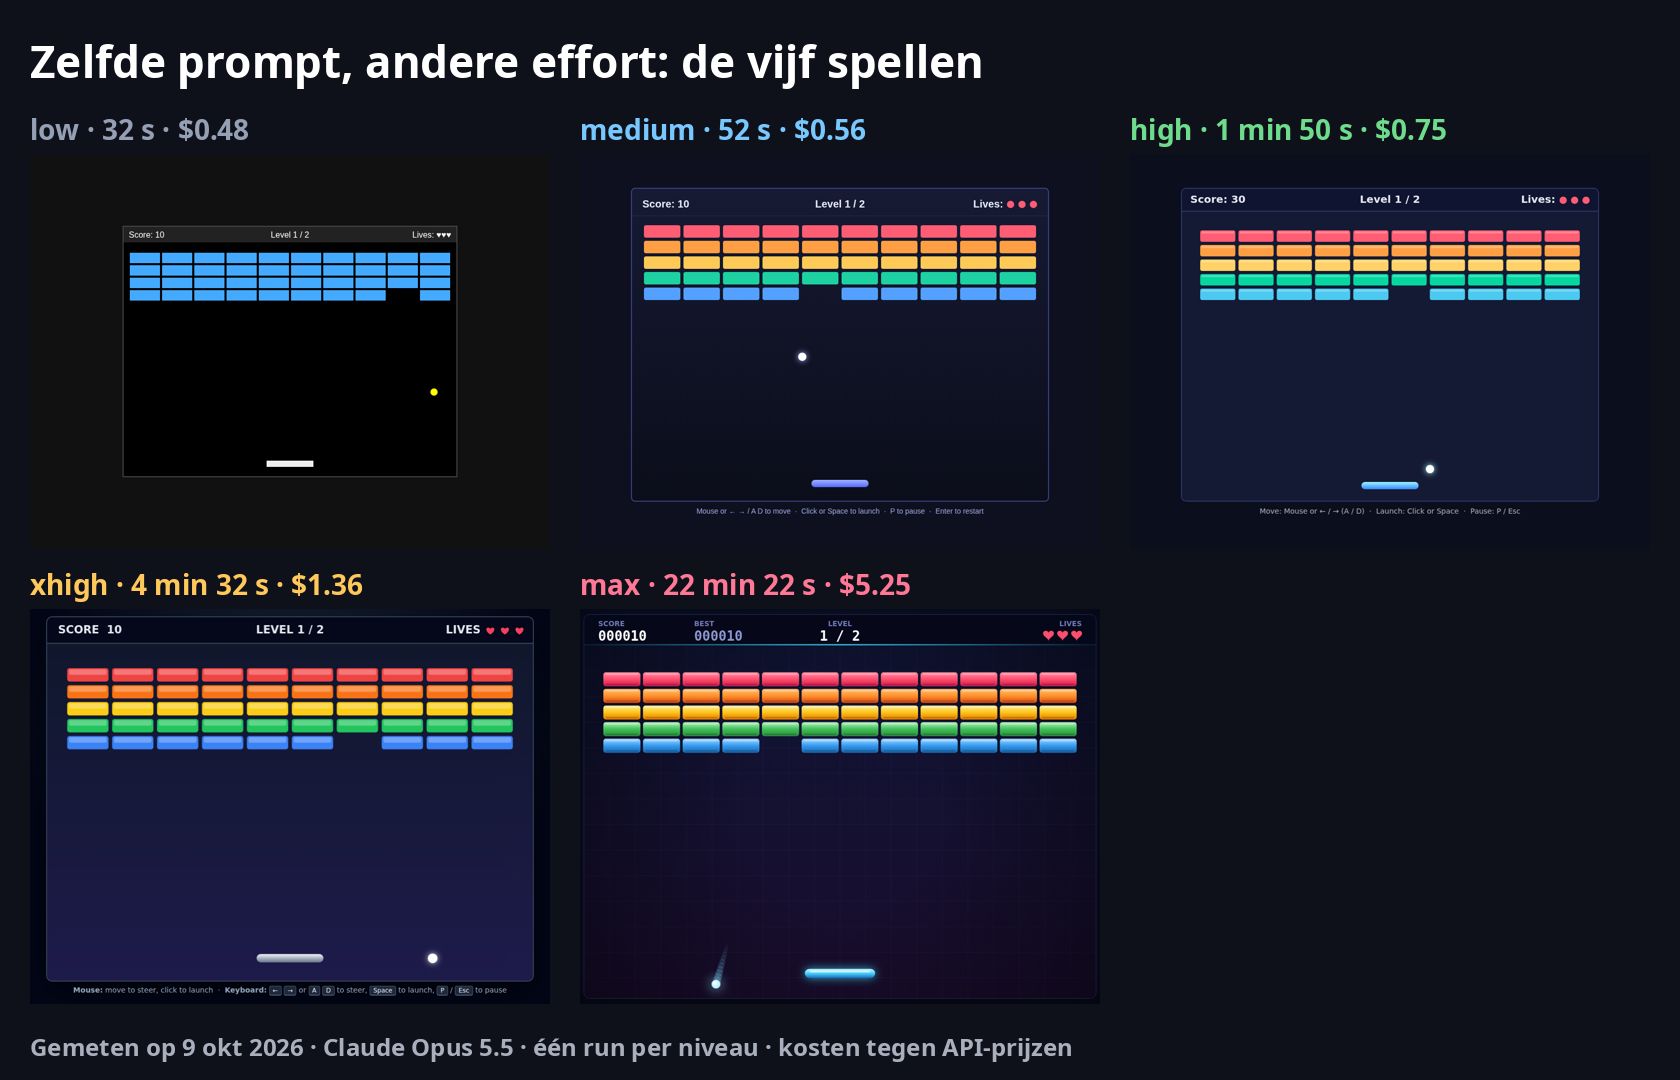
Alle vijf de spellen draaiden zonder fouten en voldeden aan de opdracht: 2 levels, score, 3 levens, besturing met toetsenbord en muis. De verschillen zitten in wat elk niveau daar zelf aan toevoegde.
| Effort | Wat het toevoegde |
|---|---|
| low | Eenkleurige stenen, het kaalste scherm, geen pauze |
| medium | Regenboogstenen, pauze, opnieuw starten |
| high | + deeltjeseffecten, opgeslagen beste score |
| xhigh | Deeltjeseffecten, verzorgder ontwerp (geen opgeslagen beste score) |
| max | + geluidseffecten, levelnamen, een level 2 in de vorm van een invader, schermschudden, overwinningsvuurwerk |
- Vanaf high probeerde het model zijn eigen werk te controleren. High en xhigh probeerden een syntaxcontrole van de code, max probeerde een geautomatiseerde speltest. Alle drie hadden daar toestemming voor nodig, dus geen van de controles is echt uitgevoerd; volgens elk model is de code in plaats daarvan opnieuw doorgelezen. Low en medium rondden af zonder controle.
- Stenen die twee treffers nodig hebben verschenen op elk niveau, ook al hadden we daar niet om gevraagd.
Review per niveau
We hebben elk spel gespeeld en vergeleken met de samenvatting die het model aan het eind gaf en met de code zelf.
low: 32 s, $0.48
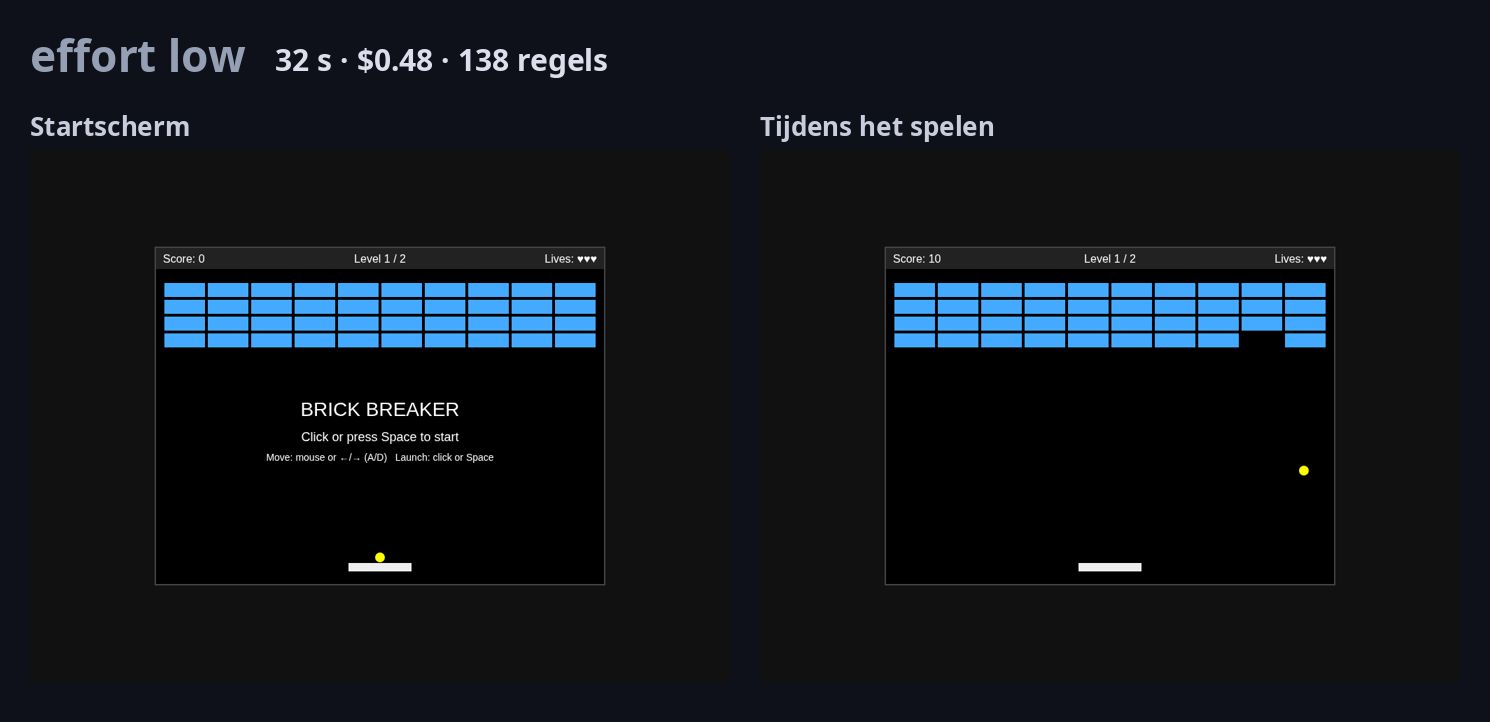
- Wat het bouwde: level 1 bestaat uit vier rijen blauwe stenen; level 2 combineert oranje stenen die twee treffers nodig hebben met open plekken, en de bal is sneller. Er zijn schermen voor level gehaald, game over en gewonnen, plus een herstart.
- Goed: alle gevraagde functies zijn aanwezig, en waar de bal het batje raakt, bepaalt de hoek. Klaar in 32 seconden.
- Zwak: de zwarte achtergrond en eenkleurige stenen maken het de kaalste versie. Geen pauze, en met 138 regels de kortste code.
- Gebruik het als: je alleen wilt nagaan of iets werkt en het later toch nog bijschaaft.
medium: 52 s, $0.56 (standaard)
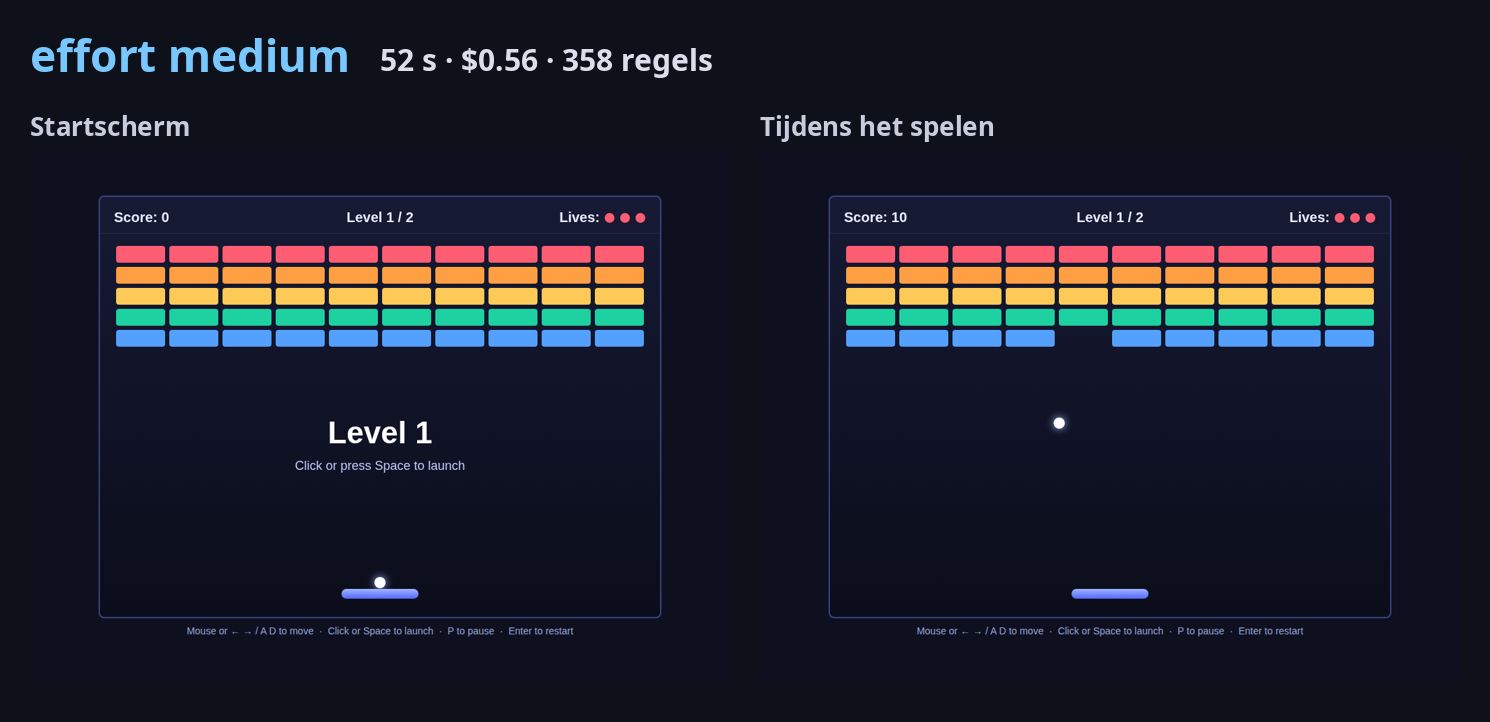
- Wat het bouwde: level 1 is een 5×10-raster in regenboogkleuren; level 2 heeft open plekken en stenen die 2 of 3 treffers nodig hebben, met het aantal resterende treffers erop en vervagend naarmate ze schade oplopen.
- Goed: pauze (P of Esc), opnieuw starten (Enter) en automatisch pauzeren als het venster de focus verliest. De score hangt af van de sterkte van de steen en het level.
- Zwak: geen geluid of deeltjeseffecten.
- Gebruik het als: meestal. Het kost 8 cent meer dan low en is duidelijk beter.
high: 1 min 50 s, $0.75
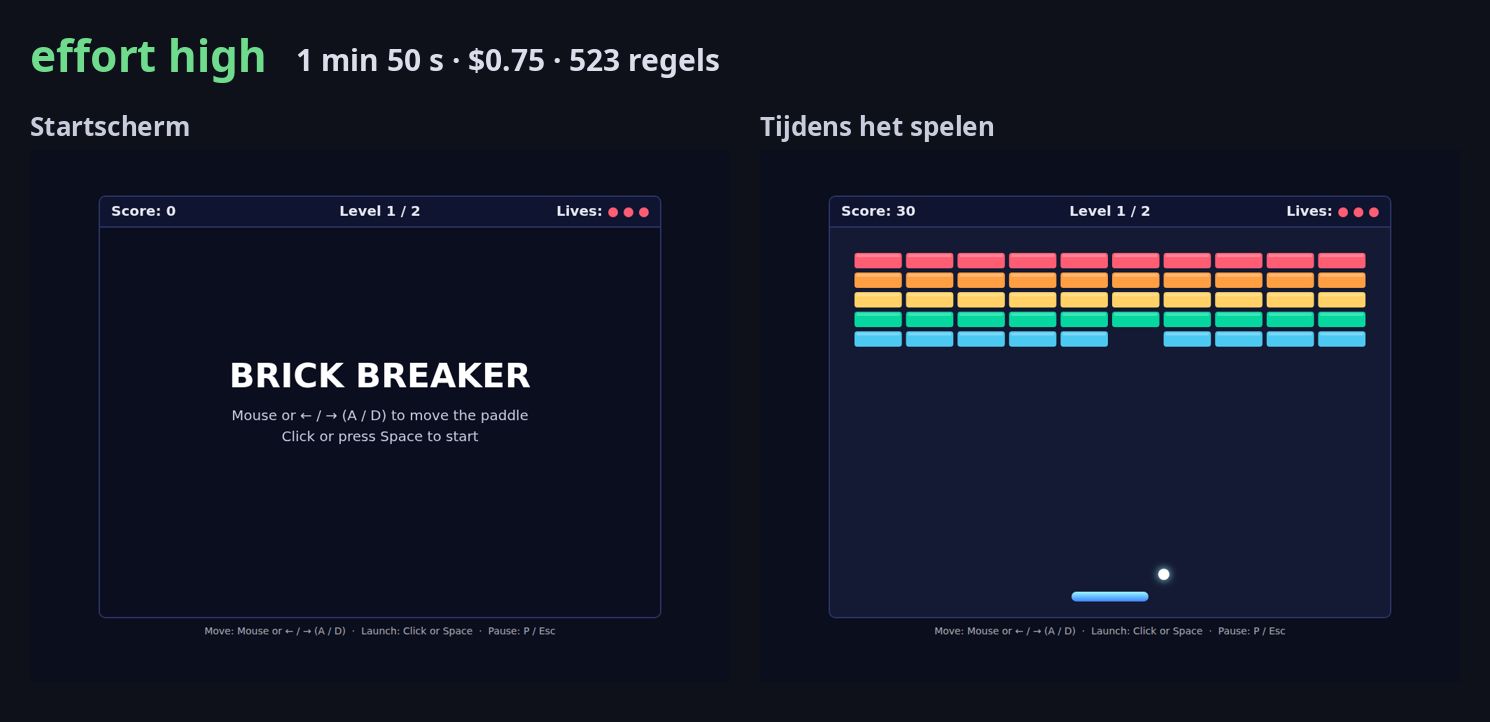
- Wat het bouwde: level 2 is een ruitpatroon van stenen die 2 of 3 treffers nodig hebben, en stenen spatten in deeltjes uiteen als ze breken.
- Goed: een bonus voor het halen van een level, een bonus voor resterende levens, een opgeslagen beste score en aanraakbesturing. Het probeerde ook zelf een syntaxcontrole op de code.
- Zwak: het duurde 112% langer dan medium (van 52 seconden naar 1 minuut 50 seconden).
- Gebruik het als: je een prototype nodig hebt om aan anderen te laten zien, of voor programmeerwerk waar kwaliteit telt. Het kostte maar 34% meer dan medium.
xhigh: 4 min 32 s, $1.36
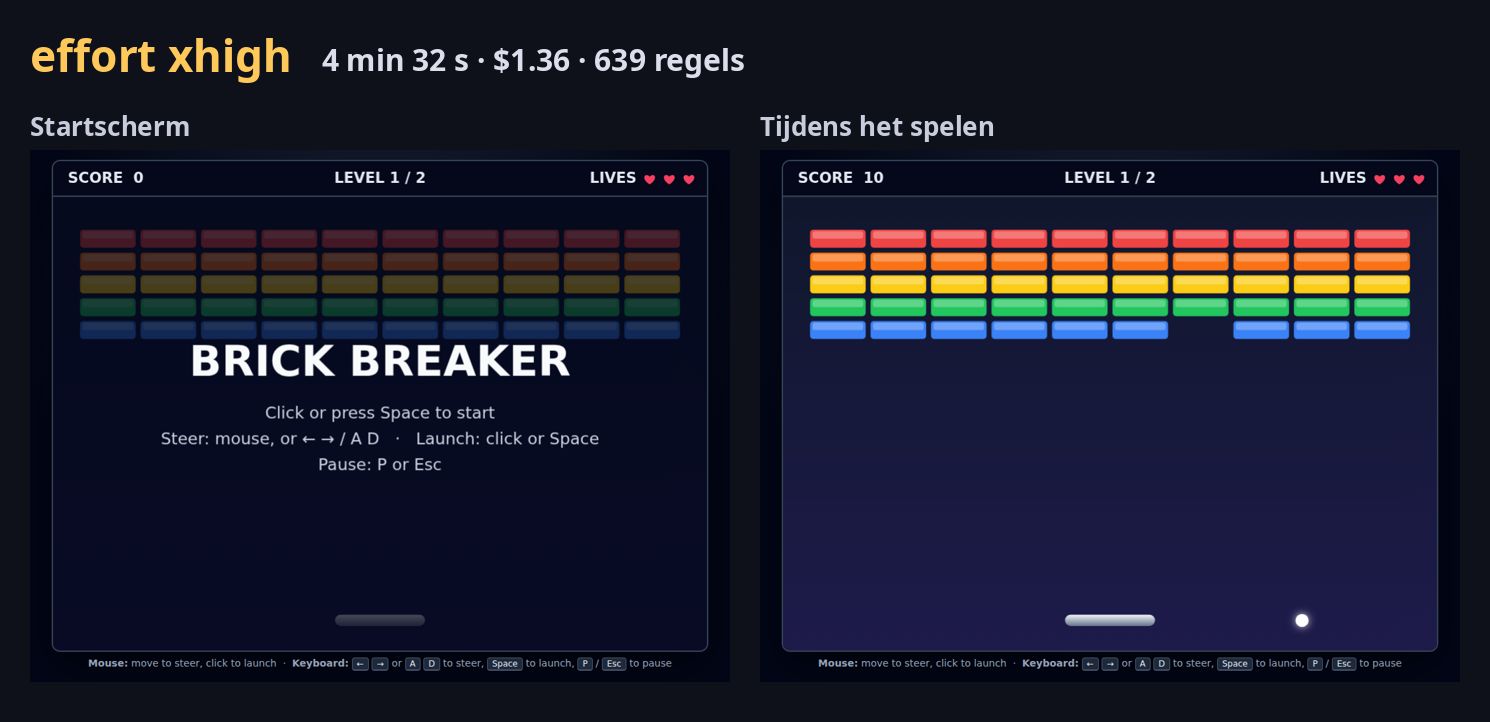
- Wat het bouwde: level 2 is een ruit omringd door stalen stenen die na de eerste treffer barsten. Stenen zijn 10 tot 50 punten waard, afhankelijk van de kleur.
- Goed: het netst ogende scherm, en muis en toetsenbord door elkaar gebruiken werkt soepel: wat je het laatst gebruikte, stuurt het batje.
- Zwak: de opgeslagen beste score en aanraakbesturing die high wel had, zijn weggevallen. Het kostte 143% meer dan medium zonder extra functies ten opzichte van high.
- Gebruik het als: niet voor kleine taken zoals deze. Volgens Anthropic is het bedoeld voor langlopend werk.
max: 22 min 22 s, $5.25
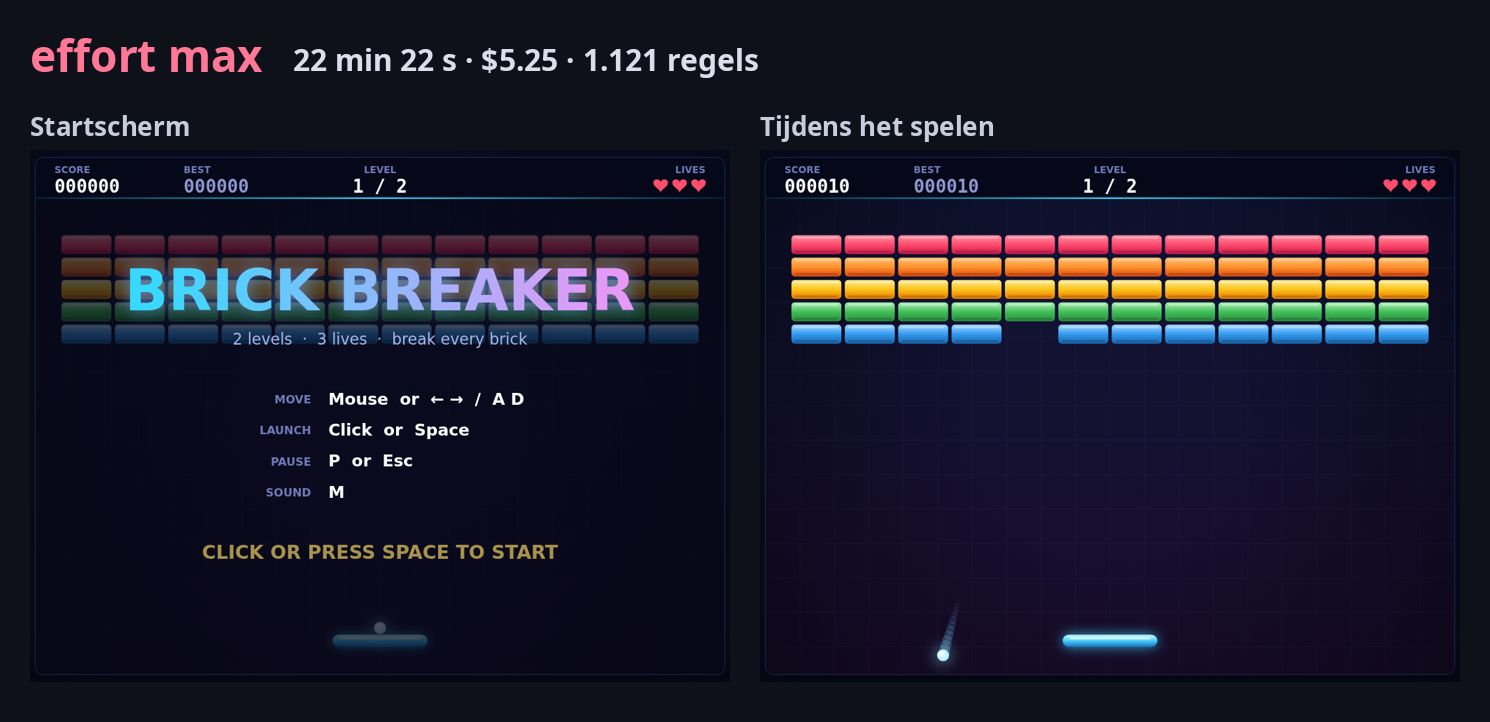
- Wat het bouwde: levels met een naam ("Rainbow Wall", "Space Invader"), een level 2 in de vorm van een invader waarvan de 14 zilveren stenen twee treffers nodig hebben, en een smaller batje in level 2.
- Goed: geluidseffecten (aan/uit met M), opgeslagen beste score, aanraakbesturing, schermschudden, overwinningsvuurwerk en automatisch pauzeren: het meeste van alle niveaus. Het ziet eruit als een af spel.
- Zwak: veruit het traagst, deels omdat het een geautomatiseerde speltest probeerde te draaien waarvoor toestemming nodig was.
- Gebruik het als: kwaliteit het allerbelangrijkst is en je tijd en limieten over hebt, of als niets anders het probleem oplost.
Praktijkervaring: medium voor dagelijks gebruik, high voor programmeren
Ik (Jaehyun) gebruik Opus 5.5 met het Claude Max 20x-abonnement om spellen te bouwen. Dit is hoe het in dagelijks gebruik aanvoelt, geen meting.
- Mijn instelling: ik laat effort op automatisch staan. Meestal draait het op medium en bij programmeren gaat het omhoog naar high.
- low: het voelde traag aan, dus ik heb het even geprobeerd en ben ermee gestopt.
- high: de resultaten zijn duidelijk beter.
- xhigh en max: die heb ik ongeveer één poging gegeven en ik heb zelden een reden om ze te gebruiken.
Vergeleken met de metingen was low juist het snelst, maar gaf het het kaalste resultaat; het trage gevoel ging dus over de output en niet over de snelheid. Het gevoel dat high betere resultaten geeft en dat xhigh en max zelden nodig zijn, kwam overeen met de cijfers.
Wat Anthropic aanraadt
- Medium is sterk. In de tests van Anthropic evenaarde of versloeg Opus 5.5 op medium Opus 5 op high bij programmeren en kenniswerk.
- Low komt bij programmeren dicht bij medium, tegen veel lagere kosten, aldus Anthropic. In onze test was het verschil in output wel merkbaar.
- Bewaar xhigh en max voor werk waarbij je een kwaliteitswinst hebt gemeten.
- Effort wijzigen midden in een gesprek kan de prompt cache breken. Gebruik in de API een effort-wijziging per bericht om de cache te behouden.
- Onafhankelijke tests bevestigen dit. Artificial Analysis stelde vast dat Opus 5.5 op max effort per taak 63% meer outputtokens gebruikte dan Opus 5 (volgens persberichten).
Welke effort voor welke taak
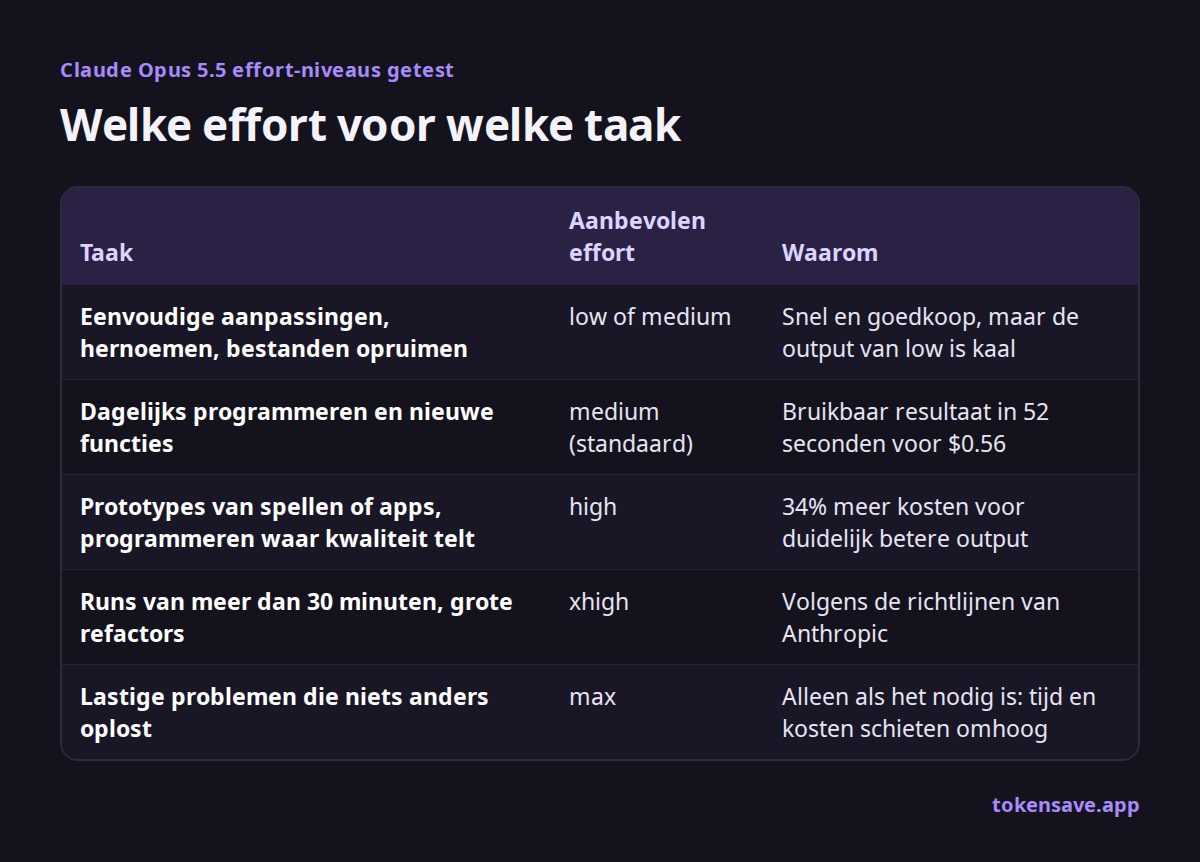
Onze aanbevelingen, op basis van de metingen, de ervaring van Jaehyun en de richtlijnen van Anthropic:
| Taak | Aanbevolen effort | Waarom |
|---|---|---|
| Eenvoudige aanpassingen, hernoemen, bestanden opruimen | low of medium | Snel en goedkoop, maar de output van low is kaal |
| Dagelijks programmeren en nieuwe functies | medium (standaard) | Bruikbaar resultaat in 52 seconden voor $0.56 |
| Prototypes van spellen of apps, programmeren waar kwaliteit telt | high | 34% meer kosten voor duidelijk betere output |
| Runs van meer dan 30 minuten, grote refactors | xhigh | Volgens de richtlijnen van Anthropic |
| Lastige problemen die niets anders oplost | max | Alleen als het nodig is: tijd en kosten schieten omhoog |
- Begin met medium. Zet alleen de taken waarbij het resultaat tekortschiet een niveau hoger, op high.
- Met een abonnement denk je in limieten. Hoe hoger de kosten omgerekend naar API-prijzen, hoe sneller je Max- of Pro-limiet opraakt. Eén max-run verbruikte meer dan negen medium-runs.
- Kanttekening: één run per niveau, bij een vrij kleine taak. Bij grotere projecten kunnen de verschillen anders uitvallen.
Conclusie: standaard medium, high als het ertoe doet
- Standaard: medium. Bruikbaar resultaat in 52 seconden voor $0.56.
- Als kwaliteit telt: high. Maar 34% meer dan medium voor duidelijk betere output. De beste prijs-kwaliteitverhouding van de vijf.
- xhigh: sla het over bij kleine taken. 143% meer dan medium, maar niet meer functies dan high. Alleen de moeite waard voor lange runs.
- max: alleen als je het nodig hebt. Het meest spectaculaire resultaat, maar 22 minuten en $5.25.
- low: niet aanbevolen. Met 8 cent besparing ten opzichte van medium krijg je alleen een kaler resultaat.
Veelgestelde vragen
Wat is de standaard-effort van Opus 5.5? Medium. Bij Opus 5 was dat high. API-verzoeken waarin geen effort is ingesteld, draaien op Opus 5.5 op medium.
Is max altijd beter? In onze test voegde het de meeste functies en afwerking toe, maar het kostte 22 minuten en $5.25, tegenover 52 seconden en $0.56 voor medium. Te veel voor eenvoudig werk.
Bespaart low veel? In onze test was low maar 14% goedkoper dan medium. Gezien het kalere resultaat is medium de betere keuze.
Bereken het voor je eigen werk
Vul in de kostencalculator voor coding agents de taakgrootte en het aantal taken per dag in om een maand met Opus 5.5 te zien. De kosten van één prompt controleer je met de tokenteller. Voor de verschillen in prijs en prestaties tussen Opus 5 en 5.5, zie Claude Opus 5 vs 5.5 (Engelstalig). Loop je tegen je gebruikslimiet aan, lees dan Claude Code limiet uitgelegd.
Gemeten op 9 oktober 2026. Kosten zijn de omrekening van ccusage naar API-prijzen; resultaten kunnen veranderen door updates van het model en van Claude Code.
Bronnen
- Anthropic: Effort
- Anthropic: Prompten met Claude Opus 5.5
- Anthropic: Overstappen van Claude Opus 5 naar Opus 5.5
- OfficeChai: rapport over de Artificial Analysis Intelligence Index
- ccusage: tool voor Claude Code-gebruik (GitHub)
More articles
- Game maken met AI: wat kost een game maken? ($128–181)
- Goedkoopste AI API 2026: API-prijzen vergelijken per 1 miljoen tokens
- Gemini gratis: vanaf 9 oktober alleen Flash-Lite, AI Plus zonder Pro
- Codex limiet: hoeveel geeft Codex in ChatGPT Plus en Pro?
- Claude limiet: hoeveel tokens geven Claude Pro en Claude Max?
Vul de taakgrootte en het aantal taken per dag in om een maand met Opus 5.5, Sonnet 5.5 en GPT-6 Sol te vergelijken.
Open de kostencalculator voor coding agents →