 TokenSave
日本語は英語の1.79倍のトークンを使う:34言語で実測
Jonhisking · 2026年9月30日
同じプロンプトを34言語に翻訳して、OpenAIのトークナイザーでトークン数を測ってみました。「日本語は英語よりトークンを食う」とよく言われますが、実際どのくらいなのか、他の言語と比べてどうなのかを数字で確認したかったからです。
結論から言うと、日本語は英語の1.79倍。34言語中6番目に高く、トークナイザーの世代交代でほとんど改善されなかった数少ない言語でした。
測定方法
英語で34トークンになる、ごく普通のカスタマーサポート用プロンプトを使いました。
Please summarize the customer email below in three bullet points and suggest a polite reply. The customer says the order arrived two days late and one item was missing from the box.
日本語版はこちらです。
以下の顧客メールを3つの箇条書きで要約し、丁寧な返信を提案してください。顧客によると、注文品が2日遅れて届き、箱から商品が1つ欠けていたそうです。
これを34言語に翻訳し、2つのエンコーディングで数えました。
- o200k_base:GPT-4o以降のOpenAIモデルで使われている現行トークナイザー
- cl100k_base:GPT-4 / GPT-3.5時代の旧トークナイザー(比較用)
import { getEncoding } from "js-tiktoken";

const enc = getEncoding("o200k_base");
const count = (text) => enc.encode(text).length;

count(english);  // 34
count(japanese); // 61
Pythonなら tiktoken で同じことができます。
import tiktoken
enc = tiktoken.get_encoding("o200k_base")
print(len(enc.encode(japanese)))  # 61
結果
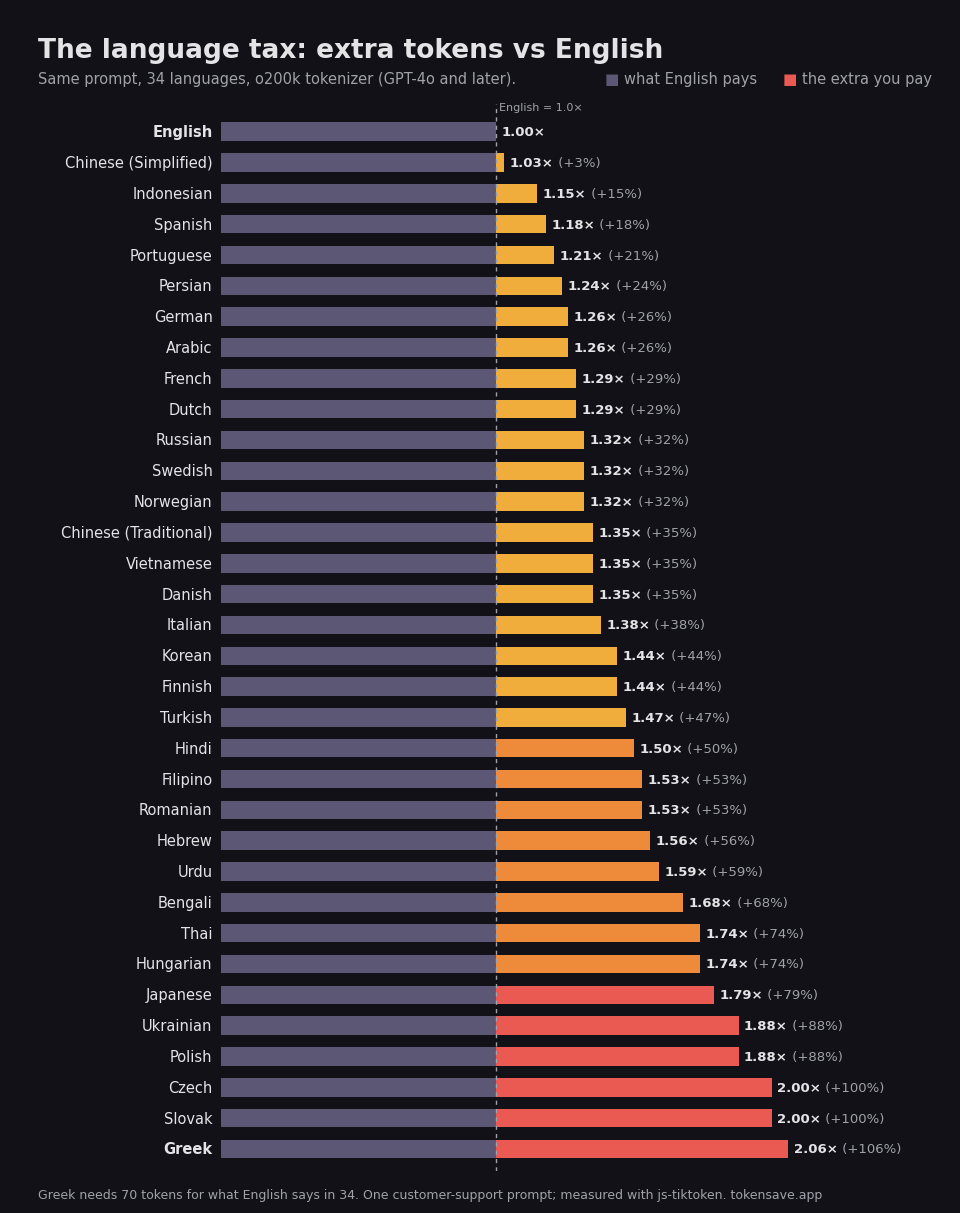
| 言語 | トークン数 (o200k) | 英語比 | 旧GPT-4トークナイザー (cl100k) |
|---|---|---|---|
| 英語 | 34 | 1.00倍 | 1.00倍 |
| 中国語(簡体字) | 35 | 1.03倍 | 1.53倍 |
| スペイン語 | 40 | 1.18倍 | 1.29倍 |
| ドイツ語 | 43 | 1.26倍 | 1.50倍 |
| アラビア語 | 43 | 1.26倍 | 3.03倍 |
| フランス語 | 44 | 1.29倍 | 1.44倍 |
| ロシア語 | 45 | 1.32倍 | 2.15倍 |
| 中国語(繁体字) | 46 | 1.35倍 | 2.12倍 |
| ベトナム語 | 46 | 1.35倍 | 2.32倍 |
| 韓国語 | 49 | 1.44倍 | 2.50倍 |
| ヒンディー語 | 51 | 1.50倍 | 4.59倍 |
| ベンガル語 | 57 | 1.68倍 | 6.09倍 |
| タイ語 | 59 | 1.74倍 | 3.71倍 |
| 日本語 | 61 | 1.79倍 | 2.21倍 |
| ウクライナ語 | 64 | 1.88倍 | 3.15倍 |
| ポーランド語 | 64 | 1.88倍 | 2.12倍 |
| チェコ語 | 68 | 2.00倍 | 2.59倍 |
| ギリシャ語 | 70 | 2.06倍 | 4.94倍 |
(34言語すべての結果はこちらの英語記事にあります)
意外だったこと
1. 日本語は「改善が一番小さかった言語」のひとつ
旧トークナイザーから現行への変化を見ると、多くの言語が大幅に安くなっています。
- ベンガル語:6.09倍 → 1.68倍
- ヒンディー語:4.59倍 → 1.50倍
- アラビア語:3.03倍 → 1.26倍
- 韓国語:2.50倍 → 1.44倍
一方、日本語は 2.21倍 → 1.79倍 とあまり縮まりませんでした。旧トークナイザーの頃は韓国語より安かったのに、今は韓国語より高くなっています。
2. 同じ漢字でも中国語(簡体字)はほぼ英語と同じ
中国語(簡体字)は35トークンで、英語とほぼ同じです。同じ内容の繁体字は1.35倍でした。漢字の多さが原因なら中国語も高くなるはずなので、日本語の割高さは漢字そのものより、ひらがな・カタカナと漢字が混ざる書き方や学習データの量の影響が大きそうです。
3. 一番高いのはアジア言語ではなかった
最下位はギリシャ語(2.06倍)、次いでチェコ語とスロバキア語(2.00倍)、ポーランド語とウクライナ語(1.88倍)。語形変化が多い言語は、ラテン文字やキリル文字でも細かく分割されるようです。
コストにするとどのくらいか
入力が100万トークンあたり2ドルのモデルで、このプロンプトを100万回送った場合です。
| 言語 | 入力トークン | 入力コスト |
|---|---|---|
| 英語 | 3,400万 | $68 |
| 韓国語 | 4,900万 | $98 |
| 日本語 | 6,100万 | $122 |
| チェコ語 | 6,800万 | $136 |
これは入力だけの話です。回答も日本語で返ってくれば、単価が4〜5倍高い出力トークンにも同じ倍率がかかります。
日本語でトークンを節約するコツ
- システムプロンプトや固定の指示文は英語で書く。ユーザーの入力だけ日本語にすれば、毎回送る部分のコストが下がります。
- 中間処理(分類・抽出・ツール呼び出し)は英語かJSONで出力させる。ユーザーに見せる最終回答だけ日本語にします。
- 全角スペースや空行を消す。コピペした文章には意外と多く含まれています。
- 敬語を盛りすぎない。「〜していただけますと幸いです」のような丁寧な言い回しは、指示としての効果に比べてトークンが多くかかります。
- プロンプトキャッシュを使う。固定部分をキャッシュすれば入力単価は大幅に下がります(90%以上安くなるモデルもあります)。
注意点
- 測ったのは1つのプロンプトだけです。文によって倍率は0.1〜0.2倍ほど変わるので、順位はおおまかな目安として見てください。
- 翻訳は機械翻訳をベースに確認しました。日本語訳に違和感があれば教えてください。測り直します。
- ClaudeとGeminiはトークナイザーが異なるため、この数字がそのまま当てはまるのはOpenAIのモデルだけです。
自分の文章で測ってみましょう。日本語のプロンプトが英語の何倍のトークンと料金になるかすぐ分かります。
トークンカウンターを開く →