 TokenSave
L’italiano usa 1,38× i token dell’inglese in GPT
Jonhisking · 2026-10-01
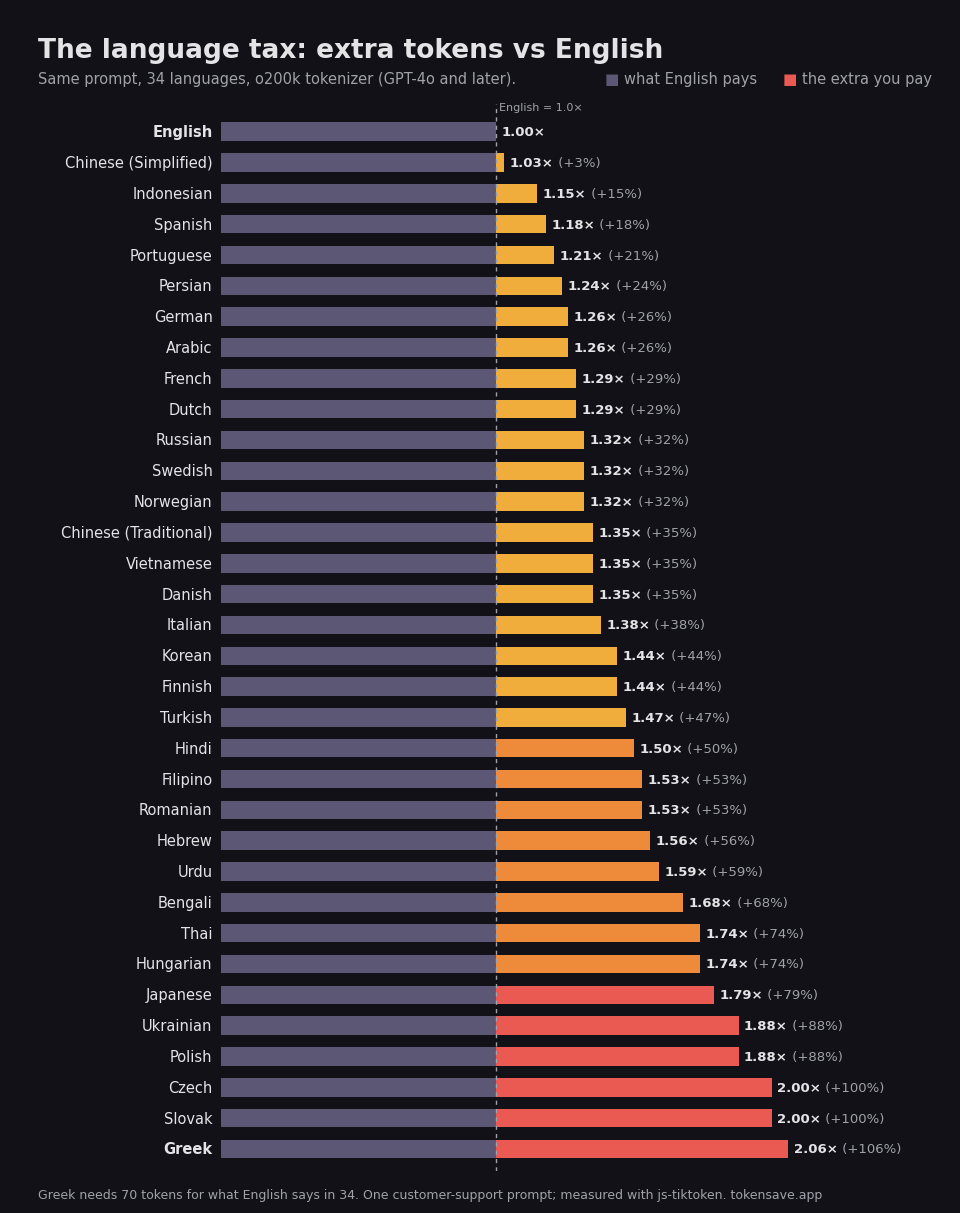
Ho tradotto lo stesso prompt di assistenza clienti in 34 lingue e contato i token con o200k_base, il tokenizer attuale di OpenAI (GPT-4o e successivi). In inglese servono 34 token; in italiano 47, cioè 1,38× l’inglese, posizione 17 su 34 (1 = il più economico).
La versione italiana:
Riassumi l'email del cliente qui sotto in tre punti e suggerisci una risposta cortese. Il cliente dice che l'ordine è arrivato con due giorni di ritardo e che mancava un articolo nella scatola.
Risultati
| Lingua | Token | Rispetto all’inglese | Vecchio tokenizer GPT-4 |
|---|---|---|---|
| English | 34 | 1,00× | 1,00× |
| 简体中文 | 35 | 1,03× | 1,53× |
| Español | 40 | 1,18× | 1,29× |
| Deutsch | 43 | 1,26× | 1,50× |
| Italiano | 47 | 1,38× | 1,59× |
| 한국어 | 49 | 1,44× | 2,50× |
| 日本語 | 61 | 1,79× | 2,21× |
| Čeština | 68 | 2,00× | 2,59× |
| Ελληνικά | 70 | 2,06× | 4,94× |
Perché
Il tokenizer impara soprattutto da testo inglese: parole come " polite" o " customer" sono un solo token, mentre molte parole italiane vengono spezzate:
- Riassumi →
Ri | ass | umi· 3 - suggerisci →
sugger | isci· 2 - arrivato →
arriv | ato· 2
Rispetto al vecchio tokenizer
Con il tokenizer dell’epoca GPT-4 (cl100k) lo stesso prompt costava 1,59×; oggi 1,38×.
In denaro
Con un modello a 2 $ per milione di token in input, inviare questo prompt un milione di volte costa 68 $ in inglese e 94 $ in italiano. Se anche la risposta è in italiano, lo stesso moltiplicatore vale per i token in output, che di solito costano 4–5× di più.
Come risparmiare
- Scrivi il prompt di sistema e le istruzioni fisse in inglese; lascia in italiano solo l’input dell’utente.
- Chiedi i passaggi intermedi (classificazione, estrazione, chiamate a strumenti) in inglese o JSON e solo la risposta finale in italiano.
- Usa il prompt caching per la parte fissa del prompt.
Limiti
- È un solo prompt: con altri testi il rapporto può variare di ±0,1–0,2.
- Claude e Gemini usano altri tokenizer: questi numeri valgono solo per i modelli OpenAI.
- La traduzione parte da una traduzione automatica revisionata.
Risultati completi delle 34 lingue (in inglese): confronto tra 34 lingue
Misura il tuo testo: quanti token e quanti soldi costa il tuo prompt in italiano rispetto all’inglese.
Apri il contatore di token →