 TokenSave
繁體中文在 GPT 中比英文多用 35% Token(1.35×)
Jonhisking · 2026-10-01
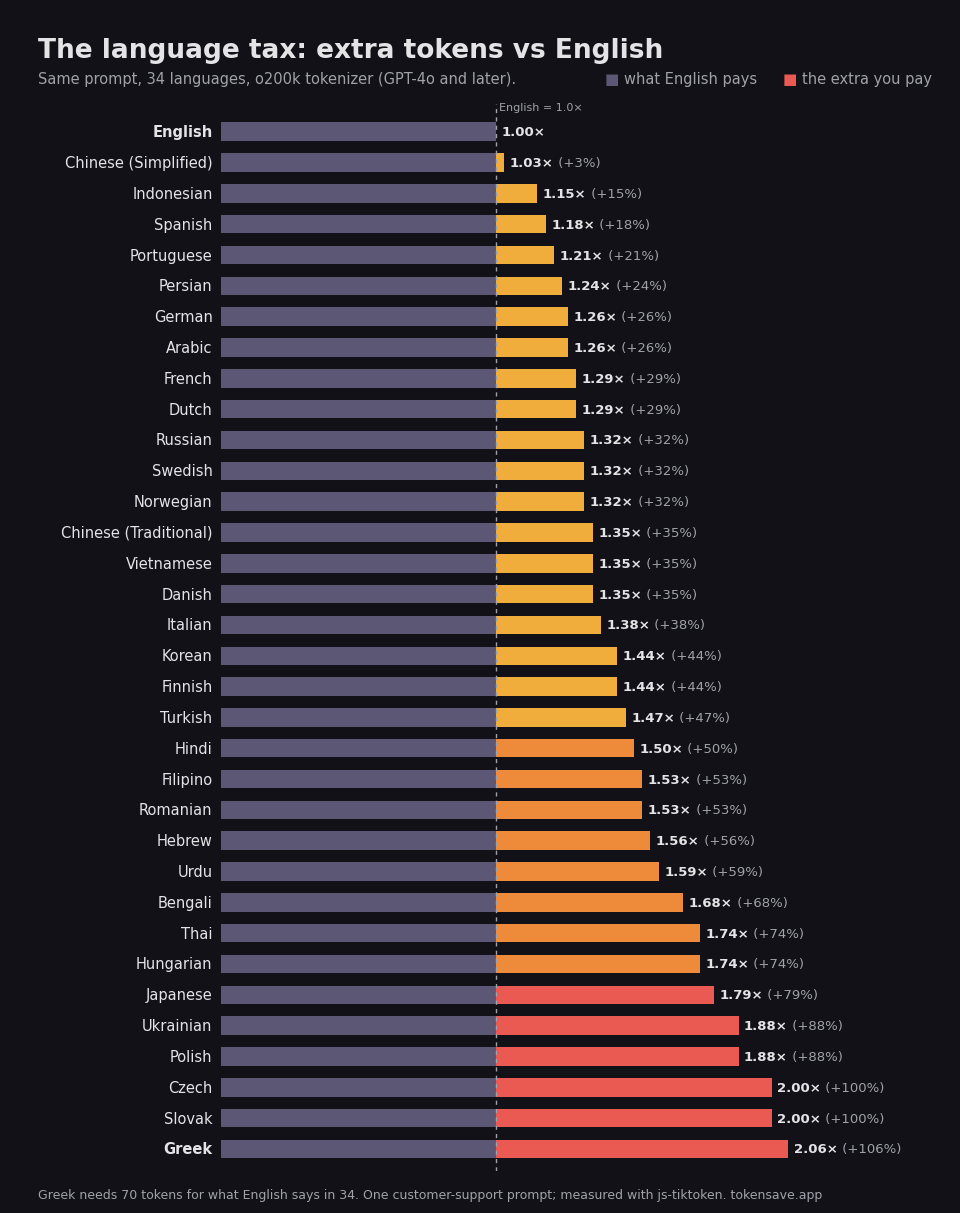
我們把同一段客服提示詞翻成 34 種語言,用 OpenAI 目前的 o200k_base 分詞器(GPT-4o 以後的模型)計算 Token。英文需要 34 個 Token,繁體中文需要 46 個,是英文的 1.35×,在 34 種語言中排第 14 便宜。
繁體中文版本:
請用三個重點總結下面的客戶郵件,並建議一封禮貌的回覆。客戶說訂單晚到了兩天,而且箱子裡少了一件商品。
結果
| 語言 | Token | 相對英文 | 舊 GPT-4 分詞器 |
|---|---|---|---|
| English | 34 | 1.00× | 1.00× |
| 简体中文 | 35 | 1.03× | 1.53× |
| Español | 40 | 1.18× | 1.29× |
| Deutsch | 43 | 1.26× | 1.50× |
| 繁體中文 | 46 | 1.35× | 2.12× |
| 한국어 | 49 | 1.44× | 2.50× |
| 日本語 | 61 | 1.79× | 2.21× |
| Čeština | 68 | 2.00× | 2.59× |
| Ελληνικά | 70 | 2.06× | 4.94× |
為什麼
分詞器主要以英文資料訓練,常見英文單字通常是 1 個 Token(" polite"、" customer")。繁體字的常用詞收錄得比簡體少,常被拆成單字:
- 請用三個重點總結下面的客戶郵 →
請 | 用 | 三 | 個 | 重 | 點 | 總 | 結 | 下面 | 的 | 客 | 戶 | 郵· 13
與舊分詞器相比
在 GPT-4 時代的 cl100k 分詞器上,同一提示詞是英文的 2.12×,現在降到 1.35×。不過同樣內容的簡體中文只要 1.03×。
換算成費用
以輸入每 100 萬 Token 2 美元計,把這段提示詞送出 100 萬次:英文 $68,繁體中文 $92。若回答也用繁體中文,單價通常高 4–5 倍的輸出 Token 也會乘上同樣倍數。
省 Token 的方法
- 固定的系統提示詞改用英文撰寫,只讓使用者輸入保持中文。
- 分類、擷取、工具呼叫等中間步驟輸出英文或 JSON,只有最後回答用繁體中文。
- 對固定前綴使用提示詞快取(Prompt Caching),輸入單價會大幅下降。
限制
- 只測了一段提示詞,不同文字的倍數可能差 0.1–0.2。
- Claude 與 Gemini 的分詞器不同,這些數字只適用於 OpenAI 模型。
- 譯文以機器翻譯為基礎並經過檢查。
全部 34 種語言的結果(英文):34 種語言比較
用你自己的文字測一測:中文提示詞比英文多多少 Token 和費用。
開啟 Token 計算器 →