 TokenSave
Tiếng Việt dùng gấp 1,35 lần token so với tiếng Anh trong GPT
Jonhisking · 2026-10-01
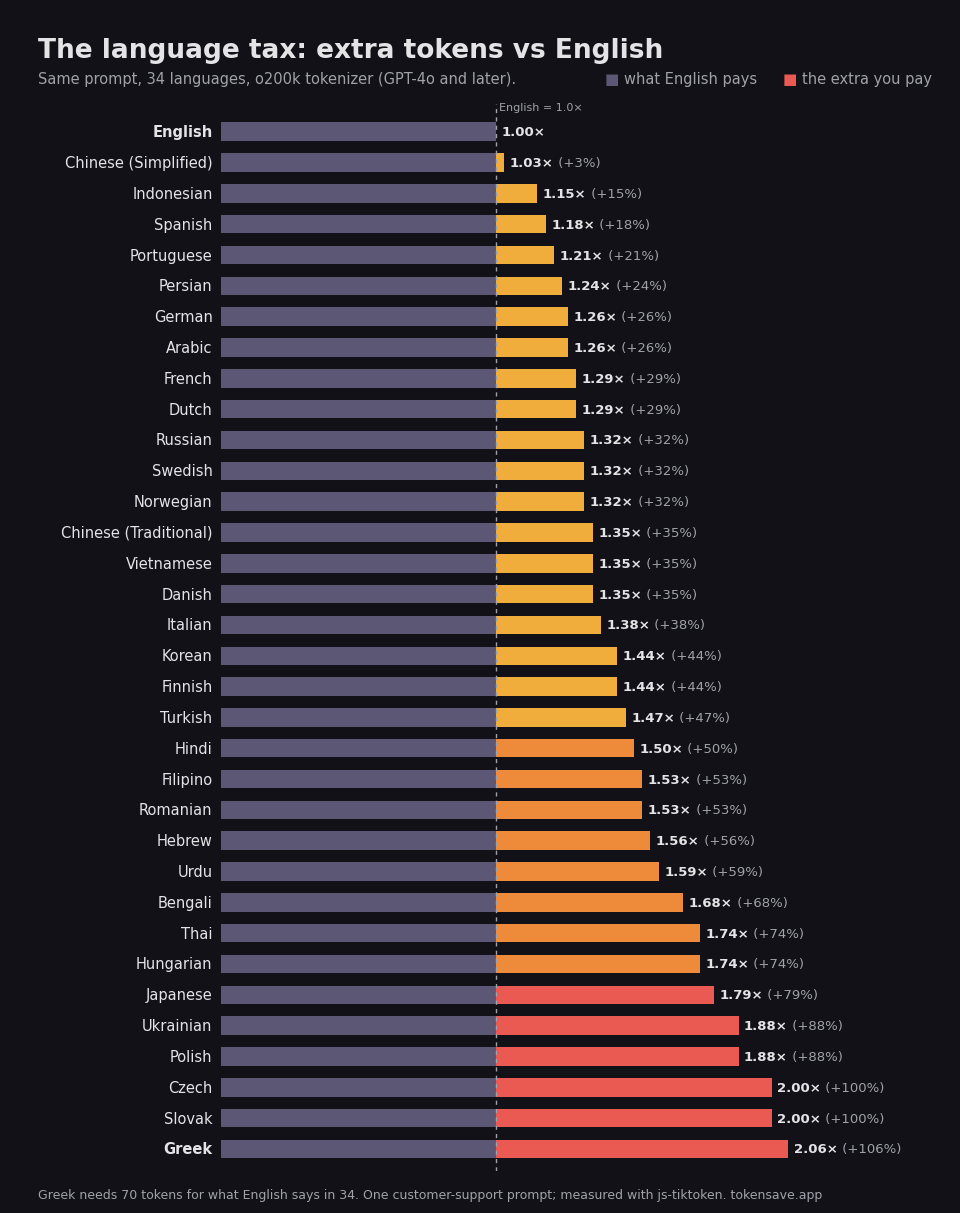
Tôi dịch cùng một prompt chăm sóc khách hàng sang 34 ngôn ngữ và đếm token bằng o200k_base, tokenizer hiện tại của OpenAI (GPT-4o trở về sau). Tiếng Anh cần 34 token, tiếng Việt 46 token — gấp 1,35 lần, đứng thứ 15/34 (1 = rẻ nhất).
Bản tiếng Việt:
Hãy tóm tắt email của khách hàng dưới đây thành ba ý chính và đề xuất một câu trả lời lịch sự. Khách hàng nói rằng đơn hàng đến trễ hai ngày và thiếu một món trong hộp.
Kết quả
| Ngôn ngữ | Token | So với tiếng Anh | Tokenizer GPT-4 cũ |
|---|---|---|---|
| English | 34 | 1,00× | 1,00× |
| 简体中文 | 35 | 1,03× | 1,53× |
| Español | 40 | 1,18× | 1,29× |
| Deutsch | 43 | 1,26× | 1,50× |
| Tiếng Việt | 46 | 1,35× | 2,32× |
| 한국어 | 49 | 1,44× | 2,50× |
| 日本語 | 61 | 1,79× | 2,21× |
| Čeština | 68 | 2,00× | 2,59× |
| Ελληνικά | 70 | 2,06× | 4,94× |
Vì sao
Tokenizer học chủ yếu từ văn bản tiếng Anh: những từ như " polite" hay " customer" chỉ là một token, còn chữ tiếng Việt có dấu thường bị tách ra:
- Khách →
Kh | ách· 2 - Hãy →
H | ãy· 2 - tóm →
t | óm· 2
So với tokenizer cũ
Với tokenizer thời GPT-4 (cl100k), cùng prompt này gấp 2,32×; nay chỉ còn 1,35×.
Quy ra tiền
Với mô hình giá 2 $ cho 1 triệu token đầu vào, gửi prompt này 1 triệu lần tốn 68 $ bằng tiếng Anh và 92 $ bằng tiếng Việt. Nếu câu trả lời cũng bằng tiếng Việt, hệ số này áp dụng cả cho token đầu ra, vốn thường đắt gấp 4–5 lần.
Cách tiết kiệm
- Viết system prompt và hướng dẫn cố định bằng tiếng Anh; chỉ giữ tiếng Việt cho phần người dùng nhập.
- Yêu cầu các bước trung gian (phân loại, trích xuất, gọi công cụ) bằng tiếng Anh hoặc JSON, chỉ câu trả lời cuối bằng tiếng Việt.
- Dùng prompt caching cho phần cố định của prompt.
Giới hạn
- Chỉ đo một prompt; với văn bản khác tỉ lệ có thể lệch ±0,1–0,2.
- Claude và Gemini dùng tokenizer khác; các con số chỉ đúng với mô hình OpenAI.
- Bản dịch dựa trên dịch máy đã được kiểm tra.
Kết quả đầy đủ 34 ngôn ngữ (tiếng Anh): so sánh 34 ngôn ngữ
Đo văn bản của bạn: prompt tiếng Việt tốn bao nhiêu token và tiền so với tiếng Anh.
Mở công cụ đếm token →