 TokenSave
ภาษาไทยใช้โทเค็นมากกว่าภาษาอังกฤษ 74% ใน GPT
Jonhisking · 2026-10-02
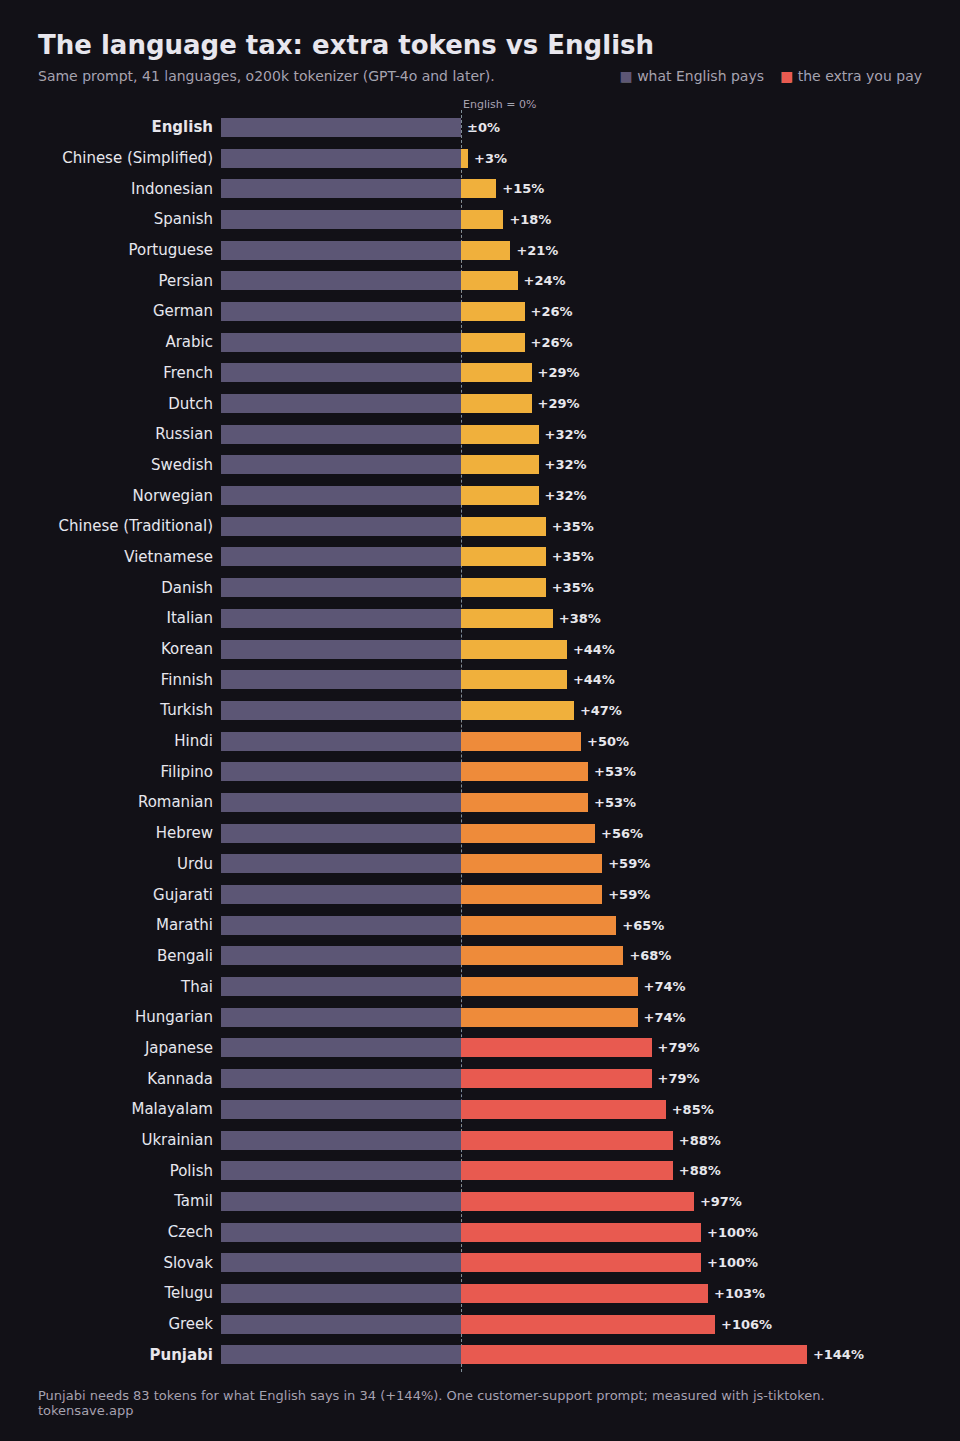
เราแปลพรอมต์บริการลูกค้าเดียวกันเป็น 41 ภาษา แล้วนับโทเค็นด้วย o200k_base ซึ่งเป็นตัวตัดคำ (tokenizer) ปัจจุบันของ OpenAI (GPT-4o ขึ้นไป) ภาษาอังกฤษใช้ 34 โทเค็น ภาษาไทยใช้ 59 โทเค็น หรือมากกว่า 74% อยู่อันดับ 29 จาก 41 (1 = ถูกที่สุด)
ฉบับภาษาไทย:
โปรดสรุปอีเมลของลูกค้าด้านล่างเป็นสามข้อและเสนอคำตอบที่สุภาพ ลูกค้าบอกว่าคำสั่งซื้อมาถึงช้าไปสองวันและมีสินค้าหายไปหนึ่งชิ้นจากกล่อง
ผลลัพธ์
| ภาษา | โทเค็น | เทียบกับภาษาอังกฤษ | ประหยัดได้หากส่งเป็นภาษาอังกฤษ |
|---|---|---|---|
| English | 34 | ±0% | – |
| 简体中文 | 35 | +3% | 3% |
| Español | 40 | +18% | 15% |
| Deutsch | 43 | +26% | 21% |
| 한국어 | 49 | +44% | 31% |
| हिन्दी | 51 | +50% | 33% |
| ไทย | 59 | +74% | 43% |
| 日本語 | 61 | +79% | 44% |
| Čeština | 68 | +100% | 50% |
| Ελληνικά | 70 | +106% | 51% |
| ਪੰਜਾਬੀ | 83 | +144% | 59% |
ทำไม
tokenizer เรียนรู้จากข้อความภาษาอังกฤษเป็นหลัก คำอย่าง " polite" หรือ " customer" เป็นโทเค็นเดียว แต่ภาษาไทยที่ไม่เว้นวรรคระหว่างคำมักถูกตัดเป็นชิ้นเล็ก ๆ:
- โปรดสรุปอีเมลของลูกค้า →
โปร | ด | ส | รุ | ป | อ | ี | เม | ล | ของ | ลูก | ค้า· 12
เปลี่ยนเป็นภาษาอังกฤษด้วยปุ่มเดียว
วิธีประหยัดที่ได้ผลที่สุดคือส่งพรอมต์เป็นภาษาอังกฤษ: ใช้โทเค็นน้อยกว่าภาษาไทยราว 43% โมเดลปัจจุบันเข้าใจคำสั่งภาษาอังกฤษได้ดีมาก และจะตอบเป็นภาษาไทยหากคุณขอ ในตัวนับโทเค็น TokenSave ให้วางพรอมต์แล้วกด 💸 ประหยัดโทเค็น: ระบบจะจัดช่องว่าง แปลเป็นภาษาอังกฤษ ตัดคำฟุ่มเฟือย และเติม "Reply in Thai." เพื่อให้คำตอบยังเป็นภาษาของคุณ ใช้ตัวแปลภาษาที่มีมาใน Chrome 138+ / Edge 148+ บนเดสก์ท็อป การแปลทำงานบนอุปกรณ์ของคุณเองและข้อความจะไม่ถูกอัปโหลด กด ↩ ต้นฉบับ เพื่อกลับไปใช้ต้นฉบับ
คิดเป็นเงิน
กับโมเดลราคา 2 ดอลลาร์ต่อ 1 ล้านโทเค็นขาเข้า การส่งพรอมต์นี้ 1 ล้านครั้งเป็นภาษาอังกฤษใช้ 68 ดอลลาร์ ภาษาไทยใช้ 118 ดอลลาร์ หากคำตอบเป็นภาษาไทยด้วย ตัวคูณเดียวกันจะมีผลกับโทเค็นขาออกซึ่งมักแพงกว่า 300–400%
วิธีประหยัด
- เขียน system prompt และคำสั่งที่ใช้ซ้ำเป็นภาษาอังกฤษ ให้เหลือภาษาไทยเฉพาะข้อความจากผู้ใช้
- ให้ขั้นตอนกลาง (จัดหมวดหมู่ ดึงข้อมูล เรียกเครื่องมือ) ตอบเป็นภาษาอังกฤษหรือ JSON และให้เฉพาะคำตอบสุดท้ายเป็นภาษาไทย
- ใช้ prompt caching กับส่วนของพรอมต์ที่คงที่
ข้อจำกัด
- วัดเพียงพรอมต์เดียว ข้อความอื่นอาจต่างได้ ±0.1–0.2
- Claude และ Gemini ใช้ tokenizer ต่างกัน ตัวเลขนี้ใช้กับโมเดลของ OpenAI เท่านั้น
- คำแปลมาจากการแปลด้วยเครื่องที่ตรวจทานแล้ว
ผลครบทั้ง 41 ภาษา (ภาษาอังกฤษ): เปรียบเทียบ 41 ภาษา
ดูทั้ง 41 ภาษาเทียบกันได้ในตารางภาษา
แหล่งที่มา
ลองวัดข้อความของคุณเอง: พรอมต์ภาษาไทยใช้โทเค็นและค่าใช้จ่ายมากกว่าภาษาอังกฤษเท่าไร
เปิดตัวนับโทเค็น →