 TokenSave
Svenska kostar 1,32× så många tokens som engelska i GPT
Jonhisking · 2026-10-01
Jag översatte samma kundtjänstprompt till 34 språk och räknade tokens med o200k_base, OpenAI:s nuvarande tokenizer (GPT-4o och senare). Engelska behöver 34 tokens, svenska 45 — 1,32× så många, plats 12 av 34 (1 = billigast).
Den svenska versionen:
Sammanfatta kundens e-post nedan i tre punkter och föreslå ett artigt svar. Kunden säger att beställningen kom två dagar för sent och att en vara saknades i lådan.
Resultat
| Språk | Tokens | Jämfört med engelska | Gamla GPT-4-tokenizern |
|---|---|---|---|
| English | 34 | 1,00× | 1,00× |
| 简体中文 | 35 | 1,03× | 1,53× |
| Español | 40 | 1,18× | 1,29× |
| Deutsch | 43 | 1,26× | 1,50× |
| Svenska | 45 | 1,32× | 1,50× |
| 한국어 | 49 | 1,44× | 2,50× |
| 日本語 | 61 | 1,79× | 2,21× |
| Čeština | 68 | 2,00× | 2,59× |
| Ελληνικά | 70 | 2,06× | 4,94× |
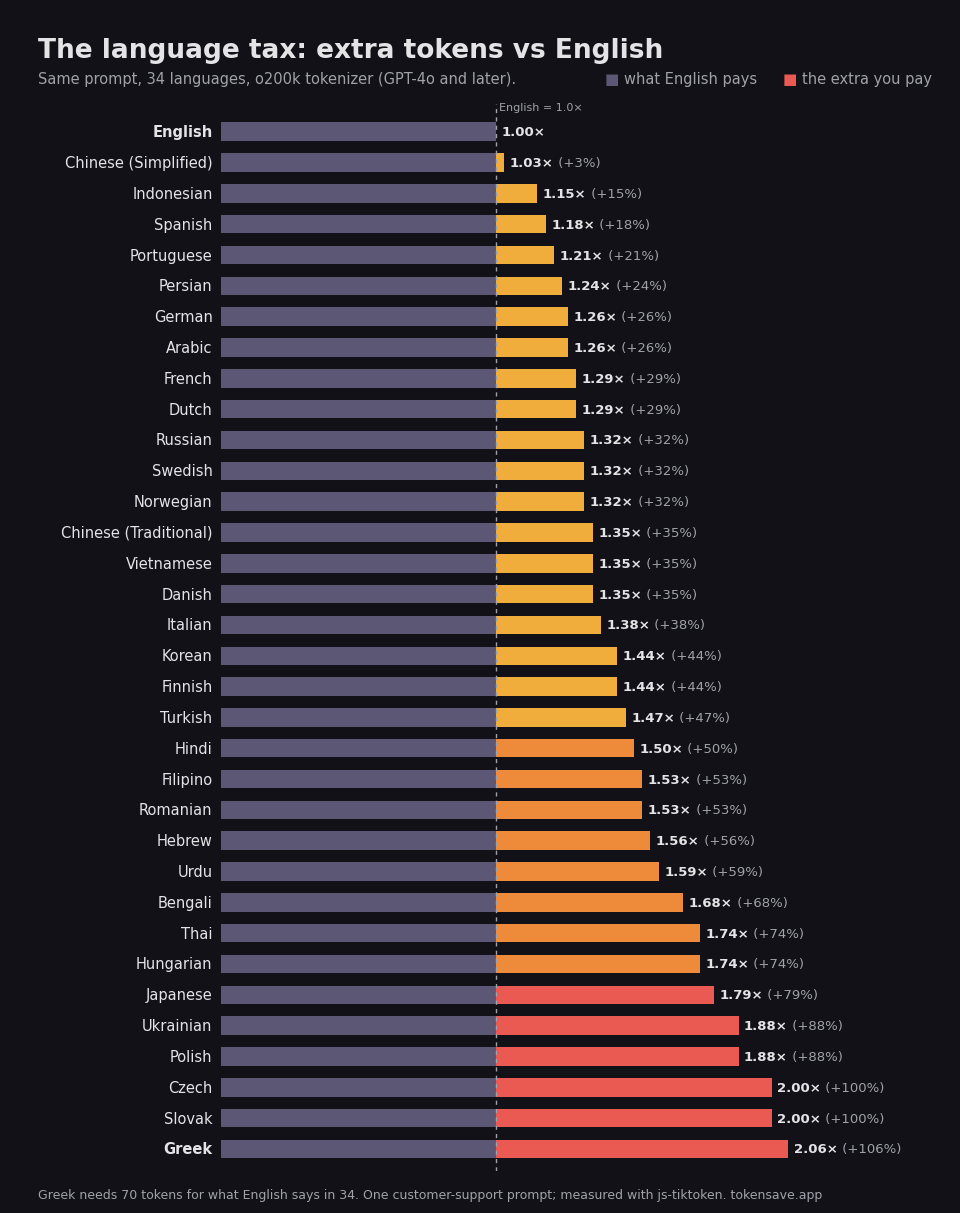
Varför
Tokenizern lär sig mest från engelsk text: ord som " polite" eller " customer" är en enda token, medan många svenska ord – särskilt sammansättningar – delas upp:
- Sammanfatta →
Sam | man | f | atta· 4 - beställningen →
best | äll | ningen· 3 - saknades →
sak | n | ades· 3
Jämfört med den gamla tokenizern
Med tokenizern från GPT-4-eran (cl100k) kostade samma prompt 1,50×, i dag 1,32×.
I pengar
Med en modell för 2 $ per miljon input-tokens kostar det 68 $ på engelska och 90 $ på svenska att skicka prompten en miljon gånger. Svarar modellen också på svenska gäller samma faktor för output-tokens, som oftast är 4–5× dyrare.
Så sparar du
- Skriv systemprompten och fasta instruktioner på engelska; låt bara användarens input vara på svenska.
- Be om mellansteg (klassificering, extraktion, verktygsanrop) på engelska eller som JSON, och bara slutsvaret på svenska.
- Använd prompt caching för den fasta delen av prompten.
Begränsningar
- En enda prompt mättes; för andra texter kan kvoten skilja ±0,1–0,2.
- Claude och Gemini har andra tokenizers – siffrorna gäller bara OpenAI-modeller.
- Översättningen bygger på en granskad maskinöversättning.
Alla resultat för 34 språk (på engelska): jämförelse av 34 språk
Mät din egen text: hur många tokens och hur mycket pengar din svenska prompt kostar jämfört med engelska.
Öppna tokenräknaren →