 TokenSave
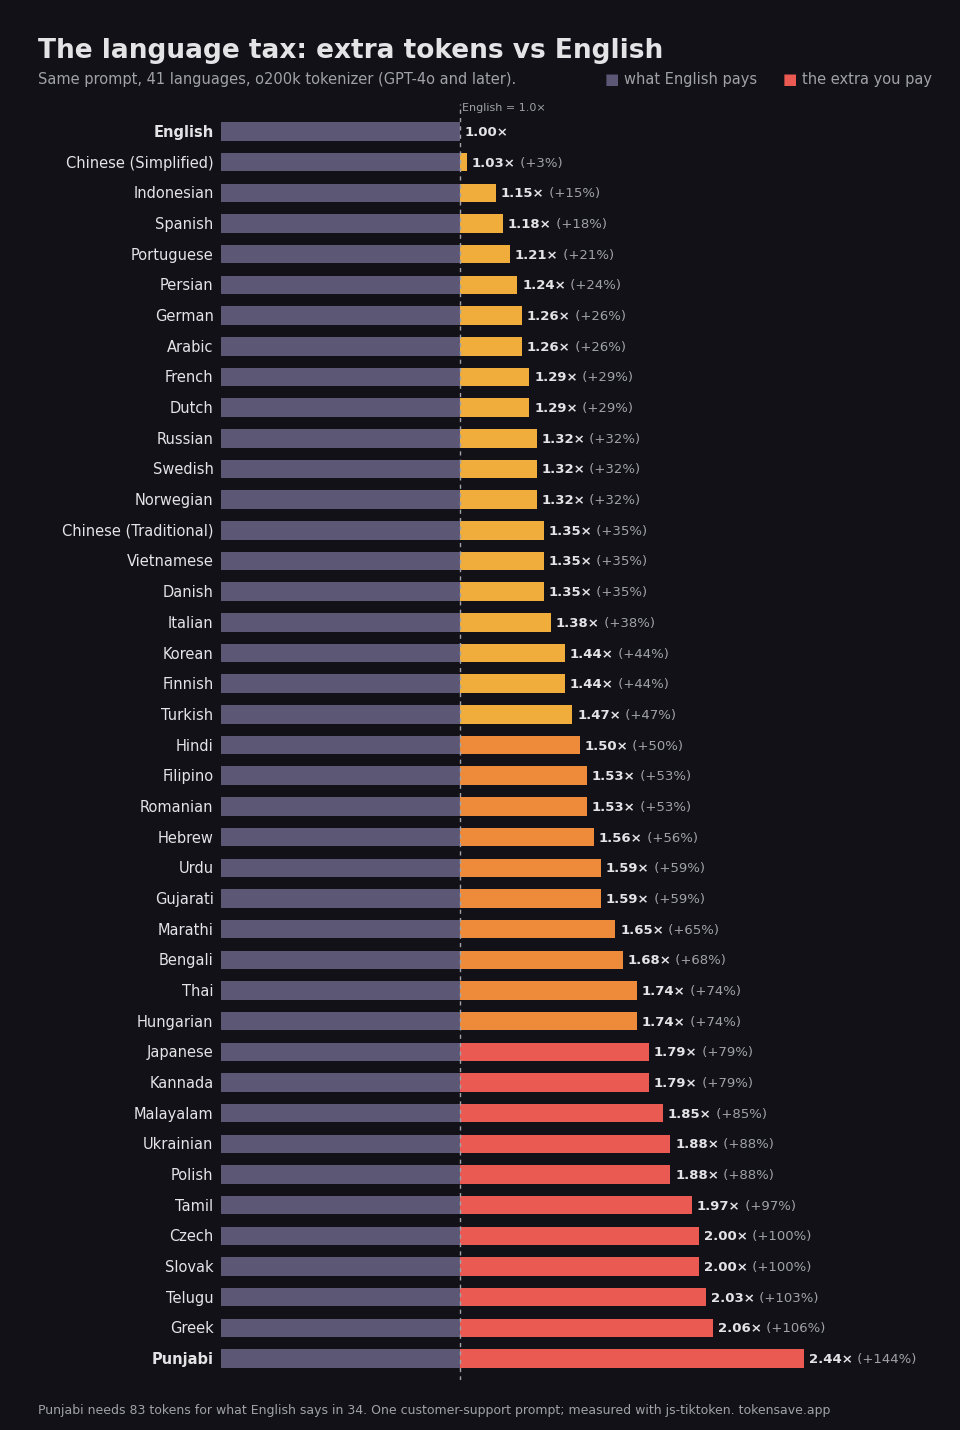
Româna folosește 1,53× tokenii englezei în GPT
Jonhisking · 2026-10-01
Am tradus același prompt de suport pentru clienți în 41 de limbi și am numărat tokenii cu o200k_base, tokenizatorul actual al OpenAI (GPT-4o și ulterioare). În engleză sunt 34 de tokeni; în română 52, adică 1,53× engleza, locul 23 din 41 (1 = cel mai ieftin).
Versiunea în română:
Rezumați e-mailul clientului de mai jos în trei puncte și propuneți un răspuns politicos. Clientul spune că comanda a sosit cu două zile întârziere și că un articol lipsea din cutie.
Rezultate
| Limbă | Tokeni | Față de engleză | Vechiul tokenizator GPT-4 |
|---|---|---|---|
| English | 34 | 1,00× | 1,00× |
| 简体中文 | 35 | 1,03× | 1,53× |
| Español | 40 | 1,18× | 1,29× |
| Deutsch | 43 | 1,26× | 1,50× |
| 한국어 | 49 | 1,44× | 2,50× |
| हिन्दी | 51 | 1,50× | 4,59× |
| Română | 52 | 1,53× | 1,76× |
| 日本語 | 61 | 1,79× | 2,21× |
| Čeština | 68 | 2,00× | 2,59× |
| Ελληνικά | 70 | 2,06× | 4,94× |
| ਪੰਜਾਬੀ | 83 | 2,44× | 7,41× |
De ce
Tokenizatorul învață mai ales din texte în engleză: cuvinte ca " polite" sau " customer" sunt un singur token, pe când multe cuvinte românești, cu diacritice și terminații, se sparg în bucăți:
- întârziere →
înt | âr | zi | ere· 4 - propuneți →
prop | une | ți· 3 - Rezumați →
Rez | uma | ți· 3
Față de vechiul tokenizator
Pe tokenizatorul din epoca GPT-4 (cl100k), același prompt costa 1,76×; azi costă 1,53×.
În bani
Cu un model de 2 $ per milion de tokeni de intrare, trimiterea acestui prompt de un milion de ori costă 68 $ în engleză și 104 $ în română. Dacă și răspunsul e în română, același multiplicator se aplică tokenilor de ieșire, care costă de obicei de 4–5 ori mai mult.
Cum economisești
- Scrie promptul de sistem și instrucțiunile fixe în engleză; lasă în română doar ce scrie utilizatorul.
- Cere pașii intermediari (clasificare, extragere, apeluri de unelte) în engleză sau JSON și doar răspunsul final în română.
- Folosește prompt caching pentru partea fixă a promptului.
Limitări
- Am măsurat un singur prompt; pentru alte texte raportul poate varia cu ±0,1–0,2.
- Claude și Gemini folosesc alți tokenizatori — cifrele sunt valabile doar pentru modelele OpenAI.
- Traducerea pornește de la o traducere automată verificată.
Rezultatele complete pentru 41 de limbi (în engleză): comparație între 41 de limbi
Măsoară-ți propriul text: câți tokeni și câți bani costă promptul tău în română față de engleză.
Deschide numărătorul de tokeni →