 TokenSave
Polski w GPT zużywa o 88% więcej tokenów niż angielski
Jonhisking · 30.09.2026
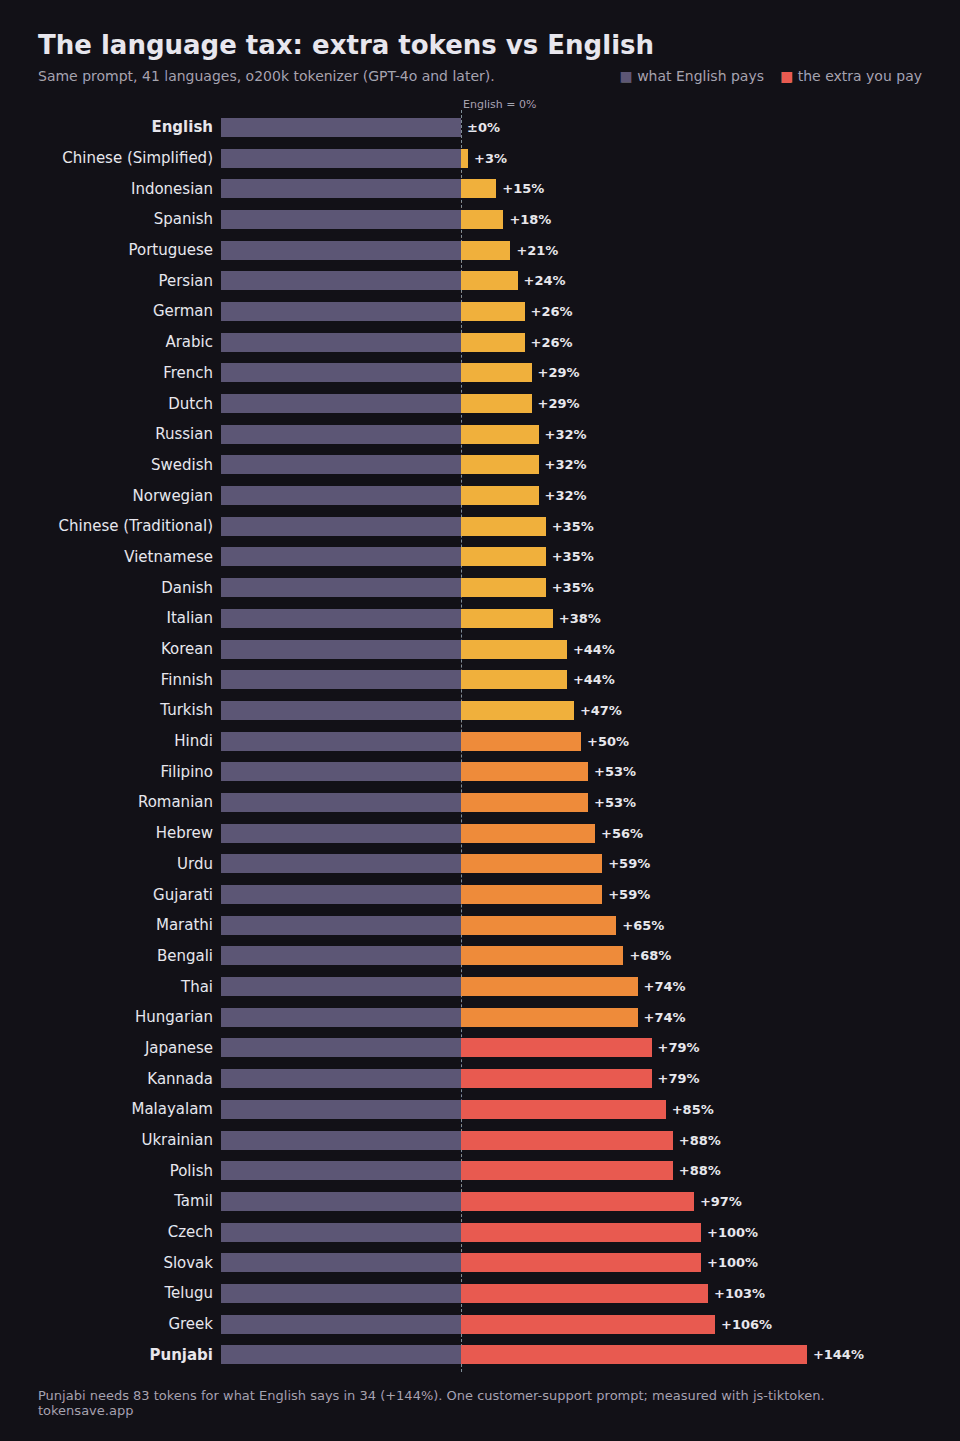
Przetłumaczyłem jeden zwykły prompt na 41 języków i policzyłem tokeny tokenizerem, którego używają obecne modele OpenAI (o200k_base, GPT-4o i nowsze). Spodziewałem się, że najdrożej wyjdą japoński albo tajski. Tymczasem na samym końcu znalazły się języki europejskie: polski (razem z ukraińskim) zużywa o 88% więcej tokenów niż angielski, a z Europy drożej wypadają tylko czeski i słowacki (o 100% więcej) oraz grecki (o 106% więcej). Najdroższy w całym zestawieniu okazał się pendżabski (o 144% więcej).
Prompt (po angielsku 34 tokeny):
Podsumuj poniższy e-mail od klienta w trzech punktach i zaproponuj uprzejmą odpowiedź. Klient twierdzi, że zamówienie dotarło z dwudniowym opóźnieniem, a w paczce brakowało jednego produktu.
Wyniki: tokeny według języka
| Język | Tokeny | Więcej niż po angielsku | Oszczędność przy wysłaniu po angielsku |
|---|---|---|---|
| Angielski | 34 | – | – |
| Chiński (uproszczony) | 35 | +3% | 3% |
| Niemiecki | 43 | +26% | 21% |
| Rosyjski | 45 | +32% | 24% |
| Koreański | 49 | +44% | 31% |
| Japoński | 61 | +79% | 44% |
| Polski | 64 | +88% | 47% |
| Ukraiński | 64 | +88% | 47% |
| Czeski | 68 | +100% | 50% |
| Słowacki | 68 | +100% | 50% |
| Grecki | 70 | +106% | 51% |
| Pendżabski | 83 | +144% | 59% |
Dlaczego?
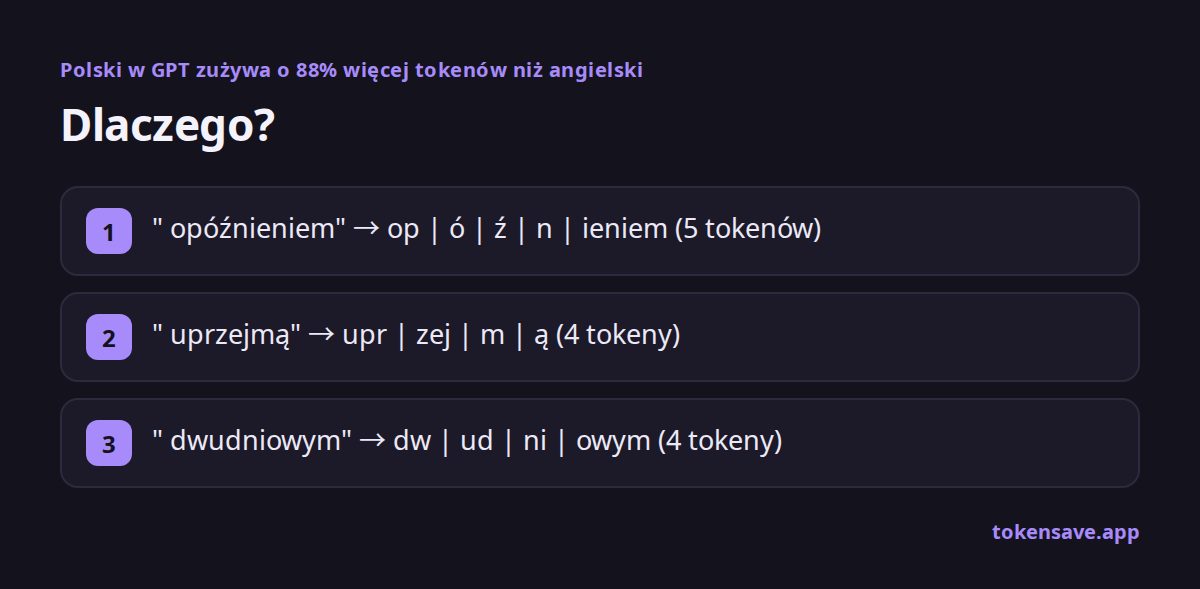
Tokenizer zna całe angielskie słowa (" polite", " customer" = 1 token), a polskie skleja z kawałków. Odmiana przez przypadki i znaki diakrytyczne robią swoje:
- " opóźnieniem" →
op | ó | ź | n | ieniem(5 tokenów) - " uprzejmą" →
upr | zej | m | ą(4 tokeny) - " dwudniowym" →
dw | ud | ni | owym(4 tokeny)
Przejdź na angielski jednym przyciskiem
Największą oszczędność daje wysyłanie promptu po angielsku: dla języka polskiego to około 47% mniej tokenów. Obecne modele świetnie rozumieją instrukcje po angielsku i odpowiadają po polsku, jeśli o to poprosisz. W liczniku tokenów TokenSave wklej prompt i naciśnij 💸 Oszczędź tokeny: usuwa zbędne spacje, tłumaczy na angielski, wycina „lanie wody” i dodaje „Reply in Polish.”, żeby odpowiedź pozostała w Twoim języku. Korzysta z tłumacza wbudowanego w Chrome 138+ / Edge 148+ na komputerze; tłumaczenie odbywa się na Twoim urządzeniu, a tekst nigdy nie jest przesyłany. Naciśnij ↩ Oryginał, aby przywrócić oryginał.
W pieniądzach
model za 2 $ / 1M tokenów wejściowych, prompt wysłany milion razy: angielski 68 $, polski 128 $. I to tylko wejście. Jeśli model odpowiada po polsku, ta sama różnica dotyczy tokenów wyjściowych, które zwykle są o 300–400% droższe.
Co z tym zrobić
- Prompt systemowy i stałe instrukcje pisać po angielsku, po polsku tylko dane od użytkownika.
- Kroki pośrednie (klasyfikacja, ekstrakcja, wywołania narzędzi) zwracać po angielsku albo w JSON, po polsku tylko finalną odpowiedź.
- Korzystać z prompt caching dla stałej części promptu.
Ograniczenia: to jeden prompt, dla innych tekstów wynik może się różnić o ±0,1–0,2. Claude i Gemini mają inne tokenizery, liczby dotyczą tylko modeli OpenAI. Tłumaczenie jest maszynowe, jeśli coś brzmi nienaturalnie, dajcie znać, zmierzę ponownie.
Pełne wyniki dla 41 języków (po angielsku): porównanie 41 języków
Wszystkie 41 języków obok siebie znajdziesz w tabeli języków.
Ile to kosztuje w praktyce i jak płacić mniej: Ile naprawdę kosztuje prompt po polsku?
Źródła
Więcej artykułów
- Claude Opus 5.5: test poziomów effort od low do max
- Vibe coding gra: zrobiłem grę z AI w 3 dni za 45 USD
- Testy zamknięte Google Play: 12 testerów, 14 dni i 14 błędów
- Popularne gry Roblox: najpopularniejsze gry Roblox 2026
- Najtańsze API AI 2026: cennik API i koszt 1 mln tokenów
Sprawdź własny tekst: ile tokenów i pieniędzy kosztuje twój prompt po polsku w porównaniu z angielskim.
Otwórz licznik tokenów →