 TokenSave
Norsk bruker 1,32× så mange tokens som engelsk i GPT
Jonhisking · 2026-10-01
Jeg oversatte den samme kundeserviceprompten til 41 språk og talte tokens med o200k_base, OpenAIs nåværende tokenizer (GPT-4o og nyere). Engelsk trenger 34 tokens, norsk 45 – altså 1,32× så mange, plass 13 av 41 (1 = billigst).
Den norske versjonen:
Oppsummer kundens e-post nedenfor i tre punkter, og foreslå et høflig svar. Kunden sier at bestillingen kom to dager for sent, og at det manglet en vare i esken.
Resultater
| Språk | Tokens | Sammenlignet med engelsk | Gammel GPT-4-tokenizer |
|---|---|---|---|
| English | 34 | 1,00× | 1,00× |
| 简体中文 | 35 | 1,03× | 1,53× |
| Español | 40 | 1,18× | 1,29× |
| Deutsch | 43 | 1,26× | 1,50× |
| Norsk | 45 | 1,32× | 1,56× |
| 한국어 | 49 | 1,44× | 2,50× |
| हिन्दी | 51 | 1,50× | 4,59× |
| 日本語 | 61 | 1,79× | 2,21× |
| Čeština | 68 | 2,00× | 2,59× |
| Ελληνικά | 70 | 2,06× | 4,94× |
| ਪੰਜਾਬੀ | 83 | 2,44× | 7,41× |
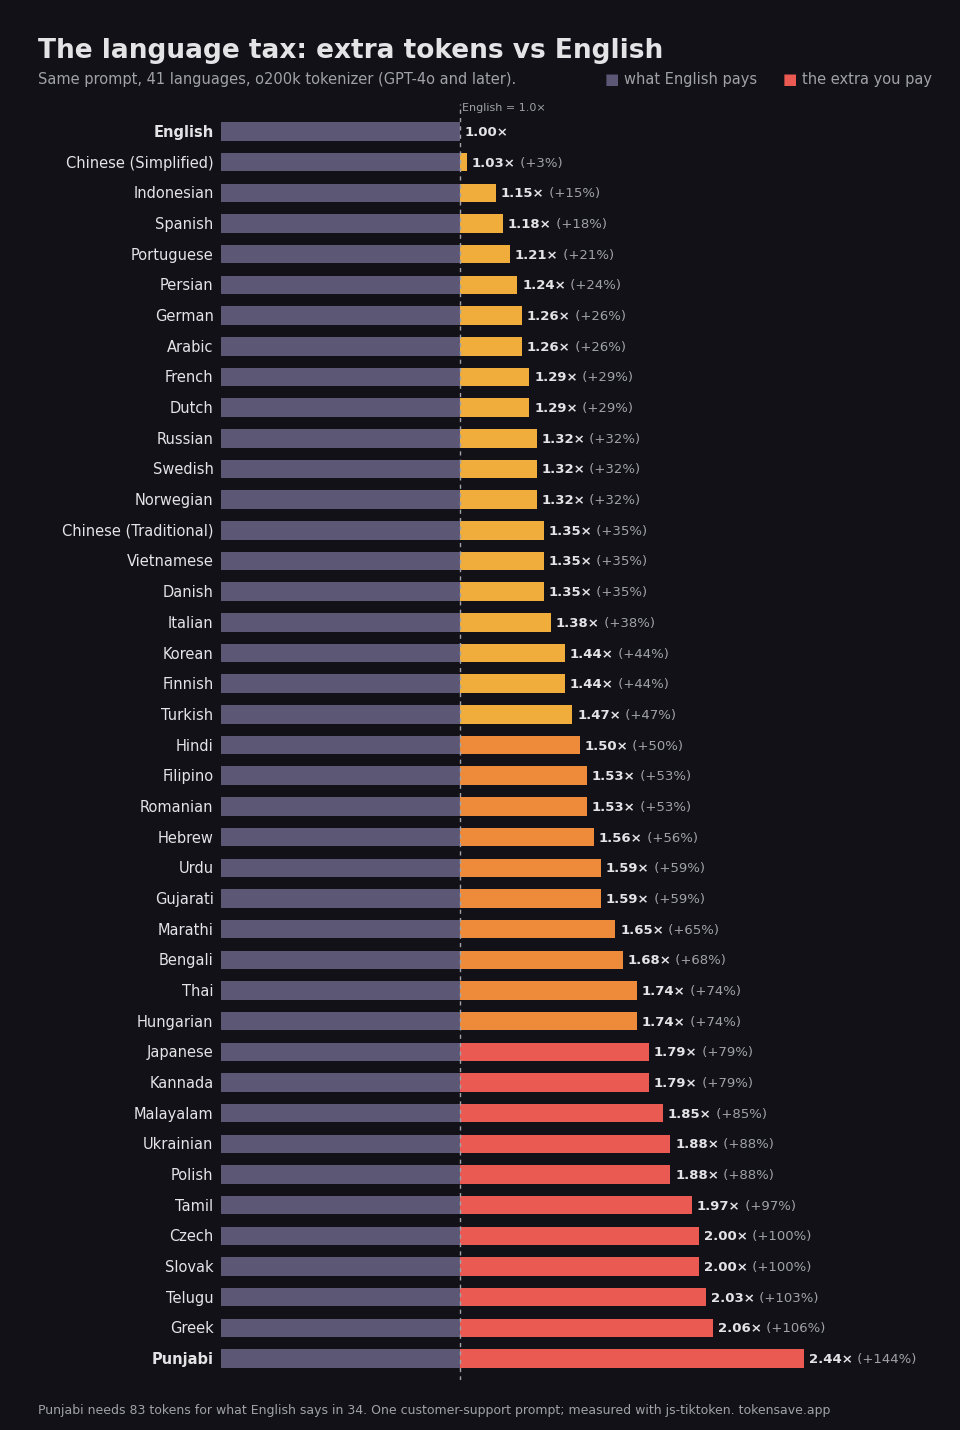
Hvorfor
Tokenizeren lærer mest av engelsk tekst: ord som " polite" eller " customer" er ett token, mens mange norske ord – særlig sammensatte ord – deles opp:
- bestillingen →
best | ill | ingen· 3 - høflig →
hø | fl | ig· 3 - Oppsummer →
Opp | summer· 2
Sammenlignet med den gamle tokenizeren
Med tokenizeren fra GPT-4-tiden (cl100k) kostet den samme prompten 1,56×, i dag 1,32×.
I penger
Med en modell til 2 $ per million input-tokens koster det 68 $ på engelsk og 90 $ på norsk å sende prompten én million ganger. Svarer modellen også på norsk, gjelder den samme faktoren for output-tokens, som vanligvis er 4–5× dyrere.
Slik sparer du
- Skriv systemprompten og faste instruksjoner på engelsk; la bare brukerens input være på norsk.
- Be om mellomsteg (klassifisering, uttrekk, verktøykall) på engelsk eller som JSON, og bare det endelige svaret på norsk.
- Bruk prompt caching for den faste delen av prompten.
Begrensninger
- Én prompt er målt; for andre tekster kan forholdet variere ±0,1–0,2.
- Claude og Gemini bruker andre tokenizere – tallene gjelder bare OpenAI-modeller.
- Oversettelsen bygger på en gjennomgått maskinoversettelse.
Alle resultater for 41 språk (på engelsk): sammenligning av 41 språk
Mål din egen tekst: hvor mange tokens og hvor mye penger den norske prompten din koster sammenlignet med engelsk.
Åpne tokentelleren →