 TokenSave
Bahasa Indonesia memakai 1,15× token bahasa Inggris di GPT
Jonhisking · 2026-10-01
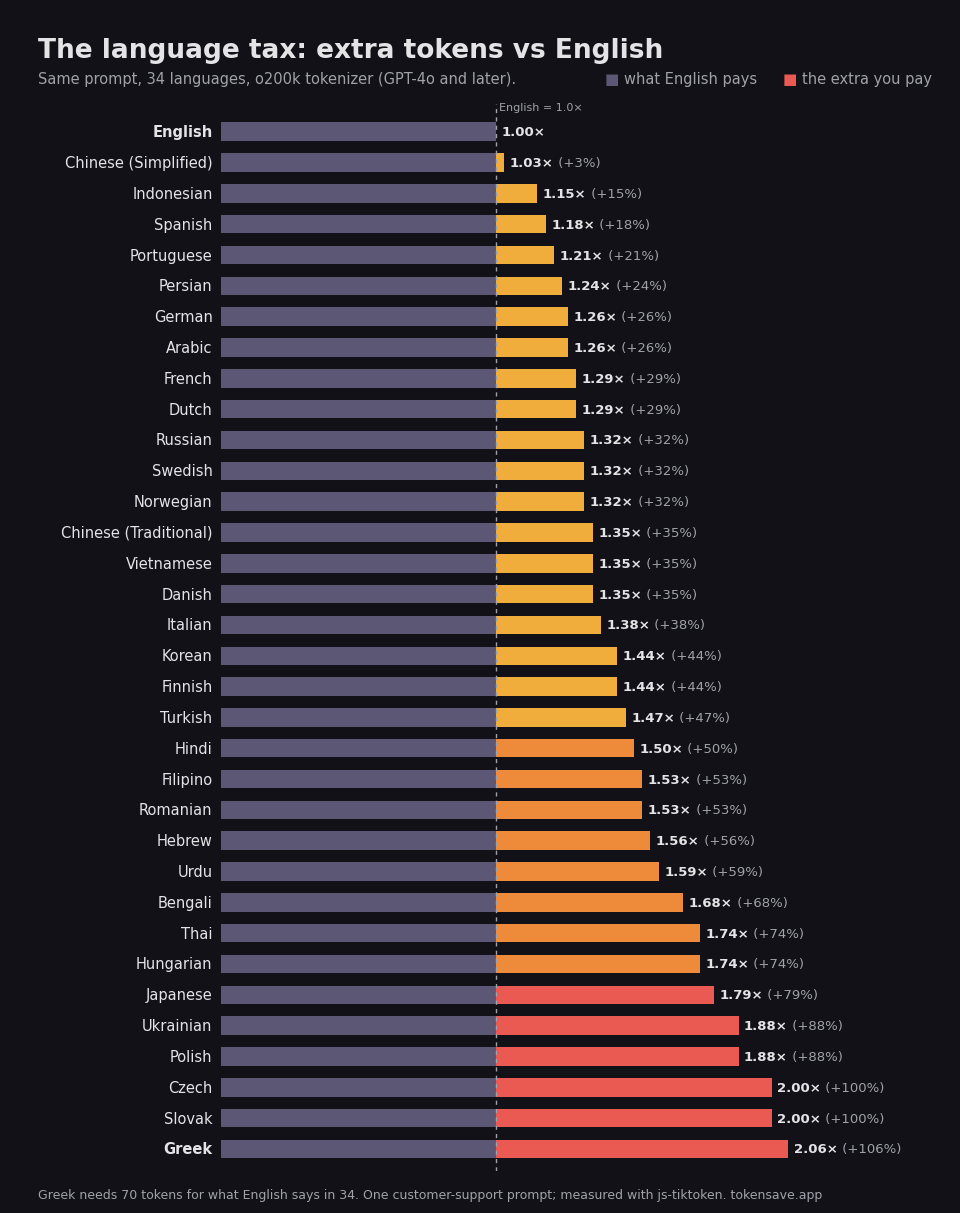
Saya menerjemahkan prompt layanan pelanggan yang sama ke 34 bahasa dan menghitung token dengan o200k_base, tokenizer OpenAI saat ini (GPT-4o dan setelahnya). Bahasa Inggris butuh 34 token, bahasa Indonesia 39 token — 1,15× bahasa Inggris, peringkat 3 dari 34 (1 = paling murah).
Versi bahasa Indonesia:
Ringkas email pelanggan di bawah ini dalam tiga poin dan sarankan balasan yang sopan. Pelanggan mengatakan pesanan tiba dua hari terlambat dan satu barang hilang dari kotak.
Hasil
| Bahasa | Token | Dibanding bahasa Inggris | Tokenizer GPT-4 lama |
|---|---|---|---|
| English | 34 | 1,00× | 1,00× |
| 简体中文 | 35 | 1,03× | 1,53× |
| Bahasa Indonesia | 39 | 1,15× | 1,38× |
| Español | 40 | 1,18× | 1,29× |
| Deutsch | 43 | 1,26× | 1,50× |
| 한국어 | 49 | 1,44× | 2,50× |
| 日本語 | 61 | 1,79× | 2,21× |
| Čeština | 68 | 2,00× | 2,59× |
| Ελληνικά | 70 | 2,06× | 4,94× |
Mengapa
Tokenizer terutama belajar dari teks bahasa Inggris: kata seperti " polite" atau " customer" hanya satu token, sedangkan kata berimbuhan dalam bahasa Indonesia dipecah:
- terlambat →
terl | amb | at· 3 - Pelanggan →
Pel | anggan· 2 - sarankan →
sar | ankan· 2
Dibanding tokenizer lama
Di tokenizer era GPT-4 (cl100k), prompt yang sama 1,38×; sekarang 1,15×. Bahasa Indonesia termasuk yang paling hemat setelah bahasa Inggris dan Mandarin.
Dalam uang
Dengan model seharga $2 per 1 juta token input, mengirim prompt ini 1 juta kali menghabiskan $68 dalam bahasa Inggris dan $78 dalam bahasa Indonesia. Jika jawabannya juga berbahasa Indonesia, pengali yang sama berlaku untuk token output yang biasanya 4–5× lebih mahal.
Cara berhemat
- Tulis system prompt dan instruksi tetap dalam bahasa Inggris; biarkan hanya input pengguna dalam bahasa Indonesia.
- Minta langkah perantara (klasifikasi, ekstraksi, pemanggilan tool) dalam bahasa Inggris atau JSON, dan hanya jawaban akhir dalam bahasa Indonesia.
- Gunakan prompt caching untuk bagian prompt yang tetap.
Batasan
- Hanya satu prompt yang diukur; pada teks lain rasionya bisa berbeda ±0,1–0,2.
- Claude dan Gemini memakai tokenizer lain; angka ini hanya berlaku untuk model OpenAI.
- Terjemahan didasarkan pada terjemahan mesin yang sudah diperiksa.
Hasil lengkap 34 bahasa (dalam bahasa Inggris): perbandingan 34 bahasa
Ukur teks Anda sendiri: berapa token dan biaya prompt bahasa Indonesia Anda dibanding bahasa Inggris.
Buka penghitung token →