 TokenSave
Gumagamit ang Filipino ng 1.53× na token kumpara sa English sa GPT
Jonhisking · 2026-10-01
Isinalin ko ang parehong customer-support prompt sa 34 wika at binilang ang token gamit ang o200k_base, ang kasalukuyang tokenizer ng OpenAI (GPT-4o at mas bago). Sa English, 34 token; sa Filipino, 52 token — 1.53× ng English, ika-22 sa 34 (1 = pinakamura).
Ang bersyong Filipino:
Ibuod ang email ng customer sa ibaba sa tatlong punto at magmungkahi ng magalang na sagot. Sinabi ng customer na dumating ang order nang dalawang araw na huli at may isang item na kulang sa kahon.
Mga resulta
| Wika | Token | Kumpara sa English | Lumang GPT-4 tokenizer |
|---|---|---|---|
| English | 34 | 1.00× | 1.00× |
| 简体中文 | 35 | 1.03× | 1.53× |
| Español | 40 | 1.18× | 1.29× |
| Deutsch | 43 | 1.26× | 1.50× |
| 한국어 | 49 | 1.44× | 2.50× |
| Filipino | 52 | 1.53× | 1.76× |
| 日本語 | 61 | 1.79× | 2.21× |
| Čeština | 68 | 2.00× | 2.59× |
| Ελληνικά | 70 | 2.06× | 4.94× |
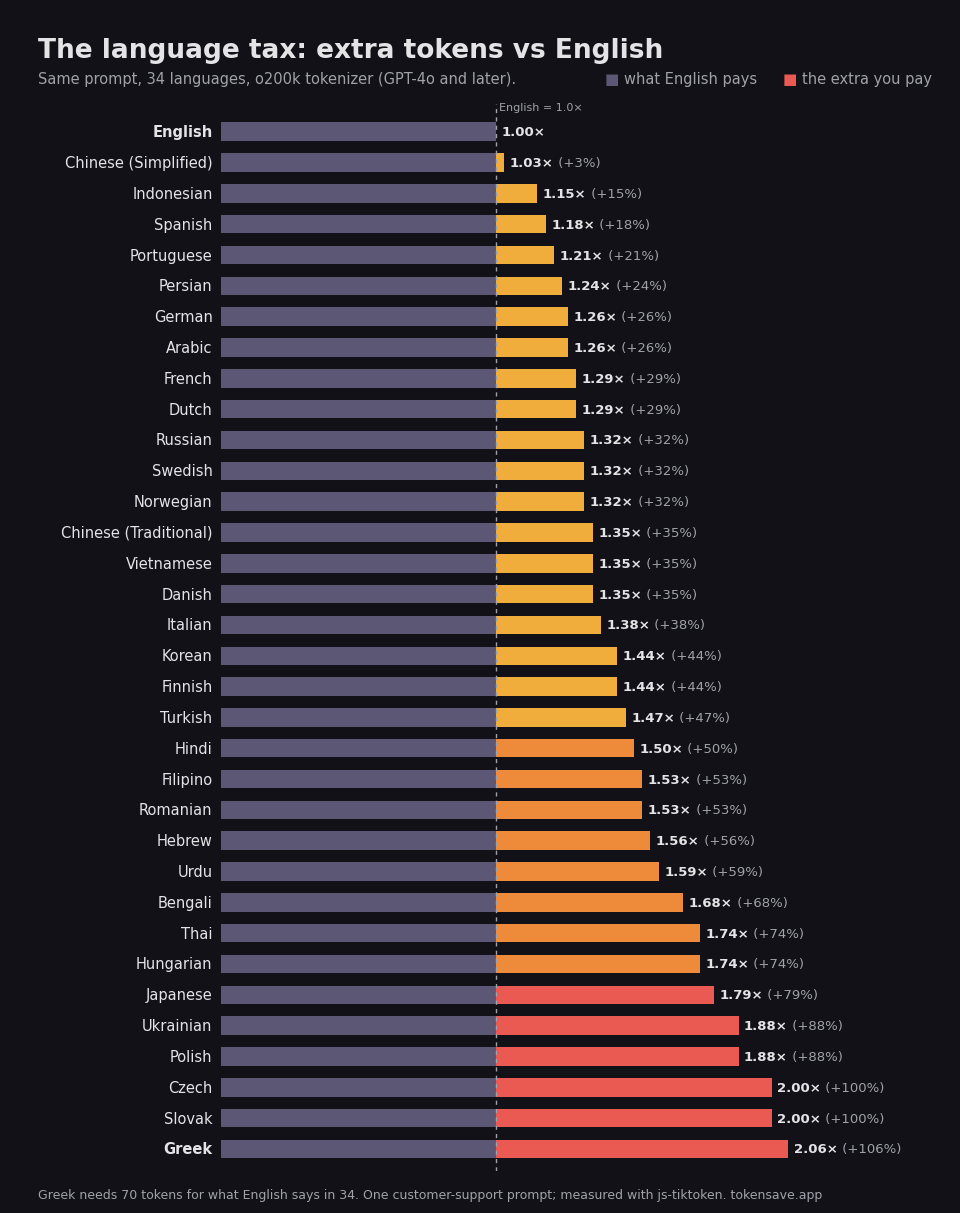
Bakit
Karamihang natututo ang tokenizer mula sa English na text: isang token lang ang mga salitang tulad ng " polite" o " customer", pero hinahati-hati ang maraming salitang Filipino na may panlapi:
- magmungkahi →
mag | m | ungk | ahi· 4 - Ibuod →
I | bu | od· 3 - magalang →
mag | alang· 2
Kumpara sa lumang tokenizer
Sa tokenizer ng panahon ng GPT-4 (cl100k), 1.76× ang parehong prompt; ngayon 1.53×.
Sa pera
Sa model na $2 bawat 1 milyong input token, ang pagpapadala ng prompt na ito nang 1 milyong beses ay $68 sa English at $104 sa Filipino. Kung Filipino rin ang sagot, parehong multiplier ang tatama sa output token, na kadalasang 4–5× na mas mahal.
Paano makatipid
- Isulat sa English ang system prompt at mga nakapirming tagubilin; Filipino lang ang input ng user.
- Hilingin sa English o JSON ang mga pansamantalang hakbang (classification, extraction, tool call), at Filipino lang ang huling sagot.
- Gumamit ng prompt caching para sa nakapirming bahagi ng prompt.
Mga limitasyon
- Isang prompt lang ang sinukat; sa ibang text, maaaring mag-iba ang ratio ng ±0.1–0.2.
- Iba ang tokenizer ng Claude at Gemini; para lang sa mga OpenAI model ang mga numerong ito.
- Batay ang salin sa sinuring machine translation.
Buong resulta ng 34 wika (sa English): paghahambing ng 34 wika
Sukatin ang sarili mong text: ilang token at magkano ang prompt mo sa Filipino kumpara sa English.
Buksan ang token counter →