 TokenSave
Čeština v GPT stojí o 100 % víc tokenů než angličtina
Jonhisking · 30. 9. 2026
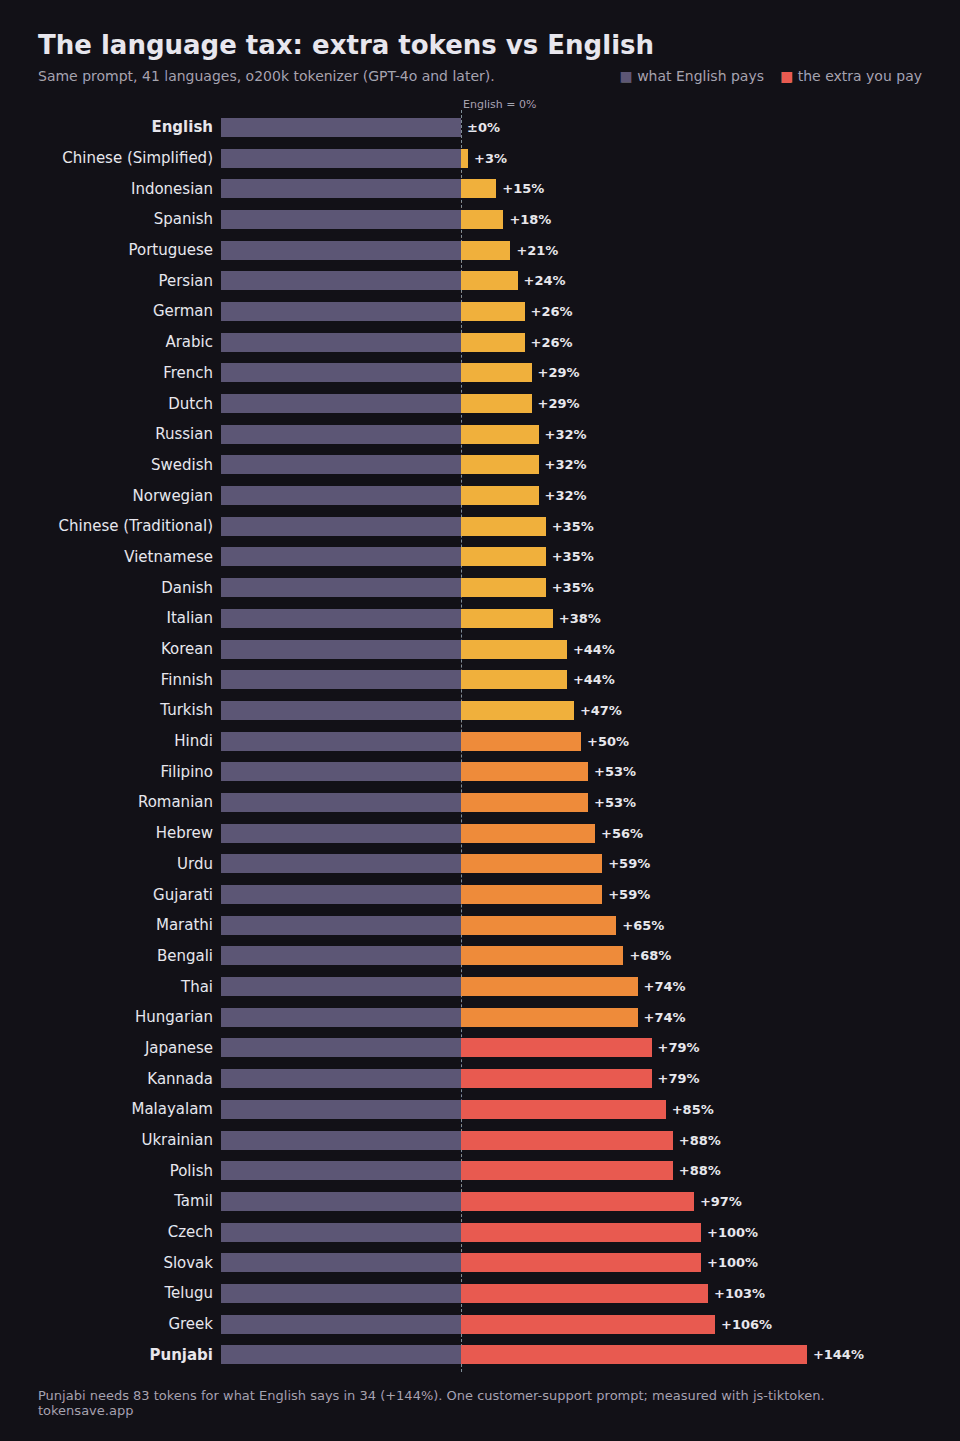
Přeložil jsem jeden běžný prompt do 41 jazyků a spočítal tokeny tokenizérem, který používají současné modely OpenAI (o200k_base, GPT-4o a novější). Čekal jsem, že nejhůř dopadne japonština nebo thajština. Obě ale vyšly levněji než čeština (+100%): z Evropy je dražší jen řečtina (+106%), stejně jako čeština vychází slovenština, a z celého srovnání už jen indická telugština (+103%) a pandžábština (+144%).
Prompt (anglicky 34 tokenů):
Shrňte níže uvedený e-mail zákazníka do tří bodů a navrhněte zdvořilou odpověď. Zákazník píše, že objednávka dorazila se dvoudenním zpožděním a v krabici chyběla jedna položka.
Výsledky: tokeny podle jazyka
| Jazyk | Tokeny | Oproti angličtině | Úspora při odeslání v angličtině |
|---|---|---|---|
| Angličtina | 34 | ±0% | – |
| Čínština (zjednodušená) | 35 | +3% | 3% |
| Němčina | 43 | +26% | 21% |
| Ruština | 45 | +32% | 24% |
| Korejština | 49 | +44% | 31% |
| Japonština | 61 | +79% | 44% |
| Polština | 64 | +88% | 47% |
| Ukrajinština | 64 | +88% | 47% |
| Čeština | 68 | +100% | 50% |
| Slovenština | 68 | +100% | 50% |
| Telugština | 69 | +103% | 51% |
| Řečtina | 70 | +106% | 51% |
| Pandžábština | 83 | +144% | 59% |
Proč?
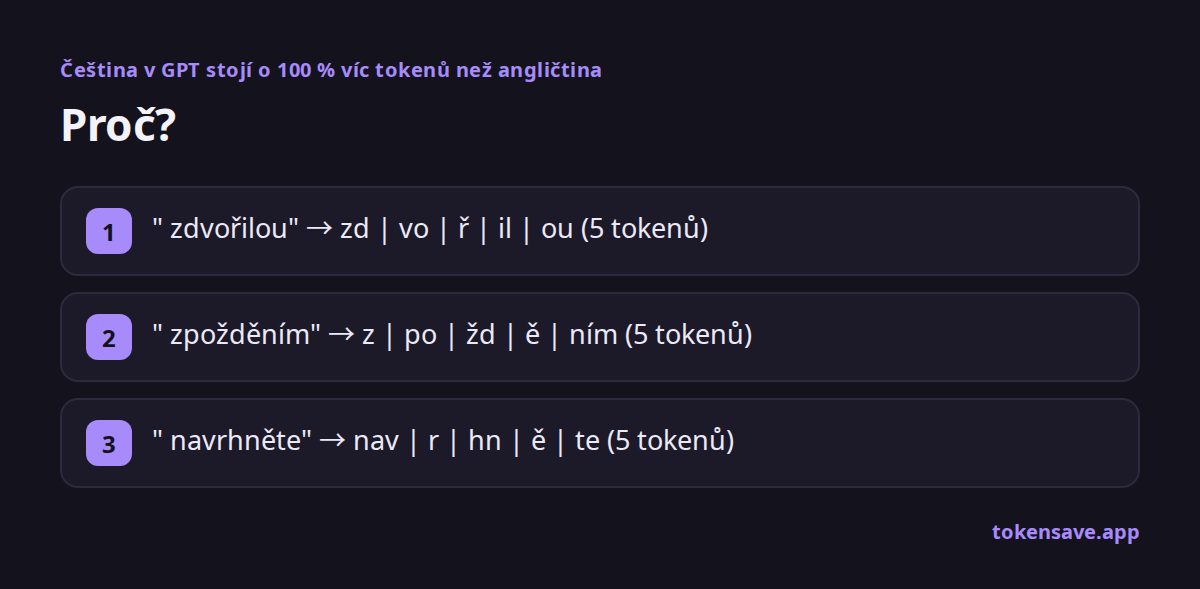
Tokenizér zná celá anglická slova (" polite", " customer" = 1 token), ale česká slova skládá z kousků. Háčky a čárky často tvoří samostatný token:
- " zdvořilou" →
zd | vo | ř | il | ou(5 tokenů) - " zpožděním" →
z | po | žd | ě | ním(5 tokenů) - " navrhněte" →
nav | r | hn | ě | te(5 tokenů)
Zajímavost: stejný text bez diakritiky má 60 tokenů místo 68 (o 12 % méně). Nedoporučuju to jako trik, kvalita odpovědí může utrpět, ale ukazuje to, kolik stojí háčky a čárky.
Přepněte do angličtiny jedním tlačítkem
Největší úspora je poslat prompt v angličtině: pro češtinu asi o 50% méně tokenů. Současné modely anglickým instrukcím perfektně rozumí a odpoví česky, když je o to požádáte. V počítadle tokenů TokenSave vložte prompt a stiskněte 💸 Ušetřit tokeny: odstraní nadbytečné mezery, přeloží text do angličtiny, vypustí výplňová slova a přidá „Reply in Czech.“, aby odpověď zůstala ve vašem jazyce. Využívá překladač vestavěný v Chrome 138+ / Edge 148+ na počítači; překlad probíhá ve vašem zařízení a text se nikam neodesílá. Stiskem ↩ Originál vrátíte původní text.
V penězích
model za 2 $ / 1M vstupních tokenů, prompt poslaný milionkrát: angličtina 68 $, čeština 136 $. A to jen vstup. Pokud model odpovídá česky, stejný rozdíl platí i pro výstupní tokeny, které bývají o 300–400% dražší.
Co s tím
- Systémový prompt a pevné instrukce psát anglicky, česky jen vstup od uživatele.
- Mezikroky (klasifikace, extrakce, tool calls) nechat vracet anglicky nebo v JSON, česky jen finální odpověď.
- Využít prompt caching pro pevnou část promptu.
Omezení: je to jeden prompt, u jiných textů se poměr může lišit o ±0,1–0,2. Claude a Gemini mají jiné tokenizéry, čísla platí jen pro modely OpenAI. Překlad je strojový, pokud v něm najdete chybu, přeměřím to.
Vyzkoušejte vlastní text v počítadle tokenů; všechny jazyky vedle sebe najdete v tabulce jazyků.
Celé výsledky všech 41 jazyků (anglicky): srovnání 41 jazyků
Zdroje
Změřte si vlastní text: kolik tokenů a peněz stojí váš prompt v češtině oproti angličtině.
Otevřít počítadlo tokenů →